
拒绝玄学评分:从 jev-seo 看现代 SEO 与 GEO 审计的硬规则引擎与概率语义决策
在生成式 AI 与大语言模型席卷搜索生态的今天,市面上涌现了大量打着“AI 驱动”旗号的站点审计工具。然而,绝大多数同类工具在工程实践中往往暴露出致命弊端:把整站 HTML 简单粗暴地塞给通用大模型,随后生成数千字充满“虚幻自信”的玄学建议——凭空捏造未经验证的跳出率预测、把主观行文偏好包装成 Google 官方惩罚,甚至对爬虫协议与渲染边界一无所知。
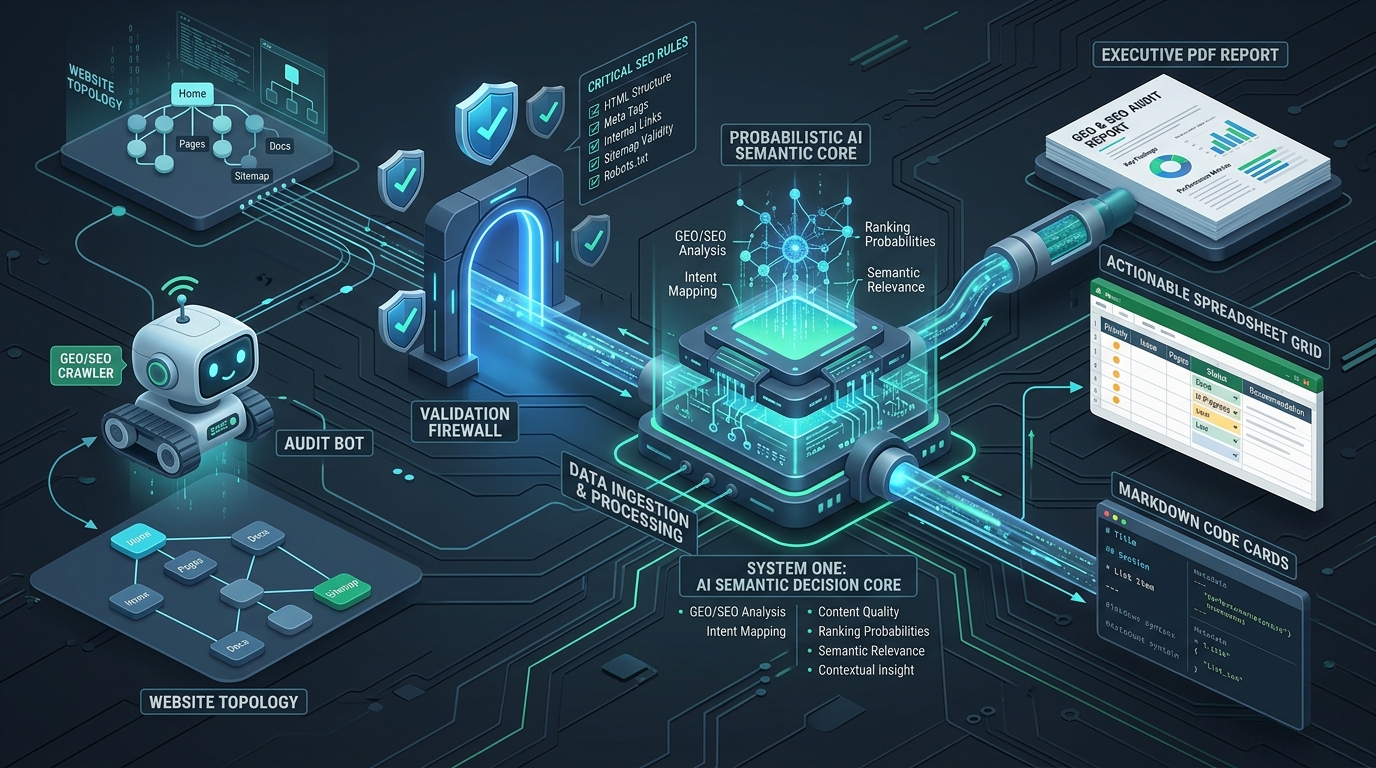
由开发者 Daniel Agrici 开源的 jev-seo,为现代搜索引擎优化(SEO)与生成式引擎优化(GEO)审计树立了一个兼具工程严谨性与低成本语义理解的新标杆。该项目没有盲目依赖开放式文本生成,而是将抓取防御、52 项确定性硬规则、TypeSafe Jev 的 System One 概率语义决策,以及反向锁死 AI 幻觉的“叙述契约(Narrative Contract)”熔铸为一体,实现了一个证据优先、无伪造排名、单次审计成本低至 0.01 美元的现代化自动化审计管线。
1. 为什么“通用大模型做 SEO 审计”常常沦为灾难?
传统 SEO 审计工具(如 Screaming Frog、Ahrefs、Semrush)擅长排查抓取链路、状态码、死链与外链拓扑,但面对“内容是否真正回答了用户意图”、“H1 之后的开篇是否能被 AI 搜索引擎直接引用”、“正文是独家一手经验还是千篇一律的营销空话”等深层语义维度时,往往无能为力。
为了补齐语义短板,许多团队开始尝试将大语言模型引入审计流程。但在实际落地中,纯大模型方案通常会踩中以下四大工程陷阱:
- 虚假自信与伪造因果(Hallucinated Causality):大模型倾向于扮演“排名预言家”,动辄宣称“修改此 Meta 描述可让关键词排名前进 5 位”、“页面文字不足导致权重下降 30%”。这种把相关性当因果律、伪造排名的做法,直接违背了搜索引擎技术规范。
- 缺乏网络边界与安全性防护:让未经防护的爬虫脚本跟随全网重定向,极易遭受 DNS 重绑定(DNS Rebinding)与服务端请求伪造(SSRF)攻击;而抓取到带有恶意指令的网页时,还可能引发针对审计 Agent 的 Prompt Injection(提示词注入)。
- 主观建议与官方规范混淆:把字数下限、标题字符区间等民间经验(Heuristics),与
robots.txt全站封锁、Canonical 循环指向等致命技术故障混为一谈,严重干扰工程团队的修复优先级。 - 输出形式脱节:生成一堆冗长且无法版本控制的 Markdown 文本或泛泛而谈的 PDF,无法让开发团队直接拆解为结构化、带状态跟踪的协作任务。
jev-seo 的设计哲学正是为了终结这种乱象。它确立了六大核心准则:证据压倒修饰(Evidence over polish)、严禁伪造排名预测、Jev 仅作为证据裁判而非事实来源、启发式指标必须显式标记、抓取内容仅作为数据而非指令,以及全量成本硬顶预算控制。
2. 系统全景架构:端到端分层处理流水线
jev-seo 采用清晰的分层解耦设计,整套系统从单个站点首页 URL 出发,经过多级处理,最终收敛至单一强类型视图模型,并分发为三种完全对齐的交付物。
flowchart TD
    A["起始站点 URL (Homepage)"] --> B["Stage 1: 礼貌网络爬虫 (crawl.py)\n- BFS 深度遍历 (上限60页/深度5)\n- robots.txt & Crawl-delay 遵循\n- SSRF 过滤与逐跳重定向安全检查\n- 软404探测 / llms.txt / 无头渲染兜底"]

    B --> C["Stage 2: 52项确定性硬规则排查 (checks.py)\n- 抓取与索引 (Canonical, 状态码, 链条)\n- On-page 元数据与层级\n- 结构化数据 (JSON-LD Rich Results 校验)\n- 基础安全 (HTTPS, HSTS, 混合内容)"]

    B --> D["Stage 3: TypeSafe Jev 语义决策 (jev.py)\n- 独立问题合并单次请求批处理\n- Choice: 页面类型(11类) & 搜索意图(6类)\n- Noul: 答案前置 & 实体清晰度\n- Score: 权威度, 可引用性, 原创细节度\n- 决策区间过滤 (置信度>=0.80,否则转待复核)"]

    B -. 可选外接 .-> E["Stage 4: 性能与外部情报\n- Google PageSpeed Insights (CrUX 真实数据 + Lighthouse 实验室)\n- DataForSEO (--full: 真实 SERP, 竞争对手, AI Overviews 引用)"]

    C --> F["Stage 5: 综合评分与优先级决策 (score.py)\n- 分项权重 (爬虫20, 内容20, On-page 15, AI 12, 性能10, 链接10, 结构化8, 安全5)\n- 影响面公式 (Severity x Reach x Importance)\n- 任务分类 (P1 / P2 / P3 / Quick Wins)"]
    D --> F
    E --> F

    F --> G["审计数据底座 (audit.json + digest.md)"]

    G --> H["Stage 6: Agent 叙述契约与校验 (narrative.json)\n- 引用行动项 ID 存在性强制校验 (JEV-###)\n- 工作量级别 (Hours / Days / Project) 严格对齐\n- 全局数字一致性反向拦截 (unverified_numbers)"]

    H --> I["单一强类型视图模型 (report/__init__.py)"]

    I --> J1["高保真 PDF 决策报告 (WeasyPrint / 内置 SVG 图表)"]
    I --> J2["可交互动作跟踪工作簿 XLSX (Actions Tracker / 预置公式)"]
    I --> J3["工程化 Markdown 报告 (内嵌 Mermaid 状态图)"]
整个流水线最大的特征在于:各阶段职责高度专一,上游产生的事实与概率数据作为不可篡改的底座,下游的 AI 叙述层必须严格依附于底座,杜绝越界编造。
3. 确定性防线:52 项硬规则与网络边界安全机制
在将页面文本喂给任何模型之前,jev-seo 首先通过纯 Python 编写的确定性模块,完成全站基础层面的严苛体检。
3.1 逐跳重定向与 SSRF 防护
在抓取网络数据时,单纯调用 requests.get(url) 是极其危险的。目标站点可能将重定向目标指向 127.0.0.1、AWS 元数据地址 169.254.169.254 或局域网内部服务,从而发起针对运行环境的攻击。
在 crawl.py 中,作者实现了一套严密的逐跳验证机制:
def public_host(host: str) -> bool:
    """SSRF 防护:严禁解析至私有网段、回环地址或链路本地空间"""
    try:
        infos = socket.getaddrinfo(host, None)
    except socket.gaierror:
        return False
    for info in infos:
        ip = ipaddress.ip_address(info[4][0])
        if ip.is_private or ip.is_loopback or ip.is_link_local or ip.is_reserved or ip.is_multicast:
            return False
    return True

class Fetcher:
    # ...
    def _send(self, method: str, url: str, **kw) -> requests.Response | None:
        """手动追踪重定向,确保每一次 Hop 均通过私有网络安全守卫"""
        history = []
        for _ in range(10):
            if urlparse(url).scheme not in ("http", "https") or not self._allowed_host(url):
                return None
            self._pace()
            try:
                # 禁用自动重定向,逐次掌控
                r = self.session.request(method, url, timeout=TIMEOUT, allow_redirects=False, **kw)
            except (requests.RequestException, ValueError):
                return None
            if r.is_redirect and r.headers.get("location"):
                history.append(r)
                r.close()
                url = urljoin(r.url, r.headers["location"])
                continue
            r.history = history
            return r
        return None
这段代码通过显式设置 allow_redirects=False,并用 for _ in range(10) 手工处理 HTTP 301/302,在每一次重定向建立套接字前均强制调用 public_host(host) 过滤内网 IP。这种防线能彻底切断通过 DNS 重绑定绕过验证的可能。
3.2 规则与启发式的显式隔离
在 checks.py 定义的 52 项规则中,每项规则均包含元组定义:
# id: (category, severity, title, fix, source key, effort 1-4, heuristic)
RULES = {
    "robots_blocks_site": ("crawl", "critical", "robots.txt blocks search crawlers from the whole site", "...", "robots", 1, False),
    "canonical_broken": ("crawl", "high", "Canonical target redirects or returns an error", "...", "canonical", 1, False),
    "viewport_missing": ("onpage", "high", "No mobile viewport meta tag", "...", "mobile", 1, False),
    # 启发式规则(Heuristics)明确标记为 True
    "title_length": ("onpage", "low", "Very short or very long titles", "...", "title", 1, True),
    "thin_content": ("content", "medium", "Pages with very little main content", "...", "helpful", 3, True),
    "llms_txt_missing": ("ai", "info", "No llms.txt file", "...", "llms", 1, True),
}
注意元组最后一项布尔值 heuristic:
- 对于有明确 W3C 或 Google Search Central 技术规范支撑的硬性指标(如 HTTP 错误、Canonical 失效、JSON-LD 语法解析崩溃、缺少移动端 Viewport),标记为
False; - 对于字数偏少(
thin_content)、标题字符长度偏短或偏长(title_length)、未提供社区草案协议llms.txt等,明确标记为True,并在给用户的报告中注明:“这属于行业编辑惯例,并非搜索引擎强制排名规则”。
3.3 规则引擎对模型决策的反向兜底
当语义模型建议对某些页面进行精简甚至下线(merge_or_remove)时,系统并没有盲信模型。在 score.py 中存在这样的断言机制:
if key == "action":
    # 规则引擎对冲模型误判:若长文本页面(>= 600词)被模型建议删除,系统将予以拦截
    keep = [
        i for i, u in enumerate(urls)
        if not (pages[u]["action"]["value"] in ("merge_or_remove", "noindex_or_remove") and words.get(u, 0) >= 600)
    ]
如果某个页面虽然在语义上看似结构分散,但正文实打实包含了超过 600 个有效词汇,系统会直接剔除删除指引,将其降级或转入人工复审,防止 AI 一键清空具有潜在权重的内容。
4. 终结大模型玄学:TypeSafe Jev 的 System One 概率语义判决
许多人把大模型当成“万能生成器”,但在工业级审计场景中,开放式生成意味着不可控。jev-seo 选用 TypeSafe AI 提供的 System One 端点(POST https://api.typesafe.ai/v1/systemone,调用 jev-latest 模型),展示了完全不同的 AI 使用范式。
4.1 核心类型基元与结构化问题
Jev 不输出多余的对话,而是针对给定的页面状态(标题、正文、导航、H1 等上下文,截断至 6,000 字符内),执行具有概率分布的确定类型判决:
- Choice(离散选项):
例如对页面类型的分类,经过盲测 A/B 测试对比,结构化描述将准确率从 20/30 提升至 27/30:PAGE_TYPES = { "homepage": "The site's front page introducing the whole organisation", "product_or_service": { "what": "Presents one product, service, feature, tool or module the organisation offers...", "examples": "a feature page, a service page, a tool or skill overview page..." }, "article_or_guide": "An editorial article, guide, tutorial, news item or opinion piece", "pricing": "Plans, prices or a quote request for the offer", "support_or_docs": {...}, "legal_or_policy": "Terms, privacy, cookies, imprint or other policy text", "other": "None of the above fits" } - Noul(布尔真值判决):
用于二元判断,输出非黑即白的置信概率。例如检测“是否答案前置”:- 题目:
page.opening(正文 H1 之后紧接的文本)是否在前两句话内明确交代了页面提供的方案或结论? - True 准则:开篇两句话直截了当指出读者能获得什么;
- False 准则:开篇是空洞口号、卖关子、作者与日期行,或大段漫无边际的客套铺垫。
- 题目:
- Score(标量分级评估):
对具体属性定义 4 个离散阶梯,系统将其归一化为 0~1 的浮点数。例如评估“原创具体度(Specificity)”:- Level 0: 泛泛而谈的套话,放进任何竞品网站都毫无违和感;
- Level 1: 大体泛泛,夹杂少量具体名词;
- Level 2: 通篇包含明确的功能名称、数据、场景或案例;
- Level 3: 具备独家一手细节、独创数据、独特业务流程与无法被他人复制的实战沉淀。
4.2 决策区间(Decisive Bands)与去伪存真
绝大多数 AI 工具遇到拿不准的情况,依然会信口雌黄。jev-seo 在底层架构上设立了严格的决策区间判定:
| 基元类型 | 判定阈值 | 处理策略 |
|---|---|---|
| Choice | 置信度(Confidence)≥ 0.80 | 认定为 决定性结论(Decisive),直接纳入评分与行动树 |
| Choice | 置信度 < 0.80 | 判定为 存疑(Review),在报告中打上 needs_review 标记,仅作为参考信号 |
| Score | 概率分布有 ≥ 0.80 落在中点的一侧 | 认定为 决定性结论 |
| Score | 概率分布在中点两侧分散 | 判定为 存疑,防止误报 |
| Noul | P(yes) ≥ 0.80 或 P(yes) ≤ 0.20 | 认定为 决定性结论 |
| Noul | 0.20 < P(yes) < 0.80 | 判定为 存疑,标记待人工确认 |
这种设计让审计结果具有极高的学术严谨性:工具敢于承认“我不知道”或“此项存在模糊性”,直接摧毁了传统 AI 工具的幻觉温床。
5. 面向大模型引用的 GEO 优化指标落地
随着 Google AI Overviews、Perplexity、SearchGPT 等生成式搜索引擎成为流量分发的重要入口,SEO 正在加速向 GEO(Generative Engine Optimization)演进。jev-seo 在业内较早将这些前沿理念拆解为可编程的量化指标。
graph LR
    subgraph GEO ["GEO 核心量化维度"]
        A["answer_first\n(开篇即交付答案)"] --- D["降低 AI 抓取提取成本"]
        B["citable\n(自包含事实与实体数据)"] --- E["提供高质量引用锚点"]
        C["entity_clarity\n(组织实体、业务与区域声明)"] --- F["建立权威知识图谱映射"]
    end

    subgraph Engine ["生成式搜索引擎 / 问答引擎"]
        D --> G["AI Overviews / Perplexity / SearchGPT"]
        E --> G
        F --> G
    end
在系统评估模型中,“AI 搜索就绪度(AI Search Readiness)”由两部分复合构成:
AI 就绪度评分 = 70% × Jev 语义指标 + 30% × 确定性规则
其中 Jev 语义指标重点考察三项能力:
- 开篇直击要点(Answer First):现代 AI 爬虫在抽取答案时优先读取前两句话。如果内容将核心论点掩埋在第三屏,模型摘要时将被判定为低相关度。
- 知识点自包含与高可引用度(Citability):文章内是否存在定义清晰、包含度量指标、独立成段即可构成事实引用的语句?
- 实体清晰度(Entity Clarity):首页与关于页是否以无歧义的陈述句,讲清了“组织是谁、主营业务是什么、服务于哪个领域”。
值得一提的是,jev-seo 在规则定义与报告文案中均明确附带了 Google 官方规范出处:“Google 官方声明,出现在 AI 摘要中并不需要脱离常规搜索标准的特殊技术优化。” 既帮助站长针对现代检索范式做足准备,又杜绝了借 GEO 之名贩卖焦虑。
6. 严防 AI 吹牛:用代码锁死 Agent 叙述契约
在 jev-seo 中,用户可以通过 Claude Code 运行 /jev-seo <url>,让高阶 Agent 读取中间层 digest.md 并撰写包含战略分析的 narrative.json。但开发者如何确保 Agent 在撰写总结时不夹带私货、不凭空编造数字?
在 jevseo/report/__init__.py 中,作者编写了令人惊叹的校验器:
6.1 行动项 ID 强绑定与工作量级校验
def load_narrative(folder: Path, data: dict) -> dict:
    path = folder / "narrative.json"
    ids = {a["action_id"] for a in data["actions"]}
    if path.is_file():
        n = json.loads(path.read_text())
        # ... 基础 key 检查 ...
        text = json.dumps(n)
        unknown = sorted(set(re.findall(r"JEV-\d{3}", text)) - ids)
        if unknown:
            # 只要 Agent 敢编造一个不存在的 JEV-XXX ID,直接中断退出
            raise SystemExit(f"narrative.json cites action IDs that do not exist: {unknown}")
        # ...
        n["unverified_numbers"] = unverified_numbers(text, data)
        n["effort_mismatches"] = effort_mismatches(n, data)
        return n
如果底层规则引擎只生成了 JEV-001 到 JEV-015,而 Agent 在汇报时擅自引用了幻觉出来的 JEV-099,程序会立刻拒绝渲染并报错。同时,effort_mismatches() 会检查 Agent 对任务耗时的描述:若底层标记此任务仅需数小时(Hours),而 Agent 在计划中夸大为“A project(大型项目)”,系统也会予以警告。
6.2 全局数值反向检索拦截器(unverified_numbers)
最震撼的是 unverified_numbers() 函数:
def unverified_numbers(text: str, data: dict) -> list[str]:
    """提取 Agent 文本中出现的所有数字,反向检索是否在审计测量数据集中存在真实出处"""
    # 过滤掉 URL、日期时间与 JEV 编号
    text = re.sub(r"JEV-\d{3}", "", text)
    text = re.sub(r"(https?://|/|@)[\w@./%-]*", " ", text)
    text = re.sub(r"\d{4}-\d{2}-\d{2}(?:T[\d:.+-]+)?", " ", text)

    known: set[float] = set()
    # 递归遍历所有分数、权重、页面字数、内链数、TTFB 延迟、API 成本账单、PageSpeed 得分...
    # 将真实测量出的每一个数值存入 known 集合
    # ...

    # 允许 1、100、0.001 的缩放(如小数转百分比,毫秒转秒)与四舍五入
    loose = set()
    for k in known:
        for scale in (1, 100, 0.001):
            for digits in (0, 1, 2):
                loose.add(round(k * scale, digits))

    bad = []
    # 扫描文本中的所有数字(大于 10 的非序号数字)
    for tok in re.findall(r"(?<![\w.,])\d{1,3}(?:,\d{3})+(?:\.\d+)?|(?<![\w.,])\d+(?:\.\d+)?", text):
        v = float(tok.replace(",", ""))
        if v <= 10 and "." not in tok:
            continue
        if v not in known and v not in loose:
            bad.append(tok)  # 发现未经实测支持的凭空捏造数字!
    return bad
这意味着:Agent 在文字总结中提及的任何一个关键数据(如“34 个页面缺少标题”、“评分仅为 58 分”、“延迟达到 1.2 秒”),必须在底层实测数据集中能找到精确对应的原始值或换算值。
只要 Agent 尝试编造“预计增加 4,500 次点击”或“跳出率高达 72%”,这一校验机制会立刻抓现行。这是当前软件工程中将 LLM 限制在确定性边界内的典范实践。
7. 交付物三位一体:从管理层汇报到工程落地
很多审计工具生成的产物要么过于技术化让非开发人员读不懂,要么全是图表无法直接指导开发。jev-seo 通过统一视图模型,一次性输出三种形态完备的成果:
| 输出格式 | 目标受众 | 核心内容与工程特色 |
|---|---|---|
PDF 报告 (report.pdf) |
创始人、技术总监、业务负责人 | 借助 WeasyPrint 渲染打印级高保真排版。内嵌 SVG 动态分数仪表盘、各维度长条图、Impact vs. Effort 决策象限矩阵、全站质量热力图与核心行动卡片。 |
XLSX 工作簿 (report.xlsx) |
前端工程师、SEO 执行团队、产品经理 | 包含自带数据有效性下拉框(Dropdown)的 Actions Sheet。状态列预置 Open、In Progress、Done、Won't Fix,Summary 仪表盘直接通过 COUNTIF / COUNTIFS 动态联动,开箱即用当作任务跟踪看板。 |
Markdown 文档 (report.md) |
AI Coding Agent、GitHub 归档、知识库 | 干净的代码风格 Markdown,原生内嵌 Mermaid 状态图与分类表格。可直接提供给 Claude Code、Cursor 或 Windsurf 等 Agent 作为自动化重构的上下文输入。 |
8. 审计成本与工业级权衡
在运行成本方面,jev-seo 展现出了极其苛刻的资源控制力:
- 基础抓取与 52 项规则排查:在本地单机完成,0 成本;
- PageSpeed Insights:调用 Google 官方开放 API,免费;
- TypeSafe Jev 语义决策:单价仅为 0.042 美元 / 百万输入 tokens,单页评估消耗约 3,400 tokens(折合单页成本仅约 0.00015 美元)。对一个典型的 60 页中小型站点做全量语义判决,总花费通常 仅需约 0.01 美元(折合人民币仅约 7 分钱);
- 硬性预算安全锁:系统内置
--jev-budget(默认 0.25 美元)与--dfs-budget(默认 1.00 美元)。在发起任何网络调用前均执行预算对账,一旦触碰预算上限自动跳过后续请求,并在账单明细中如实记录,杜绝出现账单失控。
9. 总结与启示
jev-seo 的开源为我们展示了 AI 与传统工程化体系融合的正确姿势:
- 不要让大模型去做规则引擎能做的事:状态码判断、死链嗅探、Canonical 对比、协议检查,这些交给确定性的代码执行,速度最快、消耗为零、判定精准;
- 将模型严格约束在“打分与裁判(Judge)”角色:定义明确的类型基元(Choice、Noul、Score),设立置信度区间,敢于标注“存疑待查”,彻底杜绝过度自信的幻觉;
- 在交付边界处设立硬核拦截网:通过动作 ID 存在性检查与全局数值反向遍历校验,用代码把 Agent 的胡言乱语锁死在真实测量的边界之内;
- 输出即交付,交付即工作流:将审计报告设计成可以直接流转给团队执行的 Excel 任务板,以及可直接供 AI Agent 下一步自动重构代码的 Markdown。
当 SEO 迈向 GEO,工具链比拼的不再是谁能生成更华丽的套话,而是谁能以最低的成本、最可靠的确定性防线,提供无法被推翻的真实证据。
原文链接与参考资料
- GitHub 官方开源仓库:AgriciDaniel/jev-seo (Live SEO audit for any website, judged by Jev)
- GitHub Daily 推荐动态:GitHub_Daily on X (@GitHub_Daily)
- 开发者个人主页:Daniel Agrici (@AgriciDaniel)
- TypeSafe AI 核心文档:TypeSafe AI Primitives & System One
- Google 官方搜索指南:Google Search Central Documentation
- WeasyPrint 打印与排版引擎:WeasyPrint Official Docs