
图是长出来的,不是画出来的:从 570 个任务实操看多 Agent 图工程(Graph Engineering)与改图权治理
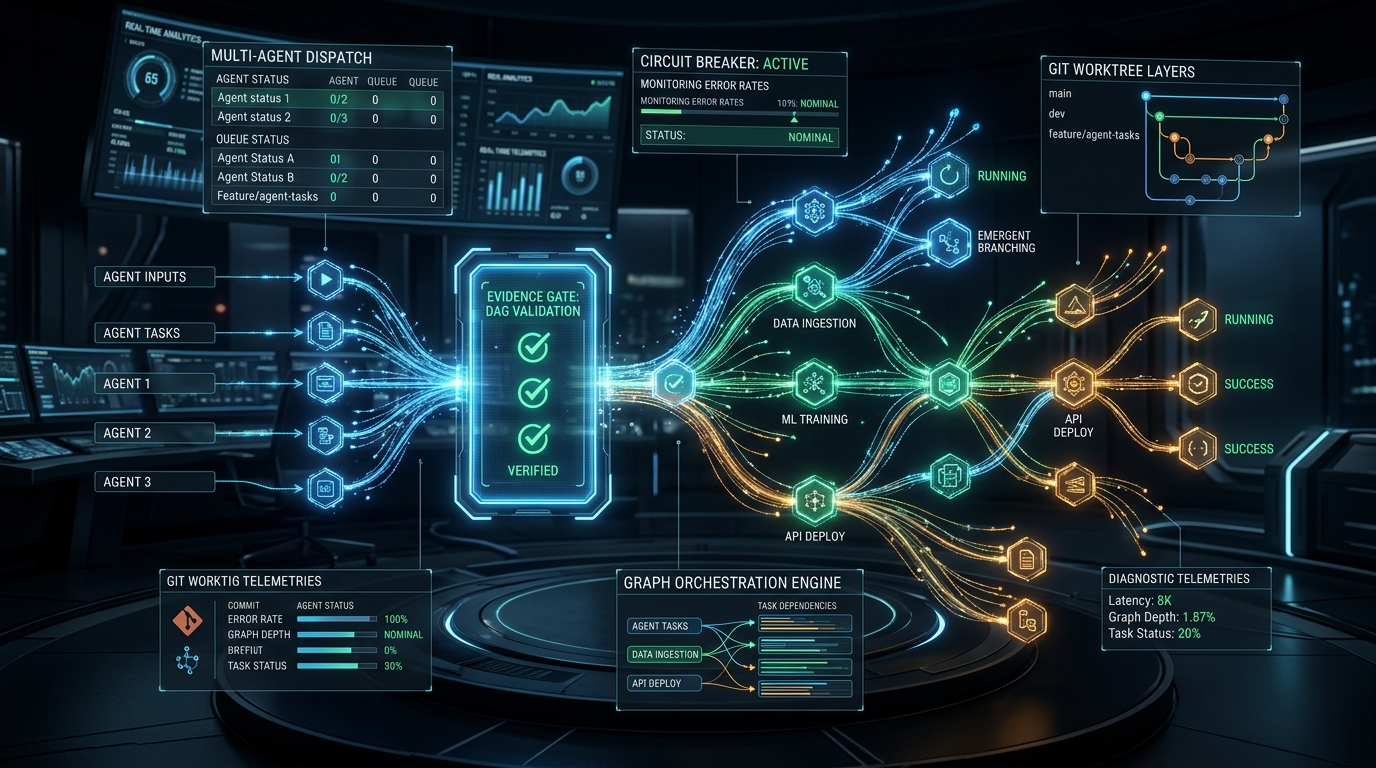
随着大语言模型编码能力从单次代码补全迈向自主执行,AI 研发范式正经历一场深刻的蜕变:从早期由单一模型驱动的单循环(Loop Engineering),全面进阶到由拓扑图驱动的多智能体系统(Graph Engineering)。然而,当开发者试图将几十乃至上百个子任务编排进有向无环图(DAG)并交给并行 Agent 集群执行时,往往会遭遇严峻的工程现实——计划赶不上变化,看似全绿的构建在真机上轰然溃败。
前字节跳动移动端架构师 Aiden(@wohsj110)在一个月内调度 570 个 Agent 任务的硬核实战,为我们揭示了工业级图工程的核心底牌:长任务要想真正立得住,Graph 只解决了任务切分与衔接;跑得对不对必须靠机器硬证据构筑的 Eval 门禁;而跑偏后能否自我修复,则取决于运行时的“改图权”治理机制。
引子:从单循环到拓扑图,AI 工程化的认知跃迁
在 2026 年的 AI 编程演进中,一条分水岭正在变得无比清晰:
- 循环工程(Loop Engineering):以 ReAct、Claude Code 或 SWE-agent 为代表,其本质是一个围绕单一上下文窗口的反馈回路(
while (!done) { think -> tool_call -> observe })。它擅长在有限上下文和已知边界内解决局部 Bug,但面对跨仓库、长生命周期、强并发的工业级新需求时,极易陷入上下文腐化、死循环和注意力漂移。 - 图工程(Graph Engineering):将复杂工程目标拆解为具备明确依赖(Dependencies)、状态流转与拓扑结构的任务图(Task Graph),由 Orchestrator(编排器)统一调度不同专长的 Worker Agent 并发执行。
Twitter 上关于此话题的讨论在今年夏季彻底引爆。Peter Steinberger(@steipete)一句调侃直击要害:“are we still talking loops or did we shift to graphs yet(我们还在聊单循环,还是已经切换到图了?)”,在短短数日内让“图工程(Graph Engineering)”成为了 AI 时代系统工程师的核心必修课。
然而,市面上大多数关于 LangGraph、动态工作流的讨论,往往停留在静态图设计与提示词拓扑层面:先画好一张完美的 DAG,定义好节点和输入输出,然后编译运行。
但真实且残酷的工程实践告诉我们:在充满未知的新需求开发中,静态图几乎注定会在第一块骨牌倒下时全盘破裂。
核心基石:长任务立得住的“铁三角定律”
在长达 31 天、涵盖 570 个任务的真实移动端开发实践中,能够沉淀下来的核心定律唯有这一条:
Graph 解决长活怎么拆开、怎么往下接;Eval 解决跑得对不对;改图权解决跑偏后能不能拐回来。三者同时成立,长任务才立得住。
flowchart TD
    subgraph Triad["长任务落地的铁三角定律 (The Triad of Long Agent Tasks)"]
        direction TB
        G["1. Graph(图拓扑与编排)<br/>• 任务解耦与依赖追踪<br/>• 并发调度与上下文切片<br/>(底线:它只负责拆解与衔接)"]

        E["2. Eval(机器硬证据门禁)<br/>• 前置假前提证伪<br/>• 单元测试 / 真机行为 / 日志<br/>• 严格硬阻断,杜绝假成功<br/>(底线:杜绝模型互评自嗨)"]

        M["3. 改图权(动态重构与熔断)<br/>• 运行时动态插入/删除节点<br/>• 依赖重新接线 Rewiring<br/>• 错误分支整段作废 Supersede<br/>(底线:闭环无法质疑自身目标)"]
    end

    G -->|"派发任务与依赖"| E
    E -->|"输出机器客观证据"| M
    M -->|"重构图结构与校正目标"| G
如果抽掉其中的任何一角,系统都会陷入典型的失效模式:
- 缺少证据门(Eval):系统会陷入“假成功”。所有前置节点全部报告完成,状态显示全绿,但下游节点其实全部建立在一个脆弱甚至完全错误的假前提上。最终末端吐出的是一份格式精美却毫无价值的废代码;
- 缺少改图权(Mutation):一旦执行器在现实环境中撞墙,发现前置假设不成立,整张静态图立刻报废,只能由人工介入整单推倒重来,多 Agent 带来的并发与自主优势荡然无存;
- 缺少拓扑编排(Graph):退化回原始的单循环,Agent 在漫长的上下文堆叠中迷失自我。
一 · 跑得远:图是长出来的,不是开工前画出来的
在图工程的实践中,最常犯的先验错误就是试图在开工前画出一张包罗万象的完整任务图。
1. 已知疆域 vs 未知疆域
正如 Anthropic 团队成员 @trq212 在《A Field Guide to Fable: Finding Your Unknowns》中所指出的:“地图不是疆域(The map is not the territory)”。你提供给 Agent 的 Prompt、API 规范、需求文档与用例代码,都只是地图;而真实的代码仓库、历史技术债、未写入文档的隐性约束,才是真实的疆域。
在工程领域,我们必须严格区分两类场景:
- 已知疆域(Known Territory):标准化的 SOP、定时巡检、模板化脚手架、代码批量迁移、版本打包发布。此类任务的拓扑结构已经过上百次验证,形状固定不变。此时采用“先画 Graph,由代码生成并执行脚本”的编译模式是最优解;
- 未知疆域(Unknown Unknowns):编写全新业务功能、架构重构、接入未充分验证的三方 SDK。你根本无法在开工第一天预知上游接口是否有未公开的鉴权约束,也无法预判某项枚举改动是否会连带触发系统调度器的崩溃。
2. 5 小时 10 分钟内的拓扑生长实录
在真实的 41 任务复杂编排案例中,运行监控揭示了一个反直觉的现象:任务图的节点数量并不是从 41 开始的一条水平线,而是在 5 小时 10 分钟的时间跨度内持续攀升的长尾生长曲线。
flowchart TD
    T0["05:24 开工初始任务图<br/>(仅定义 2 个初始节点)"] --> T1["Task-001 (Wayfinder 探路摸底,只摸边界不写代码)<br/>Task-002 (首个最小切片实现)"]
    T1 -->|"运行 16 分钟,探明隐藏约束"| T2["05:40 摸出跨模块未记录约束<br/>动态追加 3 个数据适配任务"]
    T2 -->|"运行至 07:15,真机撞上假前提"| T3["07:15 Task-005 真机验收拦截假前提<br/>运行时动态插入 Task-013 (P0 后端实现) 并重接依赖"]
    T3 -->|"运行至 08:30,真机暴露边界冲突"| T4["08:30 模块间冲突暴露<br/>派生 recovery / correction 等修正节点"]
    T4 -->|"持续演进至 10:34,终验全通"| T5["10:34 拓扑最终收敛至 41 个节点<br/>完成整体需求交付并放行"]
开工时,图中实际上只定义了 2 个极简任务:
- 探路任务(Wayfinder):采用专门的探路 Skill,严禁写任何业务代码,仅用于摸索工程边界——定位关联文件、挖掘未写入文档的隐藏逻辑、排查一触即发的连锁依赖,最终交还一份“此前未知的隐性事实清单”;
- 初始切片任务:基于探路结果,仅实现第一块核心数据模型。
后续的 39 个任务,分散在多达 31 个不同的时间节点上陆续生成。其中带有 recovery(恢复)、reverify(复验)、correction(纠偏)前缀的任务,全部是在前置任务真实运行、触碰到现实环境约束之后,才由 Orchestrator 动态追加生成的。
图不是在白板上凭空画出来的,而是在与真实系统的持续碰撞中“长”出来的。
二 · 跑得对:如何防范“全绿”的假成功
在多 Agent 协同中,最隐蔽、杀伤力最大的风险,不是任务直接抛出异常,而是 假成功(False Success)。
1. 假前提的致命蔓延
在一次典型的新功能开发中,规划阶段的计划中赫然写着一条前提:“后端与 Runner 已就绪”。这行字在文本上看起来合理自然,没有引发任何静态审查报警。
随后,任务拆解为枚举添加、组件实现、入口注册。前 4 个任务在代码生成层面完美通过,全部亮起绿灯。
直到第 5 个任务——通过端侧自动化测试框架 agent-device 直接在真机上运行用例时,系统瞬间现了原形:真机上的 Runner 和 Scheduler 压根无法识别新传入的类型枚举,直接将其判定为非法操作!
“后端与 Runner 已就绪”是一句彻头彻尾的假前提。如果缺少了面向真机行为的硬质门禁,后续挂载其下的几十个任务将会继续在空气中添砖加瓦,认真抛光、包装、写单测,直到交付末端爆发出巨大的灾难。
2. 拒绝“模型互评自嗨”的虚荣戏剧
很多团队在构建多 Agent 系统时,热衷于引入“LLM-as-a-Judge”或多角色互评(Adversarial Panel)。然而,正如知名 AI 架构学者在剖析控制理论时所警示的:
“A loop that runs on schedule while its measurements have detached from the world is theater with good attendance.”
(当一个控制回路的观测指标彻底脱离了现实世界,即便它按部就班地运转,也只是一场上座率极高的自嗨戏剧。)
模型审查模型、Agent 给 Agent 点赞,本质上仍是在模型自身的先验幻觉空间里打转。要防止假成功,必须将门禁锚定在 不可争辩的客观机器证据(Machine Ground Truth)之上:
| 证据层级 | 检验维度 | 真实 Anchor(锚点) | 伪验证(严禁作为放行依据) |
|---|---|---|---|
| L1: 前置事实核验门 | 基础假设真实性 | 真实调用的返回日志、配置生效凭证、已运行环境状态 | 需求文档写着“已具备”、Prompt 里假设“已部署” |
| L2: 逻辑与数据层 | 算法与逻辑正确性 | 确定性编译器通过、覆盖核心边界的单测 Pass | 模型自查并回复“我仔细看了代码,逻辑没问题” |
| L3: 端上行为层 | 系统真实交互与集成 | agent-device 真机点击、状态机断言、UI 元素存在证明 |
无头浏览器的盲目截图、纯视觉 OCR 猜测 |
| L4: 时序与鉴权层 | 状态持久化与安全性 | 服务端真实审计日志、网络抓包 Sequence | 仅凭前端 UI 展示的虚拟回调 |
flowchart TD
    TaskStart["Worker 任务执行完成"] --> Gate1{"Gate 1: 前置事实核验<br/>(底层服务是否真实就绪?)"}

    Gate1 -- "假前提(无事实依据)" --> HardBlock1["硬阻断 (Hard Block)<br/>拒绝派发任何下游任务"]
    Gate1 -- "真机证据通过" --> Gate2{"Gate 2: 单元测试与类型编译<br/>(逻辑层是否无损?)"}

    Gate2 -- "单测失败 / 类型破损" --> HardBlock2["硬阻断 (Hard Block)<br/>退回重修,保留错误现场"]
    Gate2 -- "编译与单测全过" --> Gate3{"Gate 3: agent-device 真机验收<br/>(端侧实际行为断言?)"}

    Gate3 -- "断言失败" --> HardBlock3["硬阻断 (Hard Block)<br/>触发诊断协议,拒绝盲目重跑"]
    Gate3 -- "真实行为符合预期" --> Approve["放行通过 (Released)<br/>解锁下游依赖任务"]
3. 硬阻断原则:非阻断即无治理
在工程治理中,“写进报告里提示风险,先继续往下跑”是最具欺骗性的做法。
当警告日志越积越多,操作者的第一反应必然是“先跑着,回头再看”。这条软性警告就等于彻底不存在。
唯有硬阻断(Hard Blocking)才能带来真实可靠性:这一步没有机器证据通过,所有依赖它的下游任务绝对禁止派发。 没有任何讨价还价的余地,要么改到通过,要么由具备全局视野的仲裁者显式修改判据。
三 · 拐得回来:运行时“改图权”与三级治理架构
有了硬证据,系统能够精准定位“哪里出了错”。然而,光知道出错还远远不够。谁有权修改依赖关系?谁有权新增任务或废弃已有节点?这就是 运行时改图权(Runtime Mutation Authority)的核心命题。
1. 为什么执行者(Worker)绝不能拥有改图权?
控制理论告诉我们:闭环无法质疑自身的目标。
“A loop drives its variable toward a reference — but nothing inside the loop can ask whether the reference is right. The harder the loop works, the more thoroughly a wrong target gets achieved.”
(一个控制回路竭尽全力让状态变量逼近参考目标——但回路内部的任何组件都无法质疑参考目标本身是否正确。这个回路运转得越卖力,错误的目标就会被执行得越彻底。)
如果将改图权下放给干活的 Worker Agent,当遇到困难时,它最倾向的解法往往是放宽约束、伪造 Mock 响应,甚至直接修改断言。
因此,改图权必须遵循三级分权治理架构:
flowchart TD
    subgraph L3["第三级:人类工程师 (Human Supervisor)"]
        H["仅监控异常栏 (Exception Watcher)<br/>• 3 次熔断未解时介入<br/>• 核心架构变更仲裁<br/>• 平时保持静默"]
    end

    subgraph L2["第二级:编排仲裁器 (Orchestrator)"]
        O["掌握跨仓库/全局约束 (Global Context)<br/>• 拥有动态改图全权 (Task Mutation)<br/>• 裁定任务插入、依赖重接、分支作废<br/>• 拒绝局部妥协方案"]
    end

    subgraph L1["第一级:工作执行者 (Worker Agents)"]
        W1["Worker A (业务实现)"]
        W2["Worker B (测试编写)"]
        W3["Worker C (真机取证)"]
    end

    W1 -.->|"提交执行回执与机器证据"| O
    W2 -.->|"遇到阻断发起 Ask 咨询"| O
    W3 -.->|"上报不成立前提"| O
    O -->|"动态下发新任务与调整依赖"| W1
    O -->|"异常穿透升级"| H
    H ==>|"人工注入顶层决策"| O
2. 动态改图的实际操作:以 Task-013 为例
回到前文真机验收被拦截的真实案例:
Task-005在真机执行后,将未识别枚举的错误证据上报;- Orchestrator 拿到证据后,判断出“后端与 Runner 已就绪”是假前提;
- Orchestrator 行使改图权:
- 动态创建新任务:
Task-013 后端服务与 Runner 兼容实现,定级为最高优先级P0; - 依赖重连:将原本挂载在
Task-005下游的Task-010和Task-011,将其前置依赖全部重定向至新生成的Task-013; - 备注留痕:“
task-005 真机暴露:后端/Runner『已就绪』是假前提”。
- 动态创建新任务:
编号之所以排到 013,是因为它最后被创建;但在运行拓扑的有向图上,它被精准插入到了 010 之前。整个重构过程无需人类介入,完全由证据驱动完成拓扑再造。
3. 熔断策略与整段推翻(Supersede)机制
面对执行失败,必须建立明确的熔断机制:
严禁原地无脑重试! 一次失败里蕴含的信息量远超一次成功,它精准标定了“地图”与“真实疆域”的偏差所在。盲目重试等于把高昂代价换来的调试信息直接扔进垃圾桶。
- 三轮诊断循环:
诊断 -> 修复 -> 再次验证。最多允许 3 次闭环调整; - 熔断上报:若连续 3 轮仍未通过,触发熔断,停止自动重试,打包全部机器诊断日志,向上一级 Orchestrator 或人类工程师告警;
- 整段废弃(Superseded):如果诊断证实前置任务的根基完全错误,挂载在其下的十几个任务失去存在意义。系统必须将该分支全部标记为
Superseded并保留审计轨迹,重新开辟干净的子图,切忌在错误的泥潭里修修补补。
四 · 工程落地的物理底座:Orca 与 Worktree 隔离
在多 Agent 协同编程的工程落地中,有两个往往被算法工程师忽视、却决定系统生死的物理基础设施:
1. Git Worktree 物理隔离:终结文件锁与合并冲突
当 5~10 个 Worker Agent 同时处于“思考-编码”状态时,若让它们共享同一个项目目录,必然会引发惨烈的文件读写竞争、未提交代码覆盖以及 Git Index 锁死。
基于 Orca(onorca.dev)的编排方案在底层深度利用了 Git Worktree 隔离机制:
- 为每个派发出的 Worker 分配独立的 Worktree 工作目录;
- Worker 在完全隔离的物理空间内改写代码、运行构建、跑局部测试;
- 只有在通过三轮独立复核并获得 Orchestrator 授权后,才通过标准 Pull Request / Merge 管道合并至主分支。
flowchart LR
    MainBranch["Repo: main 主分支<br/>(只读保护 / 干净基线)"] --> WT1["Worktree A (Task-008)<br/>独立工作区"]
    MainBranch --> WT2["Worktree B (Task-013)<br/>独立工作区"]
    MainBranch --> WT3["Worktree C (Task-020)<br/>独立工作区"]

    WT1 -.->|"通过 Eval 门禁"| PR1["合并至主线"]
    WT2 -.->|"通过 Eval 门禁"| PR2["合并至主线"]
    WT3 -.->|"通过 Eval 门禁"| PR3["合并至主线"]

    PR1 --> MainBranch
    PR2 --> MainBranch
    PR3 --> MainBranch
2. 状态可视化与审计回溯
“图能动态改”,其技术前提是所有的改图操作(增删节点、重连边、状态跃迁)必须全部走标准化 API 接口,并持久化到本地状态存储中。
利用 npx orca-viz@latest,工程师可以随时调取运行快照:
- 绿色:已通过机器证据验收并放行;
- 橙色:正在独立 Worktree 中并发运行;
- 蓝色:依赖条件满足,就绪待派发;
- 灰色:规划就绪但前置门禁尚未解锁。
清晰的看板让操作者一眼看透整个智能体集群的真实运转水温,彻底告别“终端黑盒”。
总结:从“调优提示词”到“治理图与证据”
回顾这场跨越 570 个任务的深度探索,我们所获得的不仅是几个脚本工具,更是面向下一代软件工程的核心认知蜕变:
- 图拓扑(Graph)是骨架:它负责将庞大需求解构为可吞吐的小片段,但跑得远不等于跑得对;
- 证据门(Eval)是神经:它负责感受真实世界的阻力。工具(如
agent-device或 Computer Use)只是手脚,真正的 Eval 是工程师倾注心血定义出的代码可断言性、任务约束与阻断判据; - 改图权(Mutation)是肌肉:它是系统具备反脆弱性的关键。唯有外层仲裁者拥有合法的拓扑重塑权,挫折才能真正转化为下一版拓扑的滋养输入。
从今天起,别再试图画一张永不变更的完美架构图。搭建好硬核的机器证据门,赋予编排器审慎的改图权,让你的图在真实系统的撞击中自然生长出来。
原文链接与参考资料
- 原文推文与核心论述:Aiden (@wohsj110) 发布的 X 深度长文《我是如何用 Orca 做 Graph Engineering》(X Article ID: 2081635007739604992)
- 拓扑编排引擎:Orca 官方文档与开源项目
- 真机自动化工具:
agent-device端侧真机自动化执行器 - 认知参考:
- Anthropic @trq212: 《A Field Guide to Fable: Finding Your Unknowns》 (2026-07-07)
- Peter Steinberger (@steipete): “are we still talking loops or did we shift to graphs yet” (2026-07-18)
- Carlos E. Perez: 《From Loop Engineering to Graph Engineering》 (2026-07-18)
- Mike Piccolo: 《Loops, graphs, and the layer that matters》 (2026-07-21)
- LangChain: 《3 Years of Graph Engineering with LangGraph》