系统更新后你的 App 扎眼吗?从性能与 Look & Feel 二维坐标,看客户端技术对 Native 的终极回答

在过去十几年的跨端开发与客户端架构演进史中,关于“到底什么是 Native(原生)”的口水战几乎从未停歇:

“Flutter 编译成机器码,算不算 Native?”
“React Native 底层调用了系统组件,它算不算 Native?”
“Rust 写的 GPUI 拥有 120 帧极致流畅度,难道不是终极 Native 吗?”
“为什么用 Electron 写的桌面应用,无论怎么优化,总给人一种‘假假’的感觉?”

很多工程师习惯从编译器本位(是否编译为裸机二进制、是否有 GC、是否有虚拟运行时)来粗暴划分阵营。然而,这种纯底层指令视角的定义,往往在真实的用户体验与操作系统演进面前显得极其苍白。

今天,资深 macOS / iOS 独立开发者 Cyandev@unixzii)在 X(原 Twitter)上发表了一段极其精辟的技术论断,并附带了一张震撼客户端技术圈的二维坐标图:

“评价一个技术是否 native 可以从两个维度出发,一个是性能,一个是 look and feel。后者是个比较抽象的概念,我一般会看在系统更新后,app 是否可以立刻获得最新体验。如果一个 app 在系统更新过后显得十分扎眼,比如红绿灯没有玻璃效果,那很难说它是 native。但很多平台其实没有一个 canonical 的 UI toolkit,那评判指标就只剩性能了。”
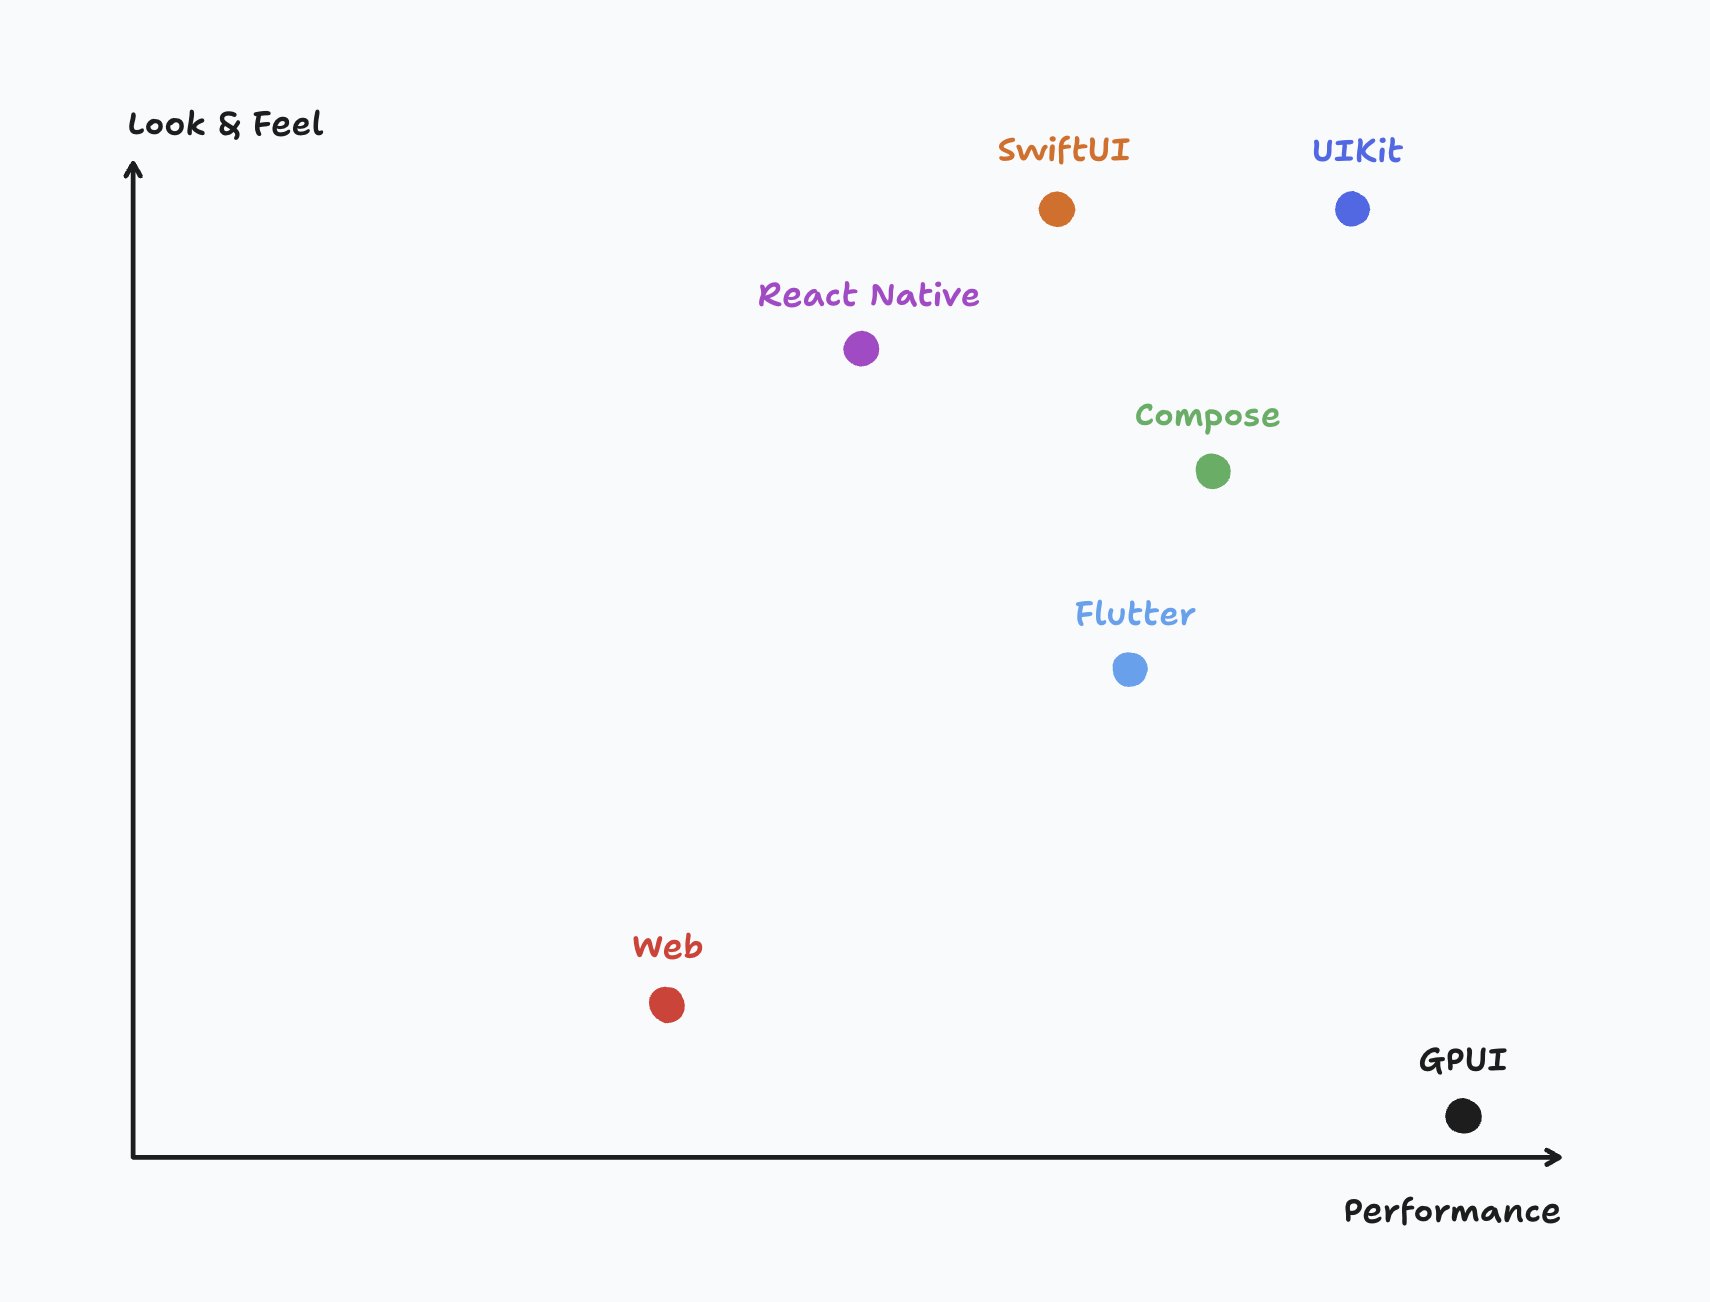
Cyandev 对各大 UI 技术的二维坐标评估

这个维度的提出,堪称近年来客户端工程界最具穿透力的技术洞察之一。它不仅解构了 UIKit、SwiftUI、React Native、Compose、Flutter、Web 以及 GPUI(Zed)的本质分野,更一语道破了 Apple 生态与 Windows、Linux 平台在图形界面哲学上的根本宿命。

本文将顺着这一坐标系,深入剖析性能与 Look & Feel 的底层交互逻辑,拆解各主流图形框架的架构得失。

陪审团查证、主审官举证:Code Jury 如何用多智能体法庭质辩终结 PR 评审幻觉

在 AI 编码工具(Claude Code、Codex、Cursor、Antigravity 等)全面接管研发日常的今天,代码产出速度暴涨了十倍,但研发效能的真正堵点却顺延到了下游:代码评审(Pull Request Review)

为了分担人类工程师的审阅负担,不少团队尝试引入 AI 进行自动代码审查。然而,早期的尝试往往迅速沦为两场灾难:要么是单个智能体“自审自查”,陷入 自证清白的严重幻觉 与虚假绿灯;要么是拉入多个智能体互审互改,演变成 “无休止的乒乓补丁战” ——A 提修改,B 反对并改回,C 又引入无端抽象,甚至连改 10 轮依然无法收敛。

近期在开源社区备受瞩目的 Code Juryagentsdance/codejury),以一种极富创见的“英美法系法庭质辩”架构,彻底打破了这一僵局。它将多智能体分工重构为 “只看不动的陪审团(Jury)” 与 “唯一动刀的主审法官(Judge)”,并推行极其严苛的 机械证据门禁(Mechanical Gate)

本文将深入剖析 Code Jury 的核心架构、博弈收敛机制以及在生产级复杂并发系统中的真实质辩案例。

如何让每天 300 轮 CI 提速 50%?Ekstazi 与 Google TestSage 精准测试顶会论文研读

在上一篇关于 Vibe Coding 质量防线的探讨中,我们提到了高频交付团队的痛点:当 AI 驱动代码产出呈指数级激增,团队每天上线 50 次、流水线触发 300 轮 CI 时,全量测试的执行耗时与庞大算力开销将成为阻断交付的致命瓶颈

此时,精准测试(Regression Test Selection, RTS)成为了现代效能工程的唯一解。但市面上多数团队自研或引入的测试选择工具,要么漏测频发,要么分析本身耗时甚至超过了跑测试的时间。

在精准测试近四十年的演进史上,有两篇里程碑式的学术与工业顶会论文彻底改变了该领域的工程范式:

  1. 《Practical Regression Test Selection with Dynamic File Dependencies》(ISSTA 2015 杰出论文奖,来自 UIUC 团队的 Ekstazi);
  2. 《TestSage: Regression Test Selection for Large-scale Web Service Testing》(ICST 2019 Industry Track,来自 Google Assistant 核心团队)。

这两篇经典论文究竟解决了什么看似无解的工程矛盾?它们给今天处于 AI 编码狂潮中的微服务与前后端流水线带来了哪些不可替代的架构启示?本文将带你展开一次透彻的端到端深度论文拆解。

走出 Vibe Coding 质量陷阱:从“自证清白”的虚假测试到日均 50 次发布的精准防线

随着 Claude Code、Cursor、Cline 等 AI 编码工具的全面普及,软件工程步入了烈火烹油的 “Vibe Coding” 狂欢。当生成语法合规的代码变得几乎零成本,代码产出呈十倍级暴涨,但软件的最终交付质量却普遍没有提升,甚至引爆了灾难性的维护危机。

资深架构师姚钢强(@yaogangqiang)在社交网络分享了来自一线创业团队的残酷共鸣:“由于 AI 堆砌出的 Bug 太多,团队天天在修 Bug,稍微长期来看,甚至觉得人肉写代码的速度更快。”面对此景,很多人脱口而出的解法是:“让 AI 给自己写测试不就行了吗?”

然而,现实往往走向另一个极端:AI 自动生成的测试,几乎全都是充满 Mock、严重绑定实现细节的脆弱测试,甚至沦为“用自己的实现来证明自己没错”的自证清白。 软件测试从来不是高质量的救命稻草——“Quality is designed in, not tested in”。面对日均 50 次线上发布、每天 300 轮 CI 的高压环境,工程团队究竟该如何筑起坚不可摧的质量防线与精准测试体系?

你在卖工时,还是在攒资产?前线部署工程师(FDE)的认知捕获、产品沉淀与避坑法则

2026 年,“Forward Deployed Engineer”(前线部署工程师 / 前向部署工程师,简称 FDE)已经成为企业级 AI 与基础软件领域最炙手可热的岗位。从 OpenAI、Anthropic 到 Databricks、Mistral,各家科技巨头不仅为 FDE 开出极具竞争力的薪酬,甚至催生出了 Forward Deployed Architect 与 Forward Deployed Security Engineer 等细分职位。

然而,在 a16z 举办的一场 FDE Fellowship 闭门晚宴上,曾主导 Palantir 传奇轮岗计划“前线项目”(Project Frontline)、历任 Citadel 商业工程负责人、现任 Kepler CEO 的 Vinoo Ganesh 却道出了一个令全行业清醒的真相:当今市场上自称 FDE 的人,绝大多数本质上只是换了一个光鲜头衔的技术咨询顾问与驻场外包,只是他们自己尚未意识到而已。

究竟什么是真正的 FDE?为什么在 SaaS 黄金十年落幕、大模型重构生产力的当下,所有科技企业都被迫奔赴客户现场?而在充满脏数据与政治妥协的业务前线,工程师又该如何区分自己是在“卖工时”还是在“攒资产”?本文基于一线实战沉思,深度剖析 FDE 的本质命题与组织避坑指南。

不卖软件卖结果:从 Palantir 到 Anthropic 亲历者眼中的 FDE 架构法则与 Agent 商业破局

在欧美上市的 Fortune 500 SaaS 企业阵营中,存在一个极其诡异且悬殊的商业断层:

若按平均合同金额(ACV, Average Contract Value)排位,Palantir 以单笔客户均价 400 万美元 傲视群雄;位列第二的 ServiceNow 仅有约 120 万美元;第三名 Workday 约在 60 万美元 上下徘徊;而其余绝大部分声名显赫的公开交易 SaaS 公司,平均合同额无一能够跨过 50 万美元 的门槛。

更耐人寻味的是,Palantir 仅凭数千名员工的组织体量,便撬动了传统巨头数万人才能换来的惊人客单价与战略级客户粘性。

跨平台构建底座、无开销内存借用与并发演进:Swift 6.4 架构级更新深度解析

随着 Swift 6.4 官方版本的正式发布,这门由 Apple 主导但日益走向全栈与开放的编程语言,迎来了一次兼顾“系统级性能纵深”与“全平台工程一致性”的里程碑式演进。

如果说 Swift 6.0 的核心主题是全面建立 Compile-time Data Race Safety(编译期数据竞争安全),那么 Swift 6.4 则在这座安全高塔之上,吹响了向现代系统级编程、超高性能零拷贝运行时以及泛终端(Linux / Windows / Android / Wasm / 嵌入式)发起全面冲锋的号角。从取代旧版构建体系的 Swift Build,到告别引用计数负担的独占堆所有权容器 UniqueBoxUniqueArray,再到异步清理神器 withTaskCancellationShield 与 Subprocess 1.0 正式落地,Swift 6.4 正式展现出一门成熟全栈语言的架构自信。

本文将摒弃浮于表面的清单式罗列,以底层架构演进、内存模型重塑与实战生产力为脉络,深度剖析 Swift 6.4 带来的核心技术跃迁与工程实践启示。

贷款制、零服务器与去意图套利:杭州 OPC 120 款 App 工业化出海的极端工程哲学

在杭州的 AI 独立开发者(OPC,One Person Company)圈子里,流传着一个令传统软件工程师与产品经理集体失语的案例:5 个月手搓 120 多款 App 上架 App Store,90% 以上拥有真实付费转化,日均倾泻超过 1 亿 Token,而整条产线的无人化率高达 95%

更颠覆认知的是他的核心驱动逻辑—— “AI 贷款制”:人只掏第一个苹果开发者账号的 99 美元;AI 被赋予借贷者的身份,它的首要生死使命是靠写出的 App 自己把这 99 美元赚回来;一旦赚回 3 个 99 美元,它就自主向下一个新账号放贷……如此递归裂变,人类的资金池自始至终被死死锁死在最初的 99 美元。

当全网都在狂欢 Vibe Coding:独立开发者该如何构建“营销工程化”智能体底座

随着大语言模型与智能体开发环境(ADE)的普及,“Vibe Coding”(氛围编码)正在以惊人的速度席卷整个开发者社区。如今,一名独立开发者或 Solo Founder 仅凭一个点子、几轮自然语言 Prompt 与 Cursor、Windsurf 或 Codex 的协同,就能在几天甚至几小时内搓出一款功能完备的 SaaS、微型工具或移动端应用。然而,一个残酷的现实随之浮出水面:当软件生产的边际成本趋近于零,分发与获取用户注意力的成本却在指数级攀升

先验架构再动手术:Birdview 如何用证据链地图与声明式活动流重塑 Agent 编码工作流

在当今大语言模型驱动的代码智能体(Coding Agent)生态中,我们正在经历一场前所未有的工程范式跃迁:从最初的行级代码补全,到文件级对话重构,再到如今由 Agent 自主探索代码库、执行终端命令并提交代码变更。然而,在这场激进的自动化狂欢背后,几乎所有资深开发者都隐隐感受到一种失控的恐惧 —— “AI 编码的黑盒陷阱”。