
剥离文本生成后的架构跃迁:Polylane 用 Jev 裁决 6 万次运维决策的落地实证
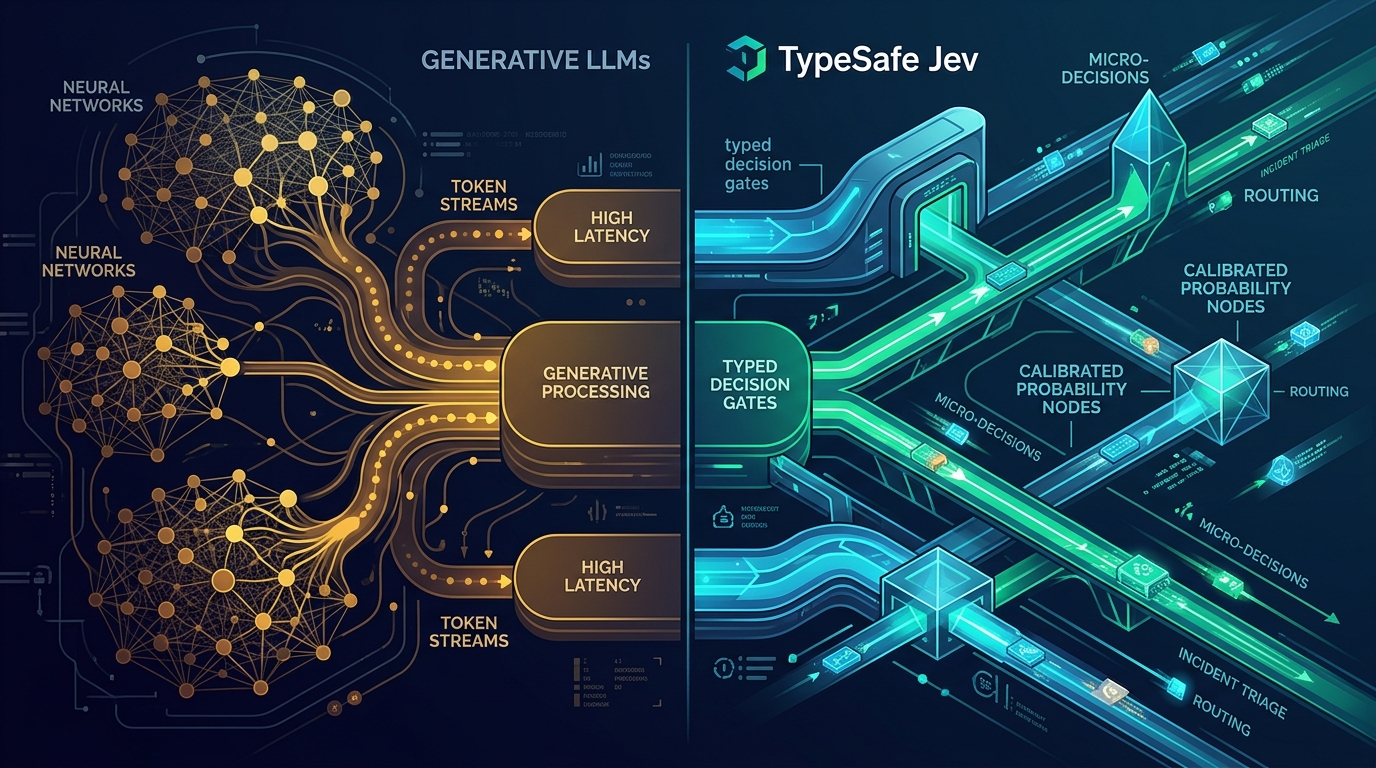
长期以来,AI Agent 的工程实践普遍陷入了“用生成式大模型(LLM)包揽全栈”的单极化陷阱。无论系统面对的是需要深度推理的开放式代码重构,还是仅仅判断“这条 Slack 消息是否需要介入”,开发者往往下意识地把 Prompt 抛给一个参数量达千亿级别的自回归解码器。这种粗放的架构模式,在实验室玩具阶段尚能蒙混过关,但一旦被置于真实、高吞吐的 7x24 小时生产系统面前,就不可避免地撞上了首字延迟(TTFT)不可控、KV Cache 膨胀以及 Token 计费高企的现实铁墙。
DevOps 与自动化运维平台 Polylane 近日公开了一份极具冲击力的真实生产落地报告:他们将其核心 on-call agent 每天成千上万次的高频微决策,从包括 GPT-OSS 20B、GPT-OSS 120B 和 DeepSeek V4.1 Flash 在内的生成式大模型,全量迁移至 TypeSafe AI 推出的决策模型 Jev。实测涵盖 6 万多次线上调用,系统全局 P90 延迟从 4,752 毫秒暴降至 508 毫秒(提速 89.3%),整体调用成本骤降 39.1%。更关键的是,这一案例标志着现代 Agent 系统正从早期的“全盘生成式”演进为快慢分治的“认知双轨制”。
一、高频微决策场景:生成式大模型的“杀鸡用牛刀”
在 Polylane 的全天候 SRE 架构中,其自主运维 Agent 需要实时接管团队的基础设施警报、GitHub Pull Request 评论流以及多频道的 Slack 讨论。为了保证系统不盲目打扰工程师,同时又不在灾难发生时失声,Agent 每天必须做出密集的局部决策:
- 事件路由:面对一条人类刚刚在
#Deployment发送的消息,Agent 到底该静默旁观,还是该立即介入? - 故障聚合:数据库连接池突发报错,它究竟是 14:00 凭证被吊销引发的连带故障,还是完全独立的未解异常?
- 归因分析:为什么十分钟前发出的自动修复(Autofix)PR 被工程师手动关闭了?是修复代码有误,还是问题已经由外部手段解决?
- 拓扑排序:客户云账户中动辄存在数万个实例节点、队列与数据存储,当资源报警时,哪一个是核心业务链路(Critical),哪一个挂了也基本无伤大雅(Minimal)?

在迁移之前,Polylane 为这些判断配置了主流的开源与商用模型(包括 OpenAI GPT-OSS 系列和 DeepSeek V4.1 Flash)。但从工程视角来看,让一个以生成下一词(Next-Token Prediction)为目标的自回归解码器去做三选一或布尔判断,本质上是对计算资源的极大浪费:
- 结构化包裹带来的“JSON 税”:为了让模型输出结构化布尔值,必须在 Prompt 中附带大量的格式规则防御注入,并在推断端挂载 Constrained Decoding(约束解码)或复杂的正则解析器。即便最终只需要一个单字,整个调用链也必须完整走完上下文装载与 KV Cache 解码流程。
- 延迟不可控诱发雪崩效应:在多服务依赖的云架构下,一个故障可能诱发数十条连带事件。如果每次研判都要等待 2 到 5 秒,决策链路将发生严重滞后,甚至造成警报风暴扩散后的二级瘫痪。
- 输出置信度难以真实校准:传统大模型在输出判断时,其输出 Logits 很难直接等同于统计学意义上的真实置信概率。缺乏可信的先验概率,运维系统就很难通过数学阈值来设置安全兜底网关。
二、解构 Jev:不生成文本的“智能 if 语句”
Jev 由 TypeSafe AI 推出,其核心定位不是对话或内容生成模型,而是专门面向结构化数据的 System 1 离散决策引擎。
它在架构设计上最激进的一点在于:彻底剔除了开放式自回归文本生成能力。它的任务并非生成词句,而是针对开发者提供的上下文数据(state)与离散问题(questions),输出确定性极高、带强类型的离散结果与严格校准的概率值。因为不向客户端持续流式发送文本 Token,官方直接将输出 Token 设定为零计费,响应耗时严格收敛在 70 至 500 毫秒区间。

Jev 的协议栈围绕三类核心裁决原语构建:
- Noul 原语(二元决策与概率判定):回答真/假问题,返回
yes的校准概率值(例如 0.87)。这使得开发者可以在业务网关中编写数学条件(例如if (P > 0.8) wake_agent();),彻底摆脱对自然语言文本语气的猜测。 - Choice 原语(受限多分类):从预先定义的 Enum 候选集中挑选最优匹配项,并且支持为每个分类项单独挂载语义评估准则(Criteria)。
- Score 原语(序数阶梯评估):在有序的阶梯评分标尺上,根据概率加权返回期望分值,非常适合做风险定级和模糊排序。
三、三大生产战场落地剖析与指标实测
Polylane 将 Jev 投入生产环境后,在三个最典型的系统瓶颈环节展开了替换对照,采集了数万次真实生产请求的延迟与成本数据。
战场 1:事件路由(Routing —— Agent 何时应当打破沉默?)
在多角色协作的工作区内,Agent 的过度反应会导致人类工程师的严重疲劳,而响应迟钝又会错失故障扑灭时机。Polylane 使用 Jev 的 Noul 原语对 Slack 消息与 GitHub PR 评论流做介入初筛。
例如,当检测到工程师发送了一句指令时,向 Jev 提交的状态与提问结构如下:
{
  "model": "jev-1.13.0",
  "state": {
    "slack_channel": "#Deployment",
    "user_message": "Watch this PR until fully deployed"
  },
  "questions": {
    "respond": {
      "type": "noul",
      "instructions": {
        "question": "Should the agent follow up on this user message?"
      }
    }
  }
}

在此场景下,Jev 与此前部署的 DeepSeek V4.1 Flash 进行了长达一周的对照:
| 评估指标 | DeepSeek V4.1 Flash | TypeSafe Jev | 变化幅度 |
|---|---|---|---|
| P90 响应延迟 | 1,466 ms | 472 ms | 加速 3.1 倍(↓ 67.8%) |
| 每 1,000 次调用成本 | 0.238 美元 | 0.123 美元 | 降幅 48.3% |
系统不仅将响应延迟从近 1.5 秒压入 500 毫秒以内,成本更直接被拦腰斩断。对于需要高频监听的事件过滤网关,这极大地放宽了并发处理的上限。
战场 2:多维分类与证据推断(Evidence Classification)
在此类任务中,Agent 必须根据工具收集到的线索对事故进行性质界定。Polylane 划分了三个独立任务,分别对比了先前的 GPT-OSS 120B 与 DeepSeek V4.1 Flash。

1. 故障跨实体关联(Incident Correlation)
当新的异常产生时,判断其与已有事故是否存在因果纽带。Polylane 将新故障与候选历史故障注入 state,由 Jev 依照预设的语义准则输出分类结果:
{
  "model": "jev-1.13.0",
  "state": {
    "incident": "Checkout cannot authenticate to the database.",
    "candidate_0": "Billing cannot authenticate to the same database.",
    "evidence": "Both services use a credential revoked at 14:00."
  },
  "questions": {
    "candidate_0": {
      "type": "choice",
      "instructions": "How is candidate_0 connected to the new incident?",
      "criteria": {
        "duplicate_same_root_cause": "One underlying problem explains both",
        "related": "Distinct problems share a trigger or blast radius",
        "independent": "No evidenced connection"
      }
    }
  }
}
- 替代对象:GPT-OSS 120B
- P90 延迟:从 2,859 ms 骤降至 373 ms(提升近 8 倍);
- 每千次成本:从 0.388 美元降至 0.285 美元(降低 26.5%)。
2. 未合入 PR 关闭归因(PR Close Attribution)
当系统自动提的 PR 未被合入就关闭时,分析评审意见与相关提交,判断是否是误报、被他人替代或是本就符合预期行为。
- 替代对象:GPT-OSS 120B
- P90 延迟:从 2,379 ms 降至 416 ms(加速 5.7 倍);
- 每千次成本:从 0.123 美元降至 0.102 美元(降低 17.1%)。
3. Autofix 紧急度分级(Autofix Severity)
在将修复建议推给核心开发前,依据影响范围划分 Critical 至 Info 等级。
- 替代对象:DeepSeek V4.1 Flash
- P90 延迟:从 1,456 ms 降至 313 ms(加速 4.7 倍);
- 每千次成本:从 0.197 美元跌至 0.081 美元(降幅高达 58.9%)。
在证据分类这一大类场景下,Jev 实现了全方位的性能碾压:不仅消除了千亿模型慢吞吞的解码等待,更让每一分算力成本都落在了明确的业务逻辑上。
战场 3:云资源拓扑图优先级排序(Context Graph Prioritization)
如果说前两项场景证明了 Jev 的速度,那么这一场景则直接构成了 Polylane 整体账单下降的绝对主力。
大型企业客户的云平台通常包含数万个跨微服务的计算节点、数据库实例与消息队列。Polylane 会为全量资产构建上下文图谱(Context Graph)。为了在风暴来临时优先保全命脉,系统必须根据每个节点的运行指标、环境标签与下游依赖拓扑,给每个资产动态打上权重(Critical、Standard、Low、Minimal)。
{
  "model": "jev-1.13.0",
  "state": {
    "instructions": "Assign importance relative to the other resources in this cohort.",
    "cohort": [
      {
        "id": "database-a",
        "environment": "production",
        "daily_queries": 80000,
        "dependents": 6
      },
      {
        "id": "database-b",
        "environment": "preview",
        "daily_queries": 0,
        "dependents": 0
      }
    ]
  },
  "questions": {
    "resource_0": {
      "type": "choice",
      "instructions": "Assign the importance tier for database-a.",
      "criteria": {
        "1": "Critical: substantial production traffic or blast radius",
        "2": "Standard: active and operationally relevant",
        "3": "Low: limited activity or importance",
        "4": "Minimal: idle or disposable, without meaningful dependents"
      }
    }
  }
}

由于这是 Polylane 调用频次最高、吞吐量最大的后台常驻任务,以往使用的 GPT-OSS 20B 经常因并发队列积压导致延迟飙升。迁移至 Jev 后的测试数据如下:
| 评估指标 | OpenAI GPT-OSS 20B | TypeSafe Jev | 变化幅度 |
|---|---|---|---|
| P90 响应延迟 | 5,445 ms | 511 ms | 加速 10.6 倍(↓ 90.6%) |
| 每 1,000 次调用成本 | 0.817 美元 | 0.542 美元 | 降幅 33.7% |
耗时从超过 5.4 秒的慢查询直接缩减至半秒,使得全量图拓扑重排的吞吐效率提升了一个数量级,同时由于调用基数巨大,直接拉动了整站成本的大盘下挫。
四、60,000+ 次生产调用全景复盘
在 2026 年 9 月 20 日至 9 月 24 日的连续追踪周期内,Polylane 沉淀了 36,664 次 LLM 生产调用 与 23,951 次 Jev 生产调用 的全量对照记录。宏观综合表现呈现出极为清晰的收敛特征:
| 生产大盘全量指标 | 传统 LLM 混合编排 | 全面切入 Jev 裁决 | 最终提升效能 |
|---|---|---|---|
| 全系统 P90 延迟 | 4,752 ms | 508 ms | 整体提速 89.3%(约 9.4 倍) |
| 平均千次调用成本 | 0.76199 美元 | 0.46369 美元 | 纯成本节省 39.1% |
横向拉通四个涉及的模型维度,Jev 展现出了绝对的综合优势:

- OpenAI GPT-OSS 20B:P90 延迟 5,445 ms,每千次 0.82 美元。模型容量虽小,但由于其结构对于受限分类缺乏优化,长尾延迟极为严重。
- OpenAI GPT-OSS 120B:P90 延迟 2,255 ms,每千次 0.74 美元。参数量带来了一定泛化度,但延迟依然在两秒以上,计费昂贵。
- DeepSeek V4.1 Flash:P90 延迟 1,372 ms,每千次 0.51 美元。在传统生成式大模型中极具性价比,但在纯分类任务上仍不及专精决策模型。
- TypeSafe AI Jev:P90 延迟 508 ms,每千次 0.46 美元。在同场竞技中夺得了速度最快、综合单价最低的双料冠军。
五、架构启示:Agent 认知系统的“快慢双轨”分化
Polylane 的这次生产替换,绝不仅是一次常规的技术栈降本增效,它在系统架构层面印证了一个正在发生的底层范式跃迁:Agent 的认知管线正在遵循人类认知科学,演变为双轨分治结构。
认知心理学家丹尼尔·卡尼曼在《思考,快与慢》中揭示,人类的大脑包含两套系统:
- System 1(快系统):自主、快速、近乎本能直觉,不消耗显式精力;
- System 2(慢系统):深思熟虑、逻辑推演、高度耗费注意力。
以往的 Agent 开发者们试图直接让基于 Auto-regressive Transformer 的生成式大模型担当所有的认知负荷——相当于一个人连眨眼、躲避障碍物或判断是否抬头,都需要强迫自己调动前额叶写出一篇严密的论证小论文。这不仅极其笨拙,而且极其脆弱。

在由 Jev 与生成式大模型协同构建的下一代现代 Agent 架构中,系统具备了明确的分工界面:
- 确定性高频微决策下沉:只要上下文是结构化的、选项集合是有限且封闭的、目标只需要明确分类或真假判定的任务,坚决由 Jev 这一类 System 1 决策模型在 500ms 内就地解决,消灭格式幻觉,阻断无意义的 Token 消耗;
- 生成式大模型专注复杂长程推理:只有当 System 1 的裁决结果显示出现未知异动、需要跨系统编写修复补丁、或者需要为人类撰写翔实的事故复盘(Post-mortem)报告时,系统才将全量上下文升舱移交给 System 2(例如 Claude 3.7 Sonnet 或 DeepSeek Reasoner)进行深度生成。
当大模型的“生成自由”在不需要它的场景被果断收回,AI Agent 才能真正走出概念演示的温室,在严苛的生产环境中兼顾闪电般的响应敏捷度与坚固的工程确定性。