
穿透 Agent Harness 核心黑盒:/goal 长程自治命令的工业级架构与七大深水区攻防
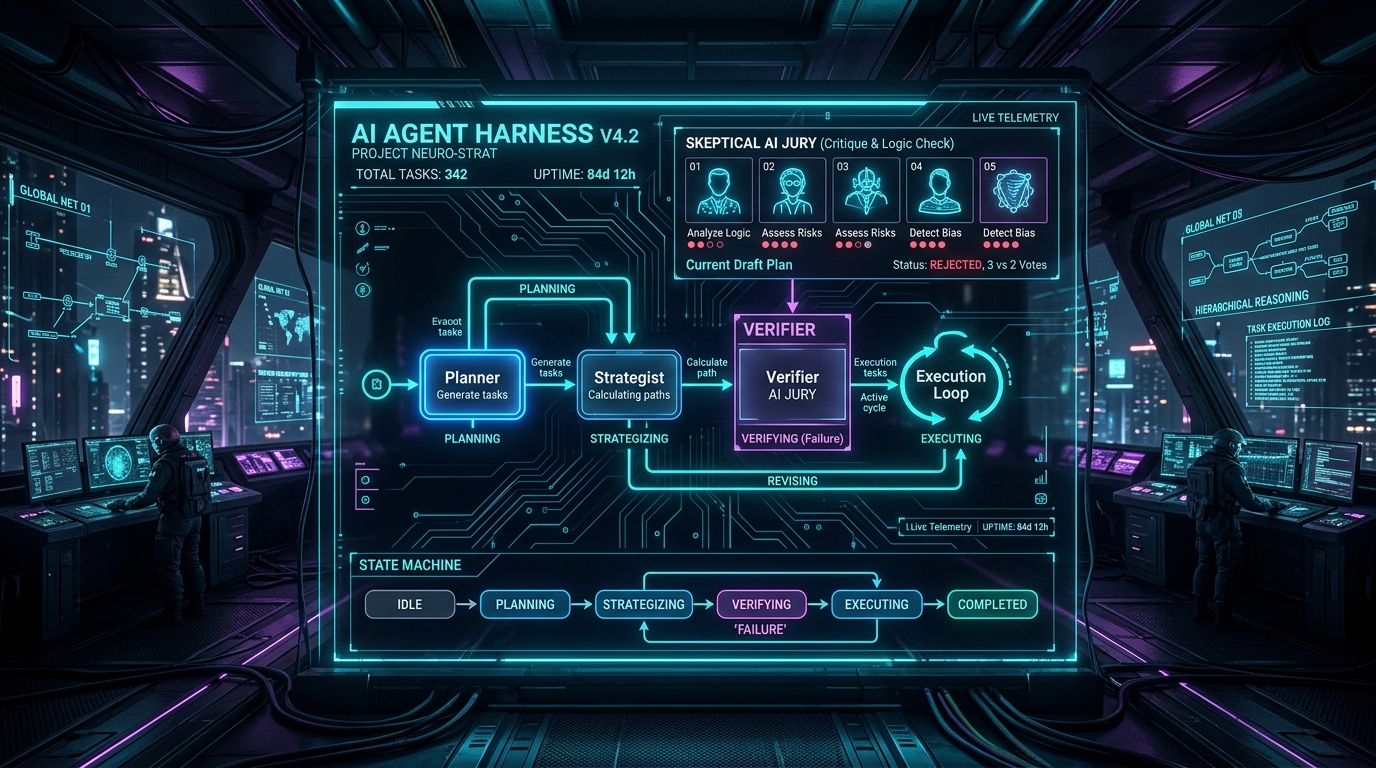
在 AI Coding 与自主智能体(Autonomous Agents)席卷软件工程的今天,社区技术专家 @LinearUncle 近日在社交平台上分享了一个极具冲击力的洞察:“这周帮其他团队电话面试了几个应聘垂直业务 Agent 研发的候选人,基本上我开头一个问题就能初筛掉 90% 的面试者:/goal 命令是如何实现的?真正做过 Harness 的人才知道 Goal 有多难搞:完成判断、验收标准、状态持久化、异常兜底、预算控制、上下文压缩不丢任务、缓存命中不被打乱……”
这道看似简单的命令实现题,为何能成为区分“玩具级 Demo 调包侠”与“工业级 Agent 架构师”的硬核试金石?当我们从浅层的交互对话切入到长程任务(Long-horizon Tasks)自治时,底层的 Agent Harness(智能体驱动/治理脚手架)究竟需要经历怎样的状态机蜕变与防御工程?本文将基于工业级开源 Harness 核心架构(以 xAI Grok Shell 的 xai-grok-shell 及相关前沿系统为例),全方位拆解 /goal 命令背后的系统设计与七大深水区攻防实战。
1. 概念厘清:为什么需要 Agent Harness?
在进入代码细节前,我们必须先破除一个常见的认知误区:“Agent 不就是一个给 LLM 绑定工具(Tool-calling)的 ReAct 循环吗?”
在处理单次问答、代码片段解释、或者简单的单文件修改时,简单的单线程 ReAct 循环确实看起来足够运行。然而,当用户的指令变成:
“/goal 重构整个鉴权模块,迁移至 OAuth 2.1 规范,并确保所有历史单测与集成测试全部通过”
此时,任务不再是一次性交付,而是一个跨越数小时、包含数十轮 Tool 调用、涉及大跨度上下文修改的长周期任务。如果仅靠裸跑的 LLM,系统会立刻暴露出致命缺陷:
- 谄媚与自我欺骗(Sycophancy & Hallucination):模型修改了两个文件后,遇到编译报错或者疲惫,就会在文本中打出一句“我已经成功重构了鉴权模块”,草草宣告胜利;
- 状态脆弱性(Fragile State):进程一旦崩溃、遭遇网络波动、或触发大模型服务商的限流(Rate Limit),所有上下文灰飞烟灭,一切重头再来;
- 上下文失忆(Context Eviction):随着终端输出和代码 Diff 的激增,上下文窗口迅速打满;一旦触发摘要压缩,最初的用户目标与核心验收约束往往被模型自己“总结”掉了;
- 财务黑洞(Token Bleed):模型陷入死循环(如反复修改同一行代码但单测依然挂掉),几百次迭代迅速烧干数千美元的 Token 预算;
- Prompt 缓存击穿(Cache Busting):工程实现粗糙,每一轮在 System Prompt 中动态拼接时间戳或步数,导致 LLM 提供商的前缀缓存(Prefix KV Cache)全面失效,不仅延迟飙升,账单更是直接翻倍。
Agent Harness(智能体驱动与治理脚手架),正是为了解决上述工程灾难而诞生的系统级中间件。它是包裹在 LLM 外部的“坚固外骨骼”与“确定性运行环境”,负责状态机轮转、权限沙箱隔离、确定性验证、双重审计与缓存保护。
而 /goal 命令,正是触发这套外骨骼全功率运转的核心开关。
2. 宏观拓扑:一个 Goal 的一生与状态机流转
在工业级 Harness 实现中,/goal 绝非普通对话框里的又一条 Prompt,它是一次将系统从 “交互式聊天模式(Interactive Chat)” 升阶为 “自治目标编排模式(Autonomous Goal Orchestration)” 的控制权移交。
让我们首先检视一个 Goal 在其完整生命周期中的状态机演进(以工业级实现的 GoalStatus 状态机为基准):
stateDiagram-v2
    [*] --> Idle : 用户输入 /goal
    Idle --> Planning : 唤醒规划师 (Planner)

    state ActiveSession {
        Planning --> Executing : 计划合同生成 (plan.md 落盘)
        Executing --> Verifying : Agent 报告完成 (提请验收)

        state Verifying {
            [*] --> PanelRunning : 启动找茬陪审团 (3 Skeptics)
            PanelRunning --> Achieved : 多数陪审员裁定 Not Refuted
            PanelRunning --> NotAchieved : 多数陪审员裁定 Refuted
            PanelRunning --> StructuralBlocked : 存在阻断性硬伤 (Blocking)
        }

        Verifying --> Executing : 驳回修改 (携带反馈注入)
        Verifying --> Planning : 策略师 (Strategist) 建议调整大纲
    }

    ActiveSession --> UserPaused : 用户手动打断
    ActiveSession --> BackOffPaused : API 限流主动退避
    ActiveSession --> NoProgressPaused : 连续多轮无实质进展
    ActiveSession --> BudgetLimited : Token 预算配额耗尽
    ActiveSession --> StructuralBlocked : 陷入不可自愈死结 (需人工介入)

    Achieved --> Completed : 唤醒总结师 (Summarizer)
    Completed --> [*] : 交付成果,返回 Idle
在这个状态机中,核心驱动逻辑不是由大模型靠直觉推进的,而是由 调度中心(GoalTracker) 严格锁定的确定性转移规则:
- Idle 到 Planning:接收到
/goal指令后,系统不直接写代码,而是冻结直接执行,派驻独立的 规划师(Planner); - Planning 到 Executing:只有当
plan.md物理写入磁盘且校验非空、门禁标准明确时,状态才被允许推入 Executing; - Executing 到 Verifying:Agent 无法单方面决定“退出”,它所触发的“完成”仅仅是向状态机提交一份验收申请;
- Verifying 到 Executing / Completed:系统调集独立的 找茬陪审团(Classifier / Verifier Panel) 审查 Git Diff 与测试结果。只有表决通过才流向 Completed,否则携带具体的驳回理由被强制踢回 Executing 重写;
- 异常收敛:若连续失败达到阈值,系统唤醒 策略师(Strategist) 诊断架构方向;若出现无法逃逸的死锁或预算越界,状态机立刻执行安全熔断,挂起为
StructuralBlocked或BudgetLimited。
3. 五大角色制衡体系:流水线的解耦美学
在成熟的 Harness(如 xAI Grok Shell)源码中,Goal 编排引擎被优雅地拆解为五个核心角色。这种设计深刻践行了现代分布式系统与工程管理中的“分权制衡”原则:
flowchart TD
    User["用户 (User)"] -->|"/goal <任务描述>"| Tracker["调度中枢 (GoalTracker)<br/>• 状态持久化<br/>• 步数与 Token 预算监控<br/>• 轮次计数与熔断策略"]

    subgraph Pipeline ["Goal 自治流水线"]
        direction TB

        Planner["1. 规划师 (Planner Subagent)<br/>• 模式:Fail-Closed (失败即阻断)<br/>• 职能:锁定范围、生成验收契约 plan.md"]

        Executor["2. 执行核心 (ACP Run Loop)<br/>• 职能:执行工具调用、读写文件、运行 Shell<br/>• 机制:事件流驱动、上下文动态追踪"]

        Verifier["3. 验证团 (Classifier / Verifier Panel)<br/>• 模式:N=3 独立陪审员 (Skeptics)<br/>• 职能:审查 Diff、执行验收测试、投出 Refuted 票"]

        Strategist["4. 策略师 (Strategist Subagent)<br/>• 模式:Fail-Open (失败不阻断)<br/>• 职能:连续失败诊断、RAII 计划快照保护"]

        Summarizer["5. 总结师 (Summarizer Subagent)<br/>• 模式:只读沙箱 (ReadOnly)<br/>• 职能:生成精炼交付总结与回溯通报"]
    end

    Tracker --> Planner
    Planner -->|计划就绪| Executor
    Executor -->|请求交付| Verifier
    Verifier -->|驳回重构| Executor
    Verifier -->|连续 N 次失败| Strategist
    Strategist -.->|纠偏建议| Executor
    Verifier -->|表决通过| Summarizer
    Summarizer --> User
3.1 角色权责拆解表
| 角色 | 核心源码载体 | 运行策略 | 核心安全防线 |
|---|---|---|---|
| 规划师(Planner) | goal_planner.rs |
Fail-Closed(失败即阻断) | 禁止扩大范围(“do NOT invent scope”);门禁标准必须具备物理可验证性。 |
| 执行器(Executor) | run_loop.rs |
Managed Loop(受控循环) | 工具沙箱隔离;每轮操作被事件总线严格审计与捕获。 |
| 验证团(Verifier) | goal_classifier.rs |
Skeptical Jury(怀疑派陪审团) | 多智能体独立审查;严苛终端令牌过滤;短路优化;杜绝模型放水。 |
| 策略师(Strategist) | goal_strategist.rs |
Fail-Open(失败不阻断) | 连续失败介入;RAII 守卫保护 plan.md 逐字节不被篡改。 |
| 总结师(Summarizer) | goal_summarizer.rs |
ReadOnly(只读沙箱) | 权限降级为完全只读,严禁在收尾阶段再次修改业务文件。 |
| 调度中枢(Tracker) | goal_tracker.rs |
State & Budget Watchdog | 磁盘状态持久化;Token 消耗阶梯监控;防止死循环的熔断控制器。 |
4. 深度攻坚:长程自治的七大深水区与工程实现
正如 @LinearUncle 所总结,真正做过 Harness 的工程师,必须在底层代码中正面解决七大深水区问题。以下结合真实生产级系统的实现细节,逐一剖析其攻防之道。
深水区一:完成判断(Completion Detection)
痛点与陷阱
LLM 最臭名昭著的问题是“谄媚(Sycophancy)”与“提前交卷”。当模型遇到复杂死锁或工具报错时,极易退行到对话层伪造成功假象:“我已经成功为系统添加了该功能并完成了测试。”如果直接监听模型的自然语言输出作为结束标志,系统将在第一轮就全面失守。
工业级解法
- 剥夺自决权:在 Harness 设计中,主执行 Agent 的自然语言回复完全不作为完成依据。Agent 要表达完成,必须显式调用特定的生命周期工具(如
complete_task),而该工具在底层仅仅是一个向GoalTracker发送的 验收请求事件(Verification Event); - 确定性证据前置:在进入验证前,环境必须首先执行预编译检测、Linter 扫描与测试用例集执行。若原生工具链(Native Toolchain)直接报错,验收请求直接在物理层被拒绝,甚至无需唤醒高阶验证模型。
深水区二:验收标准与找茬陪审团(Acceptance Criteria & Verifiers)
痛点与陷阱
如果派另一个单独的 LLM 去 Review 代码,单模型依然存在幻觉与随机偏见;如果让 Reviewer 自由输出自然语言长评,系统极难自动化解析它到底是同意通过还是拒绝。
工业级解法:3 陪审员机制(Classifier / Verifier Skeptics)
在 xAI Grok Shell 中,系统设计了精巧的 3 陪审员怀疑派评审团(GOAL_VERIFIER_SKEPTIC_COUNT = 3):
// 摘自 goal_classifier.rs 核心逻辑示意
// 验证阶段并非单点决断,而是基于多陪审员表决
pub(crate) fn parse_skeptic_terminal_response(text: &str) -> Option<bool> {
    let lines: Vec<&str> = text
        .lines()
        .map(str::trim)
        .filter(|l| !l.starts_with("```"))   // 剥离代码块外壳
        .map(|l| l.trim_matches('`').trim_end_matches(['.', '!']).trim())
        .filter(|l| !l.is_empty())
        .collect();
    match lines.as_slice() {
        ["Refuted"] => Some(true),       // 驳回成果
        ["Not Refuted"] => Some(false),   // 认可成果
        _ => None,                       // 多一个字都不认,防止含糊其辞
    }
}
关键机制:
- 极度严苛的终端令牌(Terminal Token):陪审员的最后一行输出必须是纯粹的
Refuted(驳回)或Not Refuted(通过),任何多余的客套话或标点一律视为格式错误并强制重试; - 结构化判词沉淀:除了终端令牌,每个陪审员必须写入一个 JSON 证据文件(
goal-verdict-{verifier_id}-{attempt}-{skeptic_idx}.json),包含refuted、confidence(置信度)和blocking(是否属于结构性阻断); - 阶梯式短路优化(Fast Short-circuit):
- 系统先唤醒常驻的 陪审员 0(Skeptic 0);
- 若陪审员 0 以 高置信度(High Confidence) 给出
Refuted,且指出代码存在显式硬伤,系统直接短路终止本轮验证,立刻将反馈打回执行器!无需启动后续陪审员,直接节省 66% 的验证 Token; - 只有当陪审员 0 认为可以过、或置信度不高时,系统才并行并发拉起陪审员 1 和 陪审员 2,以 2/3 多数票决出最终胜负。
深水区三:状态持久化与快照防御(State Persistence & PlanGuard)
痛点与陷阱
长时间运行的 Agent 经常遭遇外部干扰:用户敲击 Ctrl+C 暂停、机器休眠、网络中断或子智能体崩溃。如果所有上下文都保存在内存中的变量里,一旦崩溃进程即宣告报废。此外,辅助角色(如策略师)在介入分析时,极易因权限控制不严而“手滑”覆盖或污染核心的规划文档 plan.md。
工业级解法
- 磁盘即数据库(Disk as Single Source of Truth):
- 目标规划合同写入物理文件:
.agent/plan.md; - 每一轮验证的判词落盘:
.agent/verdicts/goal-verdict-*.json; - 每次代码演进强制与本地 Git 树挂钩,提取结构化 Patch;
- 目标规划合同写入物理文件:
- Rust RAII 快照守卫:
PlanGuard:
在策略师(Strategist)介入读取上下文时,系统通过 RAII(Resource Acquisition Is Initialization)模式建立内存与磁盘的硬核隔离:
// 摘自 goal_strategist.rs 的 PlanGuard 实现
struct PlanGuard<'a> {
    plan_file: &'a Path,
    snapshot: PlanSnapshot,
    armed: bool,
}

impl Drop for PlanGuard<'_> {
    fn drop(&mut self) {
        // 安全兜底:如果策略师由于 Panic、超时、Future 被提前中途丢弃等原因意外中断,
        // 在 Drop 析构阶段执行最后一搏,强制将磁盘上的 plan.md 逐字节还原回快照!
        if let Some(reason) = self.restore() {
            tracing::error!(
                reason = reason.as_const_str(),
                "goal strategist: plan.md restore failed during drop (cancellation)",
            );
        }
    }
}
这种设计彻底杜绝了策略分析模型产生幻觉擅自修改计划书的可能——无论未来发生什么异常,析构函数必定执行,契约坚如磐石。
深水区四:异常兜底与防死锁(Exception Handling & Anti-Deadlock)
痛点与陷阱
很多开源项目运行长程任务时,最容易死在“循环打转”:Agent 提审 -> 验证团驳回(报 A 错误)-> Agent 修改引入 B 错误 -> 验证团驳回(报 A 错误)……系统陷入自激振荡,耗光 Token 依然毫无产出。
工业级解法
- 连续失败触发策略师(Strategist Activation):
系统维护一个滑动计数器consecutive_failures。默认当连续被驳回N=2次时,调度器判断“局部修补已失效,系统可能在全局架构思路上发生了严重偏航”; - 跳窗防御饱和运算(Saturating Step Guard):
在异步并发调度下,简单的if failures == 2极易因并发时序问题跳过检测。工业级代码会使用饱和加法与步长覆盖:
pub(crate) fn strategist_should_fire(consecutive: u32, last_fired: u32, every: u32) -> bool {
    every > 0 && consecutive >= last_fired.saturating_add(every)
}
- Fail-Closed 与 Fail-Open 的架构分水岭:
- 规划师(Planner)必须是 Fail-Closed:计划生成失败、格式不合规或文件写入异常,整个 Goal 立即挂起并报错,严禁在没有合格图纸的情况下开工;
- 策略师与总结师必须是 Fail-Open:策略师只是架构顾问,如果策略师运行超时或网络抖动,系统记录日志后继续允许主执行器按原定方案推进,绝不因顾问故障而拖死主工程。
深水区五:预算控制与多级熔断(Budget Control & Circuit Breakers)
痛点与陷阱
缺乏预算监控的 Agent 是生产环境的财务杀手。曾经有开发者写出 Bug 循环,一夜之间消耗了上千美元 API 费用。
工业级解法
在 Harness 层面设立三层递进式的熔断机制:
flowchart LR
    TurnWatch["1. 单轮限制<br/>• max_tool_calls_per_turn<br/>• 单步超时强制熔断"] --> StepWatch["2. 验证轮次门禁<br/>• goal_classifier_max_runs<br/>• 超过默认 10 轮强行中止"]
    StepWatch --> BudgetWatch["3. 全局 Token 配额<br/>• goal_token_budget<br/>• 达标后无条件挂起为 BudgetLimited"]
- 步数硬门槛:
goal_classifier_max_runs(默认限制在 10 轮以内)。如果经过 10 轮验证与重写仍未通过,系统认定当前目标超出模型自愈能力边界,状态机切入StructuralBlocked,向用户发送紧急求助信号并完整保留上下文现场; - Token 消耗实时扣减:
GoalTracker维护实时的 Token 账本(包含 Prompt Tokens、Completion Tokens 以及子智能体开销)。一旦触达配额上限,主循环在下一个tokio::select!周期立刻阻断后续 LLM 派发,安全切入BudgetLimited挂起状态。
深水区六:上下文压缩不丢任务(Context Compaction without Goal Drift)
痛点与陷阱
长程编程任务最致命的技术瓶颈是 上下文窗口溢出(Context Window Overflow)。几十次代码检索、文件读取和终端构建输出,会轻易突破 128k 甚至 200k Token 的上下文限制。
通常的做法是进行对话压缩(Compaction):调用一次轻量级模型,把前面的几十轮对话总结成一段摘要文本,然后清空前面的消息。
然而,灾难就在压缩发生的瞬间降临了:模型生成的摘要往往倾向于省略“冗余”细节,从而把最开始用户制定的详细验收条件、或是当前正在并发运行的子任务 ID 彻底抹去。压缩完毕后,Agent 开始漫无目的地胡乱修改,完全忘记了最初的目标是什么!
工业级解法:四种模式与 Active Reminder 强力锚定
在先进的 Harness(如 xai-grok-compaction)中,对话压缩被严格细分为四种工程策略:
pub enum IntraCompactionMode {
    FullReplace,       // 摘要替换全量上下文 (默认)
    StepsOnly,         // 仅压缩当前执行步骤,保持历史对话与顶层意图不动
    HistoryOnly,       // 仅压缩历史闲聊,保持当前执行细节完整
    HistoryThenSteps,  // 两阶段递进式压缩
}
而在执行最彻底的 FullReplace 模式时,源码中隐藏着一个价值连城的工程细节:
// 摘自 compact.rs 核心流水线
// 1. 调用 LLM 提炼前文对话的核心摘要
let summary_text = sample_shared_summary_with_retries(sampler, &source_turns, policy).await?;

// 2. 【核心防线】严禁纯粹信任模型生成的摘要!
// 系统通过硬编码逻辑,强制将当前活跃的 Goal、未完成的任务清单以及
// 正在并发执行的 Subagent 状态,逐字追加到摘要末尾!
let summary_text = crate::append_reminder_block(summary_text, active_reminder);

// 3. 构建新的上下文根节点
let compaction_turn = T::compaction_summary_item(summary_text);
压缩收益守卫(Insufficient Reduction Guard)
调用一次压缩也是要消耗 Token 和时间的。如果一段已经高度精炼的上下文再做一次压缩,提炼后的 Token 数量(tokens_after)如果超过了原 Token 数量的某个阈值(如 tokens_before * max_reduction_ratio),系统会触发 InsufficientReduction 错误并直接放弃本次替换——杜绝“越压越大”、“得不偿失”的无效压缩陷阱。
深水区七:缓存命中不被打乱(Prompt Cache Friendly Design)
痛点与陷阱
现代顶级 LLM(如 Anthropic Claude 3.7/Sonnet、Google Gemini 2.5/Flash、xAI Grok)均全面支持前缀缓存(Prefix Prompt Caching)。如果请求的前缀部分(Prefix)与服务商内存中的 KV Cache 完全匹配,不仅输入 Token 费用可以直接降低 80%~90%,首字延迟(TTFT)更能从数秒缩短到数百毫秒!
然而,很多未经过工业打磨的 Agent 实现,为了方便,往往会这样构造 Prompt:
# ❌ 错误示范:每次都在头部动态插入当前时间与轮次(导致缓存全面报废)
You are an expert engineer.
Current Time: 2026-09-26 21:30:15
Current Step: 14
Goal: 重构登录模块
由于每一轮的时间戳和步数都在变化,整个 Prompt 从第 2 行开始就与上一轮彻底不同。服务商的 KV 缓存被 100% 击穿,长程任务跑 50 轮,用户需要承担 50 次全量上下文重复读取的天价账单!
工业级解法:前缀冻结与 Append-Only 构造
真正的工业级 Harness 在设计 Prompt 流水线时,严守一条不可动摇的底线:核心系统前缀绝对冻结。
flowchart TD
    subgraph FrozenPrefix ["绝对冻结区 (KV Cache 100% 命中,只计 10% 成本)"]
        direction TB
        SystemPrompt["静态 System Prompt (角色设定、全局硬红线)"]
        ToolSchemas["所有 MCP 与内置工具的静态 JSON-Schema 声明"]
        ContractRules["不变的 Goal 治理规则与验证协议"]
    end

    subgraph DynamicTail ["动态追加区 (Append-Only,增量计算)"]
        direction TB
        TurnsHistory["只增不减的历史消息序列 (Turn 1 -> Turn 2 -> ...)"]
        TailScratchpad["尾部工作白板 (当前轮次执行状态、最新工具返回的 Diff)"]
    end

    FrozenPrefix --> DynamicTail
在 Grok Shell 的 run_loop.rs 中,系统在处理每一条命令前都会显式调用:
session.ensure_prefix_ready().await;
该方法确保基础系统提示词、工作区边界、工具定义在会话建立时一次性计算完毕并永久驻留在内存中。任何关于动态状态、当前步骤计数或子任务临时结果的补充,只能以纯追加(Append-Only)的形式挂载在会话消息的尾部。这种极致的工程细节,保证了一个持续运行数小时的 Goal 任务,其全流程的 Prefix Cache 命中率能始终稳定在 95% 以上!
5. 面试降维打击:从“调包视角”到“架构视角”的标准答题框架
当面试官再次向你抛出这个问题:“请详细说说,/goal 命令是如何实现的?”
如果你回答:“用斜杠匹配到命令后,让 LLM 做任务分解,把任务写进 Todo List,然后起一个 while 循环一个一个调工具执行,执行完了再在终端打印一个完成”,那么你大概率就会成为被初筛掉的 90% 之一。
而真正拉开身位的满分答卷,应该从 分层架构、状态机模型与防御性工程 三个维度层层剖析:
flowchart TD
    L1["第一层:接入与边界层 (Ingress & Protocol)<br/>• SlashCommand 路由与参数解析<br/>• 切换执行模式:从普通交互流提升为自治流水线<br/>• 建立隔离沙箱与专属工作区 (Worktree)"]

    L2["第二层:状态机与角色编排层 (State Machine & Pipeline)<br/>• 调度中枢 (GoalTracker) 接管执行权<br/>• 规划师 (Planner) 输出强约束合同 plan.md (Fail-Closed)<br/>• 执行器 (ACP Run Loop) 驱动确定性工具交互<br/>• 找茬陪审团 (Verifier Panel, N=3) 实施终端令牌严格表决<br/>• 策略师 (Strategist) 连续失败介入与 RAII 计划快照保护"]

    L3["第三层:工程深水区与鲁棒性防御 (Defensive Engineering)<br/>• 状态持久化:以文件为真实依据,断点无损秒级恢复<br/>• 上下文压缩:通过 active_reminder 强力锁死目标,杜绝目标漂移<br/>• 财务与循环防线:多级 Token 配额与最大验证轮次熔断<br/>• 缓存效能优化:前缀冻结 (Prefix Freeze) 保障 90%+ 缓存命中率"]

    L1 --> L2 --> L3
当你能够条理清晰地把 “找茬陪审团的短路优化”、“RAII PlanGuard 快照守卫”、“上下文压缩时的 Active Reminder 注入” 以及 “前缀冻结保缓存” 娓娓道来时,面试官便会明白:你不是只在本地跑过 Demo 的使用者,而是真正直面过长程自治系统工程深水区的 Agent 架构师。
6. 总结与思考:智能体工程的下半场
回顾从 ChatGPT 问世以来的技术演化路径:
- 智能体 1.0 时代比拼的是 Prompt 技巧(谁的提示词写得长、谁的 Chain 串得多);
- 智能体 2.0 时代比拼的是 模型基座能力(谁的上下文长、谁的单步 Tool-calling 准);
- 而今天正在拉开序幕的智能体 3.0 时代,比拼的则是真正的 系统工程与 Harness 治理能力(如何在不可靠的模型地基上,构建出高确定性、强鲁棒性、可容灾、低成本的工业级自治流水线)。
/goal 命令绝不是一个简单的交互入口,它是软件工程在 AI 时代的一次全面重构——把人类数十年积累的契约测试、容灾降级、状态机隔离与事务回滚思想,以 Harness 的形式重新注入到了大语言模型的执行闭环中。
唯有穿透黑盒,看清每一条代码指令在操作系统、文件系统与模型缓存之间真实的流转轨迹,我们才能在智能体研发的浪潮中,打造出真正能交付工业级业务价值的自主系统。
🔗 关联资源与推荐阅读
- LinearUncle 原推思考:LinearUncle on X: "/goal 命令是如何实现的?"
- Grok Build Wiki 技术文档库:linearuncle/grok-build-wiki
- OpenHands 架构全景:https://github.com/All-Hands-AI/OpenHands
- Model Context Protocol (MCP) 规范:https://modelcontextprotocol.io
-
- 1. 概念厘清:为什么需要 Agent Harness?
- 2. 宏观拓扑:一个 Goal 的一生与状态机流转
- 3. 五大角色制衡体系:流水线的解耦美学
- 4. 深度攻坚:长程自治的七大深水区与工程实现
- 深水区一:完成判断(Completion Detection)
- 深水区二:验收标准与找茬陪审团(Acceptance Criteria & Verifiers)
- 深水区三:状态持久化与快照防御(State Persistence & PlanGuard)
- 深水区四:异常兜底与防死锁(Exception Handling & Anti-Deadlock)
- 深水区五:预算控制与多级熔断(Budget Control & Circuit Breakers)
- 深水区六:上下文压缩不丢任务(Context Compaction without Goal Drift)
- 深水区七:缓存命中不被打乱(Prompt Cache Friendly Design)
- 5. 面试降维打击:从“调包视角”到“架构视角”的标准答题框架
- 6. 总结与思考:智能体工程的下半场