
零图训练却长出视觉反射弧:解密 JEV-27B-VL 单次前向多模态决策、双系统协同与短视频冷启动实证
在多模态大模型的传统认知中,让模型“看得懂图片并做出靠谱判断”,必须依赖以亿为单位的图文对进行高昂的对比学习或多模态指令微调。然而,开源社区最新释出的 autotrust/JEV-27B-VL 却带来了一个极具冲击力的反直觉范式:它的离散决策头在整个训练周期内从未接触过一张图片,却能在零样本视觉决策、短视频封面推荐以及网页 Agent 终态裁判等硬核场景中,全面超越甚至碾压经过专门训练的专业级多模态模型。
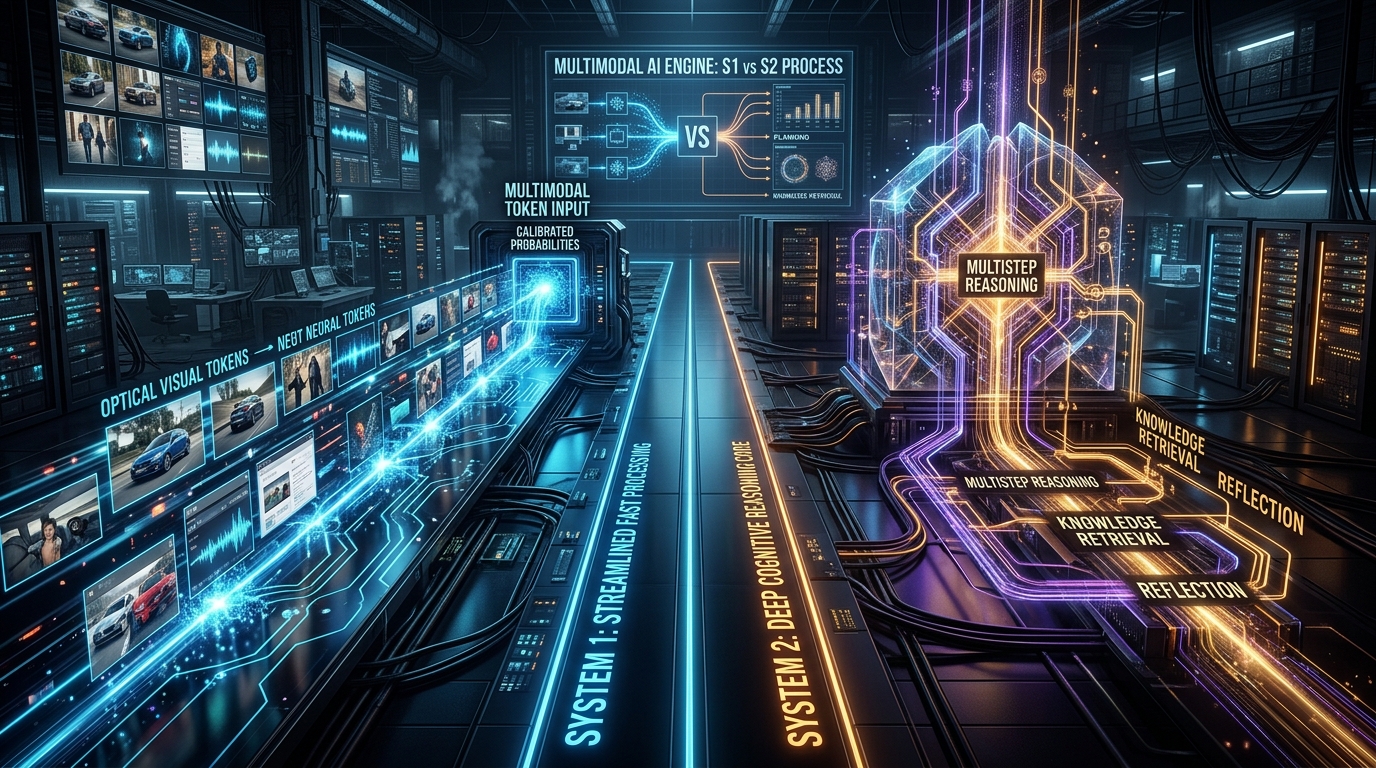
这一成果揭示了大模型底层表征的深层同构性。通过将纯文本非自回归决策引擎与 Qwen3.8-27B 视觉底座深度缝合,JEV-27B-VL 成功构建出兼具“单次前向极速感知(System 1)”与“深度自回归慢思考(System 2)”的统一异构引擎。本文将从底层权重嫁接手术、数学级概率校准、短视频冷启动实证、Agent 轨迹裁判到 vLLM 私有化部署踩坑,对该模型进行全方位的架构拆解与工程实战复盘。
一、 架构反常识:为什么零图片训练的决策头,能直接读懂视觉画面?
在主流多模态模型(如 CLIP、SigLIP、LLaVA 系列)的演进路径中,视觉与文本跨模态对齐通常需要两个重型阶段:先通过海量图像-文本对训练投影视觉特征的投影层(Projector),再通过图文对话数据微调整个语言模型骨干。
但当翻阅 autotrust/JEV-27B-VL 的开源实现与权重构造脚本时,会发现一个极具反常识的工程事实:它的决策头(Decision Head)与 LoRA 适配层,全部来自于此前发布的纯文本模型 JEV-27B,在训练阶段纯靠文本意图数据蒸馏而成,视觉训练数据量严格为零。
这样一套纯文本架构,究竟是如何瞬间“长出眼睛”的?
flowchart TB
    subgraph Inputs["多模态输入流 (Multimodal Inputs)"]
        Img["输入图片 / 视频封面 / 网页截图"]
        Txt["结构化状态 (State) + 决策问题 (Question) + 候选选项 (Options)"]
    end

    subgraph Encoders["底层编码与对齐层"]
        ViT["视觉编码器 (Vision Transformer)"]
        Emb["文本 Token 嵌入层 (Embedding)"]
    end

    subgraph Backbone["Qwen3.8-27B 语言模型骨干 (Language Model Backbone)"]
        VTokens["视觉前缀 Tokens (Visual Patches)"]
        TTokens["文本上下文 Tokens"]
        TransBlocks["Transformer 解码器层 (带 LoRA 路径重映射)"]
    end

    subgraph DualHeads["同一套权重下的异构输出端 (One Engine, Dual Systems)"]
        direction TB
        subgraph S1["System 1: 本能反射弧 (100ms 级别)"]
            DH["离散决策头 (lm_head LoRA + 槽位偏置)"]
            Calib["Per-Kind 温度系数数学校准"]
            ProbOut["强类型校准概率输出 (P(A), P(B), ...) / 0 生成 Token"]
        end
        subgraph S2["System 2: 深度慢思考 (秒级)"]
            ChatHead["原生自回归生成头"]
            CoT["多步思维链推理 (<think>...</think>)"]
            TextOut["长文本 / 复杂推理 / 策略分析"]
        end
    end

    Img --> ViT
    Txt --> Emb
    ViT -->|空间降维与投影| VTokens
    Emb --> TTokens
    VTokens --> TransBlocks
    TTokens --> TransBlocks
    TransBlocks -->|单次前向传导| DH
    TransBlocks -->|自回归循环生成| ChatHead
    DH --> Calib --> ProbOut
    ChatHead --> CoT --> TextOut
1. 底座权重的“同源孪生”与层级路径手术
JEV-27B-VL 的底层底座是阿里的开源多模态模型 Qwen/Qwen3.8-27B。在官方的权重构建脚本 common/make_mm_adapter.py 中,开发者清晰地展现了这场精巧的“神经外科手术”:
# 核心源码逻辑:将纯文本 LoRA 适配器移植到多模态底座
import os, shutil, sys
from safetensors.torch import load_file, save_file

src, dst = sys.argv[1], sys.argv[2]
os.makedirs(dst, exist_ok=True)
sd = load_file(os.path.join(src, "adapter_model.safetensors"))

# 将纯文本模型的层级路径映射至多模态模型的语言子模块中
remapped_sd = {
    k.replace("base_model.model.model.layers.",
              "base_model.model.model.language_model.layers."): v
    for k, v in sd.items()
}
save_file(remapped_sd, os.path.join(dst, "adapter_model.safetensors"))

# 承载决策头的 lm_head LoRA 与超参数配置文件原封不动保留
for f in ("adapter_config.json", "decision_head.json"):
    shutil.copy(os.path.join(src, f), os.path.join(dst, f))
纯文本版 JEV-27B 的语言模型骨干与多模态 Qwen3.8-27B 的语言子模块(language_model)具备完全相同的网络拓扑与参数初始化。整个移植过程中:
- Transformer 解码层的 LoRA 矩阵仅做键名路径重命名;
- 承载核心决策逻辑的
lm_head决策权重矩阵、偏置项(bias)与语言标记槽位映射表(decision_head.json)完全未作任何修改; - 最终生成的模型体积仅约 54GB,在一张 80GB 显存的 GPU 上即可满血启动。
2. 跨模态隐空间的语义同构性
为什么纯文本训练的分类头能直接判别图像?关键在于多模态语言模型的架构特性:
- 视觉 Token 的同构化:现代多模态大模型的视觉编码器(ViT)在经过预训练后,已经学会将 2D 图像 Patch 转化为与文本 Token 嵌入维度一致的高维向量。在进入 Transformer 解码器的那一刻,视觉特征被平铺为一系列特殊的视觉前缀 Token(
<|vision_start|>...<|vision_end|>); - 决策头的高维抽象性:JEV 的决策头学习的不是“具体的文字拼写”,而是在语言模型深层表征空间中,上下文与预定义意图槽位之间的投影关系与几何距离。
- 隐式视觉前缀的语义传导:当视觉 Token 充当上下文前缀时,多头自注意力机制(Self-Attention)自动将视觉表征注入到后续的决策提示词(
[state]、[question]、[options])中。在单次前向计算(Single Forward Pass)结束时,最终决策 Token 处提取出的隐状态向量,已经天然融合了图像的语义上下文。
这意味着:只要底层基座多模态模型的视觉对齐足够扎实,一个经过充分校准的纯文本离散决策头,就能够零成本继承基座的全部视觉理解能力。
二、 统一引擎下的双系统异构设计:本能反射弧与慢思考协同
在传统的系统架构中,如果既要快速分类,又要深度长文本推理,通常需要部署两套独立的模型(例如一个微调过的 DeBERTa/BERT 负责意图分类,搭配一个大型通用 LLM 负责复杂生成)。这种做法不仅造成两倍的显存驻留开销,更导致网络通信拓扑极其脆弱。
JEV-27B-VL 在同一个 vLLM 实例与同一套权重内,无缝融合了丹尼尔·卡尼曼所谓的双系统理论(System 1 与 System 2):
| 维度对比 | System 1(本能感知反射弧) | System 2(深度慢思考内核) |
|---|---|---|
| 底层通道 | jev-decision LoRA 适配层 + 离散决策头 |
原生 autotrust/JEV-27B 自回归解码头 |
| 计算模式 | 单次前向传播(Single Forward Pass) | 自回归多 Token 循环生成(Autoregressive) |
| 典型延迟 | 约 0.1 秒(100ms 级别) | 数秒至数十秒 |
| 输出形式 | 强类型确定性概率分布(严格归一化标量) | 自然语言长文本、多步思维链(<think>) |
| 输出 Token 消耗 | 0 生成 Token(直接读 Logprobs,计费免费) | 随思考链与回复长度线性计费 |
| 适用任务 | 结构化路由、质量裁决、异常过滤、冷启动排序 | 复杂数学推导、策略制定、创意长文撰写 |
1. System 1 的三大核心决策原语与 Logprobs 截取
System 1 摒弃了所有冗余的生成提示词,将现实系统中的各类控制流精准抽象为三大基础决策原语:
noul(二元判定):固定返回["false", "true"]的校准概率,常用于敏感内容拦截、幻觉检测与布尔逻辑分流;choice(有限分支归类):支持 2 到 256 个候选分支。对于 16 个以内的选项,使用预训练的原生字母标签(A~P);当超过 16 个选项时,启动wide-labels机制无缝扩充;score(离散量化打分):固定返回["0", "1", "2", "3", "4", "5"]的概率分布,通过加权期望值计算连续评分。
在底层通信时,System 1 甚至不需要模型吐出任何一个文本 Token。客户端向 vLLM 发送请求时,直接限定生成长度为 1,并提取候选 Verbalizer Tokens 的对数概率(Logprobs),随后注入模型内置的偏置量(Bias)并除以对应原语的温度系数(Temperature):
# System 1 客户端核心推导机制 (common/jev_client.py)
import math

def compute_calibrated_probabilities(raw_logprobs, verbalizer_ids, bias, temperature, options):
    """
    raw_logprobs: 从 vLLM /v1/completions 单步前向获取的候选 Token Logprob
    bias: decision_head.json 中针对特定槽位的先验校正偏置
    temperature: calibration.json 中针对 noul/choice/score 的专用校准温度
    """
    logits = [
        (raw_logprobs.get(tok_id, -1e9) + bias[slot_idx]) / temperature
        for slot_idx, tok_id in enumerate(verbalizer_ids)
    ]
    # Softmax 归一化,得到完全定型的无偏置信概率
    max_logit = max(logits)
    exps = [math.exp(l - max_logit) for l in logits]
    sum_exps = sum(exps)
    return {opt: exp_val / sum_exps for opt, exp_val in zip(options, exps)}
这种机制彻底斩断了“大模型生成 JSON 偶尔缺括号”、“Markdown 代码块渲染导致解析崩溃”等工程顽疾,保证输出结果在强类型系统中的绝对鲁棒。
2. 双系统自适应门控回退管线(Confidence Gating)
既然 System 1 既快又准,是否意味着可以完全弃用慢思考?答案是否定的。System 1 最宝贵的工程价值不仅在于它能做出判断,更在于它所输出的置信度是经过严格校准(Well-calibrated)的真实概率。
如果 System 1 对某个分类的最高置信度仅有 0.35,这说明当前上下文处于高度模糊或需要深层演绎的逻辑边缘。此时,系统可以通过一道极简的门控判定,将低置信度样本动态路由给 System 2 激活思维链:
sequenceDiagram
    autonumber
    participant App as 业务调用方 (Client)
    participant JEV as JEV-27B-VL 引擎
    participant S1 as System 1 (离散反射弧)
    participant S2 as System 2 (慢思考 CoT)

    App->>JEV: 提交多模态决策请求 (State + Question + Options)
    JEV->>S1: 执行单次前向计算 (Forward Pass, ~100ms)
    S1-->>JEV: 返回校准置信度矩阵 (如 P_max = 0.62)

    alt 置信度 >= 预设阈值 (如 0.70)
        JEV-->>App: 直接采纳 S1 决策结果 (总耗时 ~0.11s)
    else 置信度 < 预设阈值 (置信不足,触发兜底)
        Note over JEV,S2: 激活 Qwen3.8-27B 完整思维链推理
        JEV->>S2: 启动生成模式 (enable_thinking: true, 耗时 ~3.5s)
        S2-->>JEV: 输出完整推理过程与终态结论
        JEV-->>App: 返回 S2 深度推理结果 (兼顾精度兜底)
    end
在包含小学数学、代数应用、常识与科学问答的 120 道混合基准测试中,官方实测数据展现出了惊人的效能平衡:
| 执行策略 | 交由 System 2 深度思考的比例 | 整体正确率 | 耗时中位数 |
|---|---|---|---|
| 全量仅用 System 1 快速作答 | 0% | 79.2% | 0.11 秒 |
| 置信度 < 0.70 触发 System 2 回退 | 30% | 89.2% | 0.11 秒 |
| 全量强制使用 System 2 深度思考 | 100% | 91.7% | 3.75 秒 |
仅仅牺牲了 30% 样本的思考延迟,就将全量仅用 System 1 与全量慢思考之间的准确率差距拉回了 80% 以上;而整体系统对于 70% 的日常请求,仍然能够保持在 110 毫秒以内的极速响应,这构成了工业级服务 SLA 的最优平衡点。
三、 突破性实战场景与基准拆解:三大战役的工业级碾压
多模态能力与离散决策头的结合,使得 JEV-27B-VL 在多个原本由大参数生成模型或专有推荐模型统治的领域打出了颠覆性的战绩。
1. 短视频信息流零样本推荐:只看封面,追平数万人历史协同过滤
在类似 TikTok、快手或小红书的短视频信息流中,核心业务逻辑是为每一个用户在千百条新视频中挑选最可能被点击观看的候选内容。传统推荐引擎的核心瓶颈在于数据冷启动:
- 协同过滤(Collaborative Filtering)必须依赖大量的共现观看(Co-watch)历史,新上传的视频没有行为日志,只能被沉底;
- 基于文本特征(如标题、标签)的召回极易被“标题党”误导,且短视频本质是视觉消费品,标题往往无法承载画面的真实调性。
在西湖大学发布的真实短视频数据集 MicroLens-100k 上,评测设计极其贴近生产实况:针对 200 位随机用户,将其真实观看的下一个视频隐藏在同一时间段内其他用户观看的 19 个干扰视频中(模拟信息流真实展现的 20 选 1 候选集)。JEV-27B-VL 仅输入该用户最近看过的 5 个视频封面与 1 个候选视频封面,通过 noul 原语单次前向输出 P(点击候选视频):
# 推荐打分核心逻辑:纯视觉零样本排序
decision = decide_mm(
    kind="noul",
    state_parts=[
        "用户最近观看的视频封面:",
        {"image": cover_path_1},
        {"image": cover_path_2},
        {"image": cover_path_3},
        {"image": cover_path_4},
        {"image": cover_path_5},
        "\n候选待推视频封面:",
        {"image": candidate_cover_path}
    ],
    question="Is this scenario one where: this user clicks on the candidate video?"
)
click_prob = decision["true"]
评测结果给推荐系统业界带来了巨大震撼:
| 推荐算法方案 | 是否使用交互历史与用户特征 | 排序 AUC | Top-5 命中率 (Hit@5) |
|---|---|---|---|
| 随机基准 (Random Baseline) | 否 | 0.489 | 20.5% |
| 全局实时热度 (Popularity) | 仅统计曝光次数 | 0.505 | 23.0% |
| 视频标题 TF-IDF 文本相似度 | 否 | 0.602 | 38.5% |
| JEV-27B 仅阅读视频标题 | 否(零样本) | 0.649 | 45.5% |
| JEV-27B-VL 仅看封面图片 | 否(零样本多模态) | 0.727 | 59.0% |
| 传统物品协同过滤 (Item-CF) | 是(依赖 59,045 个用户真实观看日志) | 0.728 | 49.0% |
[!IMPORTANT]
三大关键洞察:
- 看图远胜读文本:封面图片所承载的风格调性与视觉偏好,比标题文本带来的排序增益高出整整 +0.078 AUC(95% 置信区间
[+0.031, +0.126]),具有显著统计学意义;- 零样本终结冷启动:完全不需要任何用户画像向量(User Embedding)与协同历史,仅看封面便取得了与近 6 万真实用户数据拟合出的 Item-CF 相同的 AUC(0.727 vs 0.728),且在 Top-5 命中率上实现反超(59.0% vs 49.0%);
- 算力延迟满足精排要求:在单张 GPU 上,对单个用户的 20 张高清候选封面完成全量并行打分仅耗时 2.6 秒,这使其完全具备直接进入现代推荐系统精排(Ranking)或重排(Rerank)流水线的落地可行性。
2. AI Agent 闭环裁判:压制 GPT-5 的自动化验收守卫
随着操作浏览器、自动化执行软件的 Web Agent 爆发,一个核心痛点日益突出:智能体在完成任务后往往会“自说自话”,自称“我已经成功订票/转账”,但实际操作可能中途卡死、弹窗未关或表单漏填。 团队需要高精度的自动裁判(Judge)来计算成功率、清洗强化学习数据。
A. 网页智能体终态裁决 (AgentRewardBench 2025)
麦吉尔大学(McGill)发布的 AgentRewardBench 包含了 1,302 条来自 GPT-4o、Claude 3.7 Sonnet、Qwen2.5-VL 等智能体在 WebArena、WorkArena 上留下的专家级标注轨迹。
JEV-27B-VL 读入用户的目标指令、智能体的工具调用序列及最终网页的高清截图,单次前向直接给出 P(任务已真实完成)。在官方排行榜记录中,JEV 在每一个对比模型自身的召回率基准线上,精确率(Precision)全部实现完胜:
+---------------------------------------------------------------------------------+
|                  AgentRewardBench 终态裁判精确率对比 (同召回率下)                 |
+---------------------------------------------------------------------------------+
| 规则方法 (原榜首)           | 精确率: 83.8%  --> JEV 同召回率精确率: 86.2% (+2.4%)   |
| WebJudge (o4-mini)         | 精确率: 82.0%  --> JEV 同召回率精确率: 87.7% (+5.7%)   |
| WebJudge-7B (专精裁判)     | 精确率: 75.7%  --> JEV 同召回率精确率: 86.2% (+10.5%)  |
| GPT-4o                     | 精确率: 69.8%  --> JEV 同召回率精确率: 72.9% (+3.1%)   |
| Claude 3.7 Sonnet (视觉)   | 精确率: 69.4%  --> JEV 同召回率精确率: 75.6% (+6.2%)   |
| Qwen2.5-VL-72B (视觉)      | 精确率: 64.5%  --> JEV 同召回率精确率: 67.9% (+3.4%)   |
+---------------------------------------------------------------------------------+
在默认 0.5 判定阈值下,JEV-27B-VL 取得了 78.4% 的精确率与 70.2% 的召回率,整体区分能力 AUROC 达到 0.91。单卡在 4 分钟内完成了全部 1,302 条复杂网页轨迹的终态核验。
B. 智能体轨迹规划裁决 (Plan-RewardBench, ACL 2026 主会)
在 ACL 2026 最新入选的 Plan-RewardBench 基准上(1,171 对智能体多步规划、工具异常恢复与安全拦截轨迹),JEV-27B-VL System 1 以 73.2% 的宏平均准确率夺得榜首,力压一众闭源和开源巨无霸:
- JEV-27B-VL System 1:73.2%
- Qwen-Plus:70.0%
- DeepSeek-V3.2:69.6%
- Inf-ORM-Llama3.1-70B(专精奖励模型):69.2%
- Gemini-3-Flash:69.1%
- GPT-5:68.5%
3. 多模态奖励模型裁决:击穿视觉幻觉防线
在评估多模态生成质量的权威基准 VL-RewardBench(CVPR 2025,1,247 对经过严格人工核验的图像-文本质量对)中,JEV-27B-VL 展现出了极其敏锐的视觉幻觉捕捉能力:
| 多模态裁判模型 | 日常图文问答 | 视觉幻觉辨别 | 多模态推理 | 全榜总准确率 |
|---|---|---|---|---|
| JEV-27B-VL System 1 | 58.0% | 83.2% | 78.2% | 78.3% |
| Skywork-VL-Reward-7B(专精奖励模型) | 65.6% | 80.2% | 61.3% | 73.3% |
| Gemini 2.0 Flash | 50.8% | 72.6% | 70.1% | 68.8% |
| GPT-4o | 49.1% | 67.6% | 70.5% | 65.8% |
| Claude 3.5 Sonnet | 43.4% | 55.0% | 62.3% | 55.3% |
在 Meta 于 2025 年底推出的最新下一代基准 Multimodal RewardBench 2(收录了 GPT-5 与 Gemini 3 Pro 等旗舰模型)上,JEV-27B-VL 在文生图质检子项上取得了 69.2% 的高分,与 GPT-5 的 70.5% 仅差 1.3 个百分点,充分证明其零样本提取图像几何与语义一致性的深度能力。
四、 工程落地与私有化部署踩坑避障指南
在将 JEV-27B-VL 推向生产环境时,由于其独特的 LoRA 决策头结构与多模态 vLLM 兼容机制,存在数个极易踩入的底层工程暗坑。以下为实战中验证过的关键配置准则:
1. 并发批次陷阱:必须硬性约束 --max-num-seqs 8
这是多模态版本中最隐蔽、最致命的底层算子陷阱。在纯文本版 JEV-27B 中,由于不包含 ViT 视觉切片处理,高并发 batch 并不会干扰 LoRA 计算;然而在当前 vLLM 的多模态 LoRA 分支实现中,一旦在单批次内并发序列超过 8 条,针对视觉嵌入的 LoRA 权重投影会发生内存对齐偏移,导致 System 1 计算出的对数概率(Logprobs)发生灾难性失真。
在生产启动脚本中,必须严格设置 --max-num-seqs 8:
#!/usr/bin/env bash
# 生产标准启动参数 (common/serve_jev27b_mm.sh)
exec vllm serve autotrust/JEV-27B-VL \
  --served-model-name autotrust/JEV-27B \
  --enable-lora \
  --max-lora-rank 32 \
  --lora-modules jev-decision=autotrust/JEV-27B-VL/adapter_vllm \
  --logprobs-mode processed_logprobs \
  --max-model-len 32768 \
  --enable-prefix-caching \
  --mamba-cache-mode align \
  --limit-mm-per-prompt '{"image": 8}' \
  --max-num-seqs 8 \
  --trust-request-chat-template \
  --port 8000
[!TIP]
限制--max-num-seqs 8并不意味着服务无法应对高并发。超过 8 条的外部请求会在 vLLM 内部队列中排队;在 B200 硬件环境下,单卡对 short text 决策的吞吐量可达 170+ 次/秒,图像决策吞吐量可达 13 次/秒。
2. 图像预处理黄金法则:强制约束至 448px
Qwen3.8-27B 的视觉处理器会根据输入图片的原始分辨率动态切分 Patches。如果直接将 4K 或 1080p 的原始图片抛给接口,单个图像切分出的 Vision Tokens 会迅速突破 1,000 个,不仅白白消耗宝贵的 KV Cache 显存,更会导致单次前向时延从 100ms 恶化到数秒。
在短视频封面与网页截图进入请求前,务必使用 PIL 执行轻量等比缩放:
from PIL import Image

def preprocess_image(input_path, output_path, max_dim=448):
    """
    将图像长边约束在 448px 以内
    约生成 144 个 Vision Tokens,兼顾判别精度与毫秒级时延
    """
    im = Image.open(input_path).convert("RGB")
    im.thumbnail((max_dim, max_dim))
    im.save(output_path, quality=85)
    return output_path
3. System 1 提示词工程的实测反常识
AutoTrust 团队在 400 条样本的意图识别基准上进行了细致的消融实验,结果颠覆了大量传统的 Prompt Engineering 迷信:
- 结构格式无关紧要:将上下文写成格式化的 JSON 字符串还是写成自然段落,模型准确率完全处于采样误差内(83.8% vs 83.2%)。无需费心将每个参数拼装成死板的 Schema;
- 礼貌与提示修饰毫无作用:在问题后追加“请挑选一个最佳意图”、“作为资深专家给出判断”等空洞指令,准确率无任何可观测提升(波动在 ±1.5% 以内);
- 唯一真正起效的技巧:为相似选项补充单行
use when说明:
当候选集合存在语义重叠(如“退款未到账”与“申请退款”)时,为每个选项追加一句话的适用场景边界,能带来惊人的准确率飙升:
[options]
A) card arrival: use when users ask about the status or delivery of a physical card.
B) card delivery estimate: use when users ask about the expected arrival time or delivery speed.
C) refund not showing up: use when a customer cannot see a completed refund in their account.
D) request refund: use when a user asks how to initiate or the timing of a refund.
[!NOTE]
在 BANKING77 测试集上,仅仅增加单行use when说明,模型准确率直接提升了 +4.8 个百分点;但如果继续塞入更多的反例(“请勿用于xxx”)或附带样例,准确率反而不再增长,只会浪费 Token。保持提示词干净精炼即为最优解。
五、 全景技术启示:从“巨石生成式模型”迈向“异构感知体”
autotrust/JEV-27B-VL 的开源与破圈,绝不仅仅是多了一个能打分的 VLM 权重,它对现代 AI 系统架构的演进提供了极具深度的启示:
- 模态边界的进一步消融:它强有力地证明了,大模型在深层特征空间中的语义对齐已经成熟到了“纯文本分类头可无损跨模态复用”的程度。多模态并不是必须从零堆砌的孤岛,成熟的自然语言决策经验可以零成本降维打击视觉领域;
- 消灭无意义的文本生成:在工业界的检索重排、信息流冷启动、风险管控与 Agent 拦截器中,90% 以上的场景本质上只需要一个确定、带置信度、强类型的离散决策。强制让模型输出
{"result": "pass"}并在下游编写大量防御性正则解析,是对计算资源和工程稳定性的双重浪费; - 双系统协同是终极降本形态:用单次前向(System 1)在 100 毫秒内过滤 70% 的常态化确定性流量,仅将剩余 30% 充满歧义与高维推演的疑难杂症转交长思维链(System 2)兜底,是当前兼顾亚秒级响应、工业级精度与百万级并发成本的最优解法。
原文链接与参考资料
- 模型主页:autotrust/JEV-27B-VL - Hugging Face
- 官方技术博文:autotrust/JEV-27B-VL: a decision model that learned to see without a single image of training - AutoTrust AI Lab
- 官方演示与代码仓库:JEV-27B-DEMO - GitHub (yuhai-china)
- 权威评测基准与论文:
- Multimodal RewardBench 2: Evaluating Omni Reward Models for Interleaved Text and Image (Meta, 2025, arXiv:2512.16899)
- Plan-RewardBench: Benchmarking Plan-Level Reward Models for Tool-Use Agents (ACL 2026)
- AgentRewardBench: Evaluating Automated Judges for Interactive Web Agents (McGill University, 2025, https://agent-reward-bench.github.io)
- VL-RewardBench: A Challenging Benchmark for Vision-Language Generative Reward Models (CVPR 2025, https://vl-rewardbench.github.io)
- MicroLens: A 100k-Scale Short-Video Recommendation Dataset with Raw Covers (Westlake University, 2023)