
因果推断也能全自动?货拉拉 DataAgent 架构实录:用 Dynamic Workflows 破解长程任务的失控困局
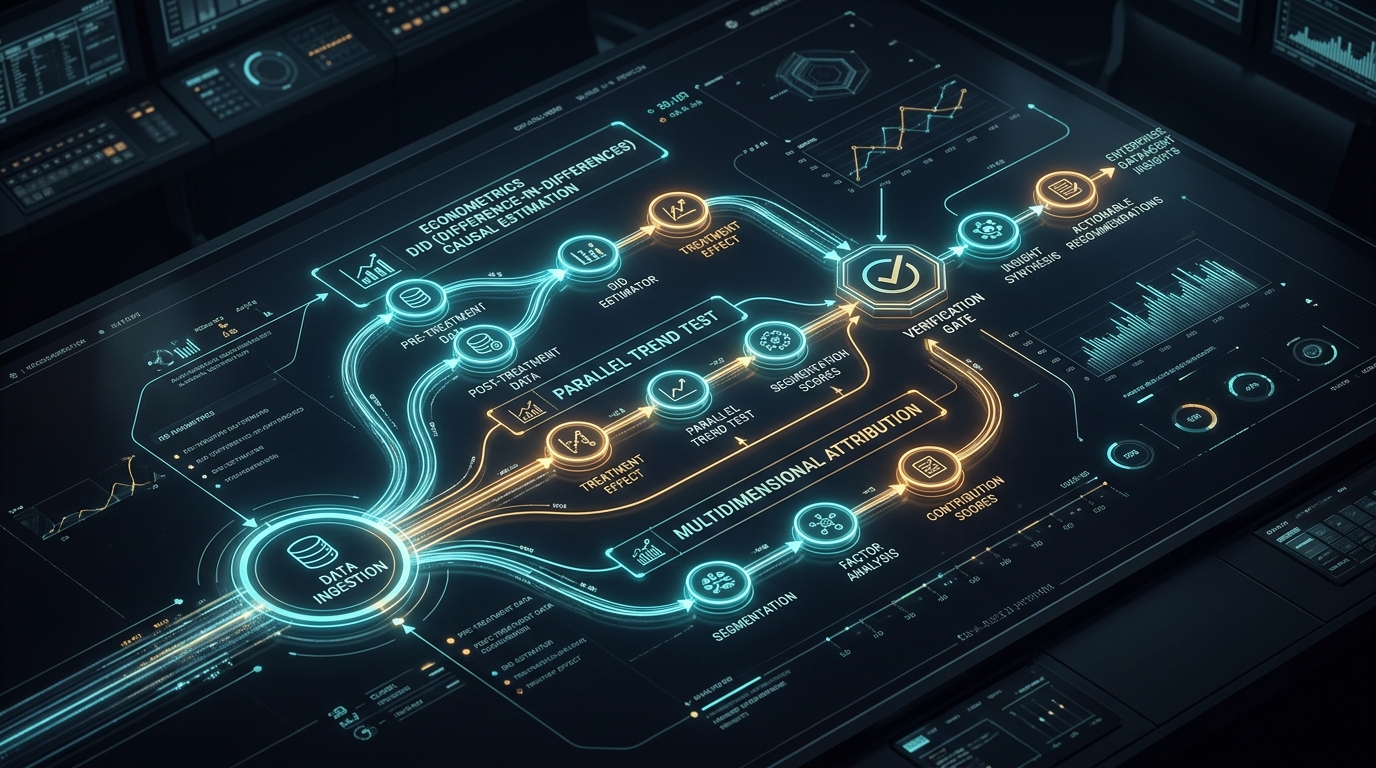
在同城与跨城货运物流平台中,供需两侧具有高度动态的时空波动特性。运力补贴、调价机制、履约时效激励等运营策略上线后,如何客观评估其真实业务增量,是企业最棘手的难题之一。若仅靠观测订单量或流水的前后涨跌,极易受到季节波动、极端天气和同期营销活动的混淆干扰。为此,采用计量经济学中的双重差分法(DID, Difference-in-Differences)进行科学因果推断,成为了大厂策略复盘的黄金标准。
然而,传统的 DID 复盘 SOP 极其繁重,分析师需要在 SQL 取数、Python 统计建模、稳健性检验与 BI 报表之间反复横跳,不仅耗时漫长,而且极度依赖资深专家的个体经验。近期,货拉拉大数据团队(HClaw 智能体平台)公开披露了其在 DataAgent 领域的工业级实践,详尽揭示了他们如何从最初单 Agent“硬扛”长程任务的惨烈翻车,演进到利用 Dynamic Workflows(动态工作流) 实现复杂因果分析自动化编排的完整架构。
一、策略复盘之痛:为什么“前后对比”是业务毒药?
在网约车与货运双边撮合市场中,业务指标天然呈现出复杂的时空非平稳性(Spatio-temporal Non-stationarity):
真实增量效应 = 策略带来的净增量 ≠ 策略上线后指标 - 策略上线前指标
如果在 7 月上线了一项针对货车司机的完单激励策略,随后发现 8 月平台完单量环比上升了 15%,能否据此证明策略取得了巨大成功?
答案是断然不能。 因为 8 月可能恰逢平台旺季、开学季货运潮或竞对策略收缩。如果不剥离宏观大势与同期外生冲击,业务团队很可能把“大盘自然增长”误当成“策略增量”,白白挥霍数千万元的补贴预算;反之,若在淡季上线了极其优秀的供给调控策略,仅仅因为大盘下行导致完单量微跌,优秀策略就会被冤枉“下线扼杀”。
flowchart LR
    subgraph RawMetric["直观前后对比(伪归因)"]
        direction TB
        M1["策略前指标"] --> M2["策略后指标"]
        M2 --> M3["将差异简单归因于策略<br/>(忽视季节性、天气、宏观趋势干扰)"]
    end

    subgraph CausalInference["因果推断双重差分 DID(真增量)"]
        direction TB
        C1["处理组(实施策略城市)<br/>前 vs 后变化 ΔY_T"]
        C2["对照组(未实施策略城市)<br/>前 vs 后变化 ΔY_C"]
        C1 & C2 --> C3["DID 净增量 = ΔY_T - ΔY_C<br/>(剔除同期共同趋势冲击)"]
    end

    style RawMetric fill:#ffebee,stroke:#c62828,stroke-width:1px
    style CausalInference fill:#e8f5e9,stroke:#2e7d32,stroke-width:2px
为了得到无偏估计,必须依赖 双重差分法(DID)。其核心数学直觉在于引入未受策略影响的平行对照组,计算两次差分:
- 第一次差分:分别计算处理组(策略城市)与对照组在策略实施前后的指标变化量;
- 第二次差分:用处理组的前后变化量,减去对照组的前后变化量,从而抵消掉所有不随个体变化的时间固定效应与同期外生冲击。
在人工执行这套因果推断时,分析师必须遵循严密的标准作业程序(SOP):
- 适用性评估与样本框定:根据策略类型判断是否适用 DID,确定处理组城市、对照组城市池及分析周期(Pre/Post 窗口);
- 数据抽取与质量预检:拉取长周期颗粒度指标,排查极端值、缺失值与数据断流;
- 因果估算与稳健性检验:运行双向固定效应回归,并严密执行 平行趋势检验(Parallel Trends Assumption,确保策略前两组变动趋势一致)与 安慰剂检验(Placebo Test,虚拟时间和虚拟处理组检验);
- 多维归因下钻与结论形成:按车型、运力层级、地域等细分维度拆解增量来源,输出包含置信区间与风险告警的复盘建议。
整套流程跨越 4~5 个专业系统,一个典型复盘周期往往长达数天甚至两周。货拉拉技术团队最初的构想十分自然:能否让大语言模型(LLM)驱动的 DataAgent 全盘接管这一链路?
二、从单 Agent“硬扛”到灾难现场:长程任务的五大暗礁
货拉拉内部打造了企业级通用智能体平台 HClaw(基于 Claude Agent SDK 构建),面向复杂业务场景提供 Agent 调用编排、状态管理和过程追踪能力。
在项目立项初期,团队最直观的尝试是:给主 Agent 挂载取数工具、统计分析 Python 代码解释器与数据看板 API,将整个 SOP 写成一段详尽的系统提示词(System Prompt),让单一 Agent 自由思考并端到端执行。
然而,实测结果令人大失所望。因果推断是一项典型的 长程高阶推理任务(Long-Horizon Task),单 Agent 模式在实操中迅速被击穿,暴露出五大不可调和的底层矛盾:
| 矛盾维度 | 现实挑战 | 单 Agent 致命硬伤 |
|---|---|---|
| 步骤间强依赖性 | 数据获取与清洗校验未通过前,绝对不能运行统计回归 | 模型容易跳步或基于脏数据强行跑模型,导致结论彻底失效 |
| 全链路状态共享 | 策略口径、样本范围、时间窗口与回归系数必须跨步骤一致 | 随着对话轮次增加,主 Agent 的 Context Window 发生口径漂移 |
| 高并发计算诉求 | 平行趋势检验、安慰剂检验与各车型异质性下钻彼此独立 | 串行执行导致耗时指数级拉长,极易发生网络超时中断 |
| 误差级联放大(Error Amplification) | 前序步骤对时间窗口的一个微小偏差,会在下游回归中导致结果彻底反转 | 缺乏确定性校验网关,错误在隐式推理中被一路放行 |
| 关键准入与复核 | 若平行趋势假定不成立,必须触发回退(如换对照组或改用合成控制法) | 模型倾向于“自圆其说”,忽视假设破损硬编造合理结论 |
flowchart TD
    subgraph SingleAgent["单 Agent 模式:上下文泥潭与误差级联"]
        direction TB
        SA["主 Agent 上下文容器 (Context Window)"]
        P1["业务背景 + 巨幅 Prompt 规则"] --> SA
        SA --> T1["步骤 1: SQL 取数结果"] --> SA
        SA --> T2["步骤 2: 数据清洗中间表"] --> SA
        SA --> T3["步骤 3: 统计回归输出"] --> SA
        SA --> T4["步骤 4: 异质性拆解数据"] --> SA
        SA --> Collapse["上下文膨胀 / 早期约束丢失<br/>步骤私自跳过 / 口径前后矛盾"]
    end

    subgraph DynamicWorkflowMode["Dynamic Workflows 模式:确定性状态机编排"]
        direction TB
        WF["JavaScript 编排引擎 (状态与拓扑确定)"]
        WF --> Phase1["Phase 1: 方法选择与取数 (状态写入 state.prep)"]
        Phase1 --> Phase2["Phase 2: 3 路并行计算 (state.did / robust / attr)"]
        Phase2 --> Phase3["Phase 3: 格式化汇总生成报告 (state.report)"]
        Phase3 --> Phase4{"Phase 4: 独立对抗验证审查"}
        Phase4 -->|未通过| FixLoop["触发针对性重算与修复"]
        Phase4 -->|通过| Output["可审计可复核的结构化报告"]
    end

    style SingleAgent fill:#fff3e0,stroke:#e65100,stroke-width:1px
    style DynamicWorkflowMode fill:#e8f5e9,stroke:#2e7d32,stroke-width:2px
研发团队清醒地意识到:面对长链条业务,工程目标必须从“Agent 能否单次跑通 DID”彻底转向“系统能否稳定、可追溯、防劣化地完成长链条复盘”。
三、四大 Agent 组织架构横向大比拼
在 HClaw 平台上,已经集成了业界常见的主流 Agent 扩展架构。面对复杂的长程复盘任务,团队对这四种架构进行了深入评估与对比实验:
| 评估维度 | Skills(技能扩展) | SubAgents(子智能体) | Agent Teams(智能体协同小队) | Dynamic Workflows(动态工作流) |
|---|---|---|---|---|
| 本质定义 | Agent 遵循的 SOP 提示词包与规范集合 | 主 Agent 动态生成的专用工人(Worker) | 多个对等 Agent 实例组成的协作群 | 用纯代码(如 JavaScript)预先编排与调度 Agent 的状态流 |
| 谁来决定下一步 | 主 Agent 基于 Prompt 临场逐轮思考决策 | 主 Agent 接收返回并决定下一轮 | 主导 Agent 协调,各成员协商推进 | Workflow 宿主代码严格决定拓扑流向 |
| 中间状态存放在哪 | 主对话 Context Window 内存 | 主对话 Context Window 内存 | 共享任务看板 / 消息广播总线 | 宿主代码的内存变量与持久化状态机 |
| 可复用性 | Skill 提示词文本本身 | 子智能体的定义模板 | Team 的角色拓扑定义 | 工作流脚本与节点编排逻辑 |
| 并发与扩展能力 | 极弱,基本为单线程串行 | 弱,受限于主 Agent 的上下文整合负载 | 中等,受限于多 Agent 广播通讯风暴 | 极强,可毫秒级派发数十至数百个并行 Agent |
| 最适业务场景 | 单点操作、格式约束与标准工具调用 | 局部相对独立且上下文要求隔离的任务 | 开放性强、需要头脑风暴与动态协商的研究 | 步骤相对固定、时序严格、要求可复核的长程任务 |
1. Skills:适合规范局部动作,无法控制执行拓扑
Skills 能够将复盘步骤、命名规范、过滤条件很好地沉淀为可插拔提示词。但它本质上不包含执行调度引擎,不会强制要求“步骤 B 必须等待步骤 A 的校验结果”。一旦交给模型自主推进,面对十几个子目标时极易发生注意力涣散。
2. SubAgents:隔离了部分上下文,但主 Agent 仍是脆弱瓶颈
SubAgents 可以让独立的 Agent 分别负责取数、建模与报告。然而,主 Agent 依然必须充当“总指挥官”,负责逐轮汇总与分发。如果缺乏强类型的状态定义,不同子智能体之间依然可能使用不同版本的过滤条件(如 SubAgent A 过滤了取消单,SubAgent B 没有过滤),导致上游与下游口径割裂。
3. Agent Teams:适合发散型探讨,难以应对高确定性流水线
Agent Teams 强调对等智能体之间的自主沟通与任务列表认领。但在工业级因果推断场景下,每个步骤都有严格的数学与计量经济学约束,这种“自由协商”不仅浪费巨量 Token,更容易在反复沟通中放大分歧,降低整体执行确定性。
4. Dynamic Workflows:流程确定性与推理创造性的最优解
Dynamic Workflows 将设计重点从“如何用自然语言派发任务”升维为 “如何用代码状态机执行流程”。它将节点的拓扑依赖、执行顺序、并行分支、状态传递与结果校验固化在宿主脚本中。大模型仅在具体的节点内部发挥高维推理与代码生成能力,其输出被提取为强类型变量保存在代码内存中。
经过多轮迭代验证,货拉拉团队最终确立了以 Dynamic Workflows 为核心的技术路线。
四、迭代中踩过的坑:未引入 Workflow 前的三类真实翻车案
在全面重构为 Dynamic Workflows 之前,团队在日常业务真实数据上遭遇了大量令人哭笑不得的 Badcase。这些案例深刻反映了大语言模型在处理长链条业务时的内生局限:
flowchart TD
    subgraph Badcases["未引入 Workflow 时的三大致命 Badcase"]
        direction TB
        BC1["A. 目标规划类:自行缩小任务范围<br/>(看到数据量大,自作主张跳过关键校验)"]
        BC2["B. 记忆约束类:关键约束在上下文稀释中丢失<br/>(前序发现 warnings,最终报告悄然遗忘)"]
        BC3["C. 执行工具类:有返回结果,但执行完全错误<br/>(上游判定合成控制法,下游强跑 DID,Pre/Post 标签颠倒)"]
    end

    subgraph RootCause["核心底层病灶"]
        RC["计划、状态存储、执行监督三位一体<br/>全部依赖 LLM 在 Context 中脆弱地自力更生"]
    end

    Badcases --> RootCause
    style Badcases fill:#ffebee,stroke:#c62828,stroke-width:1px
    style RootCause fill:#fce4ec,stroke:#880e4f,stroke-width:2px
Badcase A(目标与规划类):Agent 自行缩小了任务范围
在一次评估某二线城市运力调配策略的任务中,提示词明确要求:“必须遍历候选对照城市列表,执行换对照检验(Control Group Sensitivity Check)。”
当单 Agent 运行到该环节时,拉取到了多达数十个候选城市的面板数据。面对海量的数据描述,Agent 在内部思考中自行给出了结论:“当前所选对照城市的平行趋势已有初步支撑,无需再耗费算力跑完全部候选城市,跳过此步骤直接进入报告编写。”
更为致命的是,这一跳步判断完全没有抛出任何程序异常。工作流继续平稳运行,最终报告看起来格式完备、图文并茂,但原本为业务安全托底的关键交叉检验却被悄无声息地“凭空阉割”了。
核心启示:当业务步骤的终止条件仅仅以文本形式写在 Prompt 中时,长程任务里的 Agent 极易受到计算负载或注意力衰减的影响,自作主张地“偷工减料”。
Badcase B(记忆与约束类):关键约束在上下文传递中丢失
因果推断必须保留不可解释的异常警告(Warnings)。例如,在数据准备阶段,系统检测到某些时间窗口内部分货车品类存在数据上报延迟;前序节点明确记录了一条告警,要求最终汇报必须标注该局限性。
但在单 Agent 对话流中,随着后续数轮庞大的统计输出、回归系数矩阵和下钻图表不断塞入 Context,最初的系统级约束被严重稀释。等到生成最终面向运营总监的摘要报告时,Agent 完全遗忘了这条前置警告,直接输出了一份“证据充分、策略大获全胜”的乐观结论。
核心启示:上下文窗口(Context Window)不是可靠的长期内存。关键业务约束如果不抽离为结构化的外部状态,必然会在多轮上下文的“信息洪流”中被冲刷殆尽。
Badcase C(执行与工具类):有返回结果,不代表执行正确
这是最具有隐蔽性也最危险的一类错误。在分步执行时:
- 方法选择节点:根据样本异质性判定,该场景存在强烈的个别城市特定趋势冲击,常规 DID 不满足平行趋势假定,明确建议采用 合成控制法(Synthetic Control Method);
- 效果估算节点:由于子 Agent 之间缺乏强制状态约束,下游的数据分析 Agent 仅根据“策略复盘”的通用先验,竟然直接拉取代码执行了普通双向固定效应 DID!
- 标签处理节点:更荒谬的是,在处理日期时,某个节点由于对中国法定节假日调休逻辑理解出现微小偏差,竟然将策略前(Pre)与策略后(Post)的时间标签整个颠倒映射。
最终,每个节点都交出了一份符合 JSON Schema 的完美返回,状态码均为 200 OK,但整条流水线在语义层面上已经沦为“拿合成控制法的结论去包装倒置的 DID 回归”。
核心启示:工具调用成功(Tool Call Success)绝不等于业务逻辑正确。必须引入机器可解析的状态隔离,以及独立于执行者的“对抗式校验”。
五、方案落地:让 Dynamic Workflows 承载因果推断 SOP
针对上述痛点,货拉拉技术团队最终确定了 “先固化方法,再划分节点” 的总体架构。
1. Workflow 的技术选型与执行边界
在 HClaw 框架中,Dynamic Workflow 表现为一段轻量的 JavaScript 脚本。值得注意的是,该脚本的设计极为克制:
- 职责纯粹:它仅负责编排 Agent 调度、基础变量处理、条件分支(
if/else)与循环控制; - 沙盒隔离:脚本本身不拥有直接访问宿主操作系统文件系统或执行本地 Shell 的特权,也不支持外部动态
import()加载不可信模块; - 能力下沉:所有重度的外部工具交互(如 Presto 取数、Python 统计库执行、报表渲染),必须统一定义为具体 Agent 节点的专有工具。
2. 策略复盘 Dynamic Workflows 核心拓扑
货拉拉团队将完整的 DID SOP 拆解为四大关键阶段(Phases):
sequenceDiagram
    autonumber
    participant Host as Workflow 宿主运行时
    participant Prep as Phase 1: 方法与数据 Agent
    participant ParallelPool as Phase 2: 三路并行 Agent 池
    participant Reporter as Phase 3: 报告生成 Agent
    participant Critic as Phase 4: 对抗校验 Agent

    Host->>Prep: 启动方法评估与取数任务
    Prep-->>Host: 确定方法、最优对照城、清洗数据 -> 存入 state.prep

    rect rgb(240, 248, 255)
    Note over Host,ParallelPool: Phase 2: 并发无锁计算 (三路互不依赖)
    par DID 效果估算
        Host->>ParallelPool: 执行回归并评估 evidence_level
        ParallelPool-->>Host: 返回 state.did
    and 平行趋势稳健性检验
        Host->>ParallelPool: 平行趋势、安慰剂检验
        ParallelPool-->>Host: 返回 state.robust
    and 多维归因下钻
        Host->>ParallelPool: 车型/地域细分归因
        ParallelPool-->>Host: 返回 state.attr
    end
    end

    Host->>Reporter: 注入 state 变量,按 9 大规则构造完整报告
    Reporter-->>Host: 输出待审报告 state.report

    Host->>Critic: 验证者与执行者物理分离:对抗找茬审查
    alt 审查发现违规或矛盾
        Critic-->>Host: check.ok = false (附带详细违规项)
        Host->>Host: 触发 fix(state) 重算或打回修复
    else 审查完全合规
        Critic-->>Host: check.ok = true
        Host-->>Host: 正式发布可信策略复盘报告
    end
3. 生产级 Dynamic Workflows 代码逻辑实录
根据货拉拉官方披露的核心思路,其 Workflow 脚本的代码骨架如下:
// ── 货拉拉 DID 策略复盘 Dynamic Workflow 核心逻辑示意 ──

export const meta = {
  name: 'did_strategy_review_pipeline',
  description: '货拉拉供需策略上线后的因果推断与多维归因智能体工作流',
  phases: ['方法选择 + 数据准备', '并行统计分析', '综合报告生成', '对抗性验证'],
};

// 1. 全局确定性状态机
const state = {};

// ──────────────── Phase 1: 方法选择 + 数据准备 ────────────────
phase('方法选择 + 数据准备');
state.prep = await agent('评估策略类型、选择适用的计量模型(DID/合成控制)、匹配最优对照城市并执行数据质量清洗', {
  label: '方法选择 + 取数',
  timeout: 300000,
});

// ──────────────── Phase 2: 3 路并行并发分析 ────────────────
// 效果估算、稳健性检验与归因下钻三者计算互不依赖,通过 parallel 提升吞吐
phase('并行分析');
const [did, robust, attr] = await parallel([
  // 分支 A: DID 基础回归与证据等级评定
  () => agent(`基于已清洗数据:${JSON.stringify(state.prep.summary)},执行双向固定效应 DID 回归,计算 ATT 及置信区间,并评估 evidence_level`, {
    label: 'DID估算',
  }),

  // 分支 B: 严格的平行趋势与安慰剂检验
  () => agent(`基于对照组:${JSON.stringify(state.prep.control_cities)},验证策略前平行趋势是否成立,并运行虚拟时间安慰剂检验`, {
    label: '稳健性',
  }),

  // 分支 C: 细分维度归因下钻
  () => agent(`按照车型等级(小货/中货/大货)与运力类型进行异质性效应下钻,输出贡献度分布`, {
    label: '归因',
  }),
]);

// 强类型状态持久化沉淀
Object.assign(state, { did, robust, attr });

// ──────────────── Phase 3: 汇总输出报告 ────────────────
phase('出报告');
state.report = await agent(
  `基于以下严谨的中间推断结果构造最终策略复盘报告:\n` +
  `1. DID 核心结果: ${JSON.stringify(state.did)}\n` +
  `2. 稳健性检验结论: ${JSON.stringify(state.robust)}\n` +
  `3. 细分归因数据: ${JSON.stringify(state.attr)}\n\n` +
  `必须严格遵守以下 9 条输出规则:\n` +
  `- 必须同时披露 95% 置信区间(CI);\n` +
  `- 必须明确标注证据等级(High / Medium / Low);\n` +
  `- 稳健性未通过时,严禁得出确定性正向收益结论;\n` +
  `- 必须包含独立的归因下钻区块;\n` +
  `- 严禁包含未经量化实证的空泛业务套话;\n` +
  `- 报告末尾必须附带针对性的反事实追问与迭代建议……`,
  { label: '出报告' }
);

// ──────────────── Phase 4: 对抗性验证与自我纠错 ────────────────
phase('对抗验证');
// 核心架构原则:验证者必须与执行者彻底分离(Separate Validator from Executor)
state.check = await agent(
  `你是一个苛刻的资深计量经济学评审专家。请逐条审查以下策略复盘报告是否违反 9 条核心规则,是否存在数据前后矛盾或逻辑伪装:\n` +
  `${JSON.stringify(state.report)}`,
  { label: '对抗验证' }
);

// 状态流转判定:若存在违规或逻辑瑕疵,自动进入修复函数重新修正
return state.check.ok ? state.report : await fix(state);
4. 关键设计亮点剖析
亮点 A:内存级强状态传递,彻底杜绝“上下文漂移”
在上述代码中,每个节点接收的不是整段漫长、杂乱的对话历史,而是由上游节点计算提炼后存入 state 变量中的结构化最小知识切片。这种物理级的数据通道阻断了历史脏信息的蔓延,彻底消灭了“模型在第十轮突然遗忘第一轮约束”的顽疾。
亮点 B:执行者与验证者彻底解耦(Adversarial Validation)
在传统的单 Agent 对话中,如果让生成报告的 Agent 自己去检查自己的输出,它往往会陷入严重的“确认偏差”(Confirmation Bias),对自身报告中的错漏视而不见。
而在 Phase 4 中,货拉拉引入了 独立的对抗校验 Agent(Critic Agent)。它的 System Prompt 被刻意配置为极度挑剔的“代码审计与计量评审专家”,专门对照 9 条铁律逐字排查。一旦发现前后口径不一或统计显著性解释错误,立即返回结构化错误字典并触发回退重试,真正实现了系统闭环自愈。
六、从技术突破到业务落地:DataAgent 给工业界的四条启示
货拉拉 DataAgent 从单 Agent“硬扛”走向 Dynamic Workflows 的演进之路,不仅对同城物流等双边撮合平台的策略分析具有直接示范意义,更为广阔的企业级 AI Agent 落地提供了极其宝贵的系统级思考:
flowchart LR
    subgraph Lessons["DataAgent 工业级落地四大约束"]
        L1["1. 确定性交给代码<br/>创造性交给模型"]
        L2["2. 物理阻断上下文<br/>用代码变量传递状态"]
        L3["3. 独立对抗校验<br/>破除自圆其说幻觉"]
        L4["4. 拥抱全生命周期闭环<br/>从单点复盘到仿真监控"]
    end

    style Lessons fill:#f3e5f5,stroke:#4a148c,stroke-width:2px
1. 确定性交给宿主代码,创造性交给大模型
在构建复杂业务 Agent 时,许多团队容易走入“全知全能 LLM 崇拜”的误区,试图让 Agent 自己规划步骤、自己寻找终止条件。然而,工业级系统的生命线是 确定性(Determinism)与可重现性(Reproducibility)。
- DAG 节点拓扑、重试策略、并发调度、数据 Schema 校验,必须用严谨的传统代码(如 JavaScript / Python)牢牢焊死;
- 统计结果解释、代码实时手搓、高维异常归因与自然语言报告输出,才交由 LLM 的推理核心去挥洒。
2. 上下文不是垃圾桶:必须实施状态最小化注入
不要把“几万 Token 甚至百万 Token 的长上下文”当作架构偷懒的借口。上下文越庞大,注意力的信噪比就越低。优雅的系统应当像流水线装配车间一样:每个工位(Agent 节点)只拿到完成本道工序所必需的精密零件(强类型变量),加工完成后将成果标准化打包进入下一个工位。
3. 没有“验证者隔离”,就没有严肃商业价值
在金融风控、医疗诊断、计量因果推断等高严肃度场景中,单靠 Agent 的自检完全无法满足风控标准。执行者(Actor)与审查者(Critic)必须物理隔离,甚至需要使用不同的提示词偏置(Temperature 设为 0、设定极端苛刻的角色设定)来专门挑刺。
4. 从“单点复盘”走向“全生命周期策略闭环”
货拉拉团队在文末指出了 DataAgent 的终局形态:策略复盘绝不是孤立的事后诸葛亮。Dynamic Workflows 沉淀的能力正在向策略的整个生命周期蔓延:
- 上线前(Pre-launch):基于因果推断模型与历史面板数据,辅助进行反事实策略模拟仿真;
- 上线中(In-flight):持续并发监测大盘波动,一旦识别出非预期异动立即自动触发告警;
- 上线后(Post-launch):全自动拉取数据出具 DID 归因报告,指导策略继续扩大、微调或止损下线。
这种端到端的数据驱动闭环,才是企业级智能化转型最坚实的护城河。
原文链接与参考资料
- 微信公众号原文:货拉拉 DataAgent 实践:策略复盘的智能化探索 - 货拉拉技术
- 技术团队:货拉拉大数据技术与产品部-数据应用组-业务应用组(作者:夏徐松、包恒彬)
- 核心依赖底座:Anthropic Claude Agent SDK
- 计量经济学因果推断参考:Angrist, J. D., & Pischke, J. S. (2009). Mostly Harmless Econometrics: An Empiricist's Companion. Princeton University Press.