
大道至简的工程神作:重读《Attention Is All You Need》,撕开 AI 学术界的“伪数学装深沉”遮羞布
近日,独立开发者与程序员 @v0xium 在社交媒体上发表了一段引发广泛共鸣的评论:“在我看来,《Attention Is All You Need》是近代写得最好、最具影响力的论文之一。它行文通俗、言简意赅、极易复现,而且没有任何多余的技术黑话或数学伪装。这才是学术研究论文该有的样子:清晰而精准,而不是刻意把成果伪装得比实际更复杂。”
这番评价犹如一把精准的手术刀,切中了当下人工智能研究与工程技术圈最敏感的神经。在深度学习论文普遍深陷“符号通胀”与“故弄玄虚”的今天,回看 2017 年奠定现代大模型大厦基石的 Transformer 开山之作,我们更能看清真正顶级的工程哲学与学术表达究竟应该具备怎样的质感。
一、学术界的“伪数学化”与黑话通胀
在计算机科学与人工智能的学术圈里,一直流传着一个心照不宣的潜规则:如果一个想法过于直观简单,审稿人往往会判定其缺乏“理论深度”而予以拒稿。
诺贝尔经济学奖得主 保罗·罗默(Paul Romer)曾创造过一个著名词汇——“Mathiness”(伪数学化)。他尖锐地指出,很多学术工作并不是在用数学来厘清思想,而是在利用晦涩复杂的数学符号来遮掩思维的漏洞、恐吓同行评审人员,并人为构筑起一道看似高不可攀的学术壁垒。
在主流机器学习会议(如 NeurIPS、ICML、ICLR)的审稿流程中,类似的异化现象屡见不鲜:
- 启发式技巧的过度包装:一个在工业界实践中验证有效的微小工程 Trick(例如对特定梯度做一次简单的归一化截断),在论文里往往要被套上五页流形学习、测度论或非凸优化的引理证明,把简单有效的直觉包装成凡人看不懂的天书;
- 符号系统的通胀与堆叠:滥用生僻的希腊字母、多重上下标与复杂的张量缩并记号,读者需要花费数小时去查阅符号定义表,最后发现核心逻辑只是一次加权平均;
- 复现灾难与伪装严谨:大量充斥着高深公式的论文,其开源代码要么漏洞百出,要么充斥着未在正文中公开的随机种子筛选与超参数“特调”,一旦脱离特定的实验环境就彻底失效。
这种“以复杂为荣、以极简为耻”的风气,不仅让初学者望而却步,更极大地浪费了整个学术界与工程界的试错成本。
二、重读 Transformer:四大至简工程美学
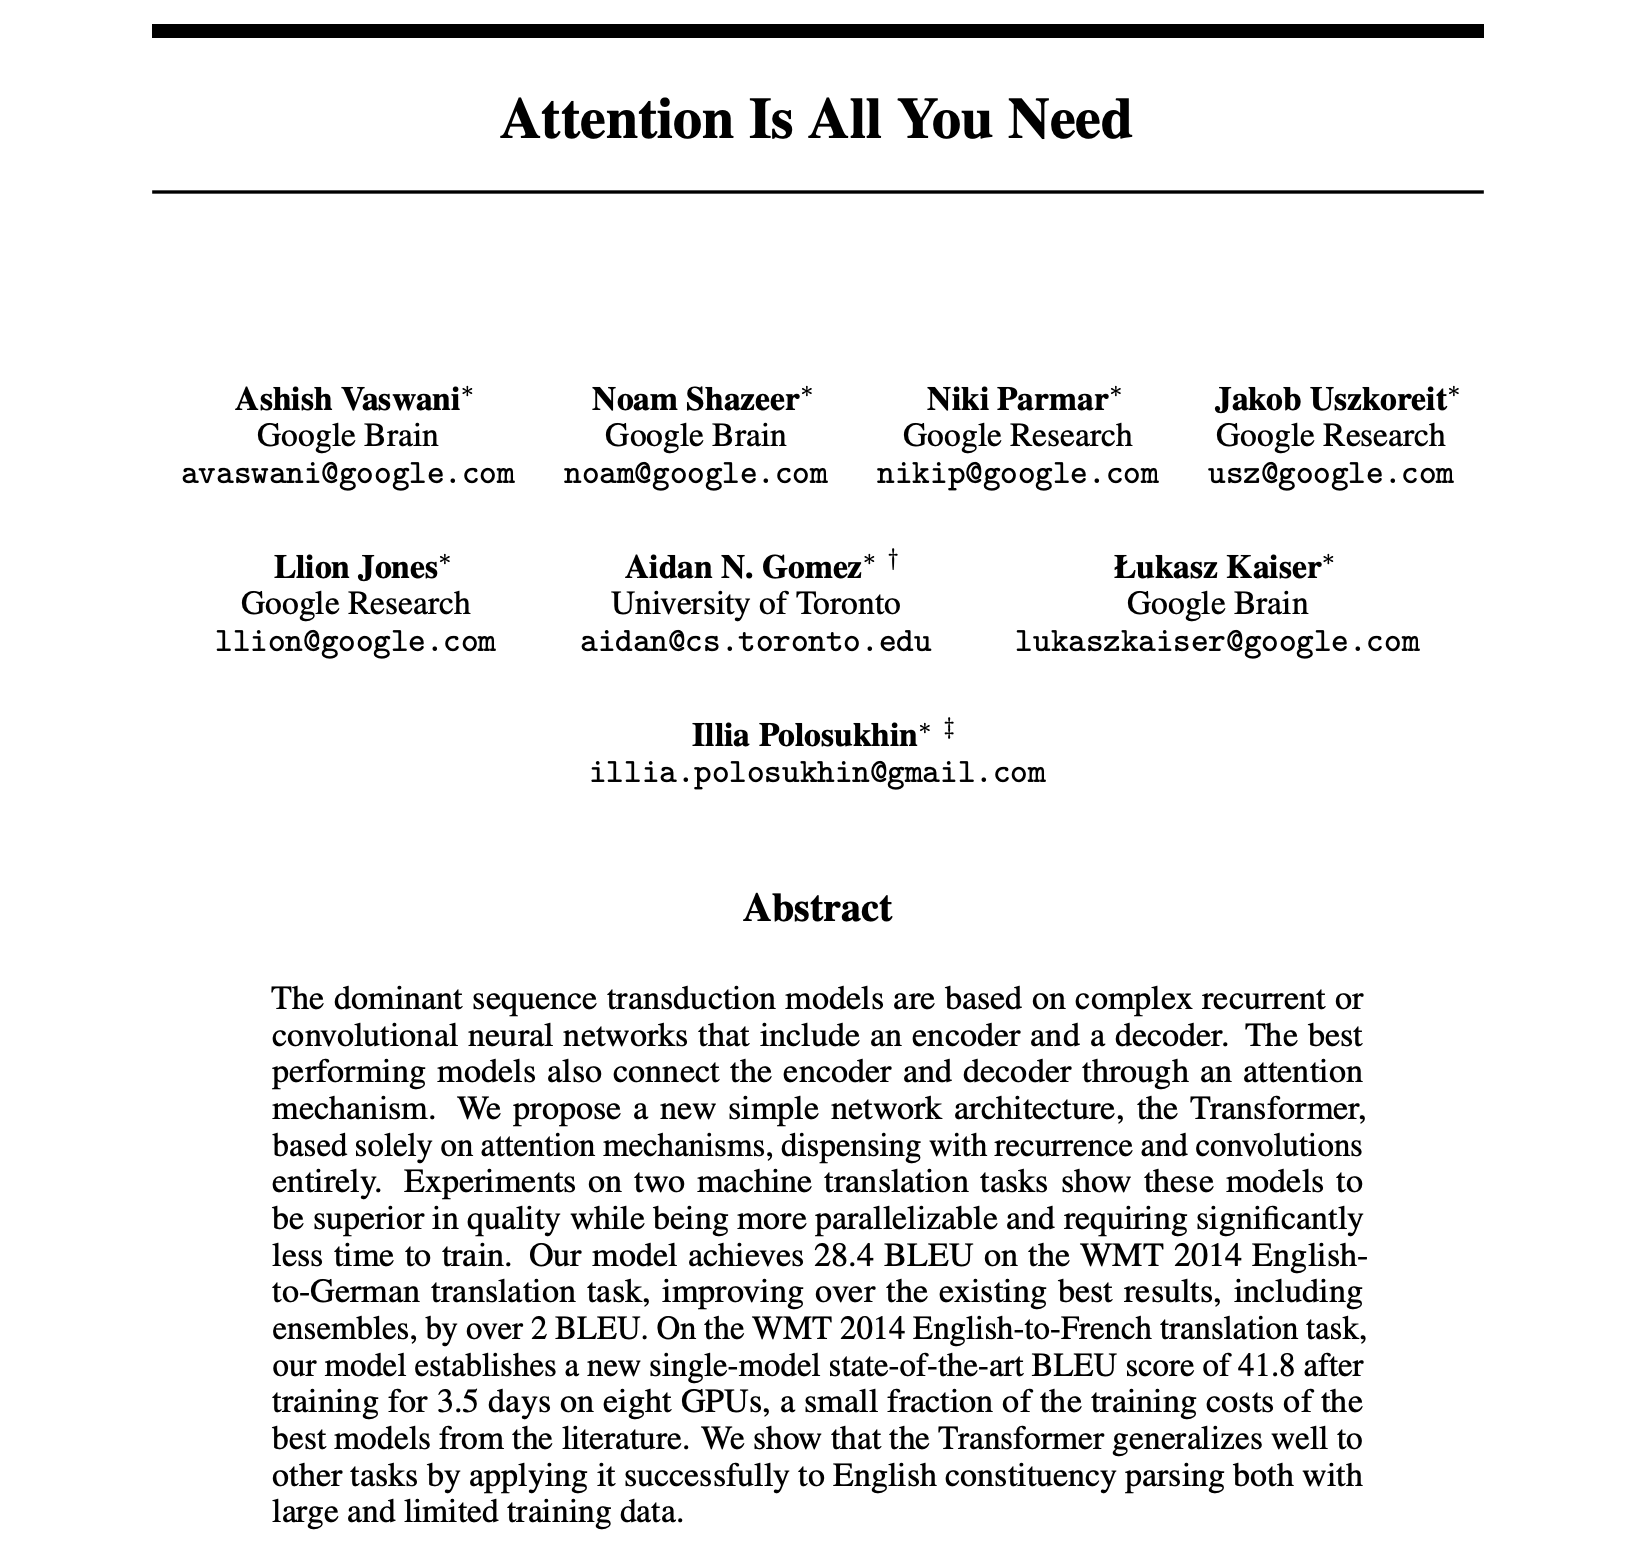
正是在这种充斥着繁文缛节的大背景下,Ashish Vaswani 等 8 位研究者合著的《Attention Is All You Need》才显得如此耀眼与不可逾越。它摒弃了所有虚妄的装饰,全篇每一处设计都直面真实的工程瓶颈。
1. 标题与摘要的定力:一击致命的自信
绝大多数学术论文的标题,往往喜欢罗列冗长的修饰词,例如“基于某种自适应混合残差循环架构的跨语言序列转换探索”。
而 Vaswani 等人给出的标题是直接、果断甚至带有一丝挑衅意味的陈述句:
《Attention Is All You Need》(注意力是你所需要的一切)
论文的摘要(Abstract)仅有短短 15 行,文字精炼到了极致:
- 直击行业瓶颈:当时主流的序列转导模型普遍依赖循环神经网络(RNN)或卷积神经网络(CNN),而 RNN 固有的时序依赖导致其无法在时间步上并行计算;
- 提出破局方案:提出一种全新的极简网络架构——Transformer,完全摒弃循环结构与卷积运算,仅依赖注意力机制;
- 亮出硬核战果:在 WMT 2014 英德翻译任务上达到 28.4 BLEU 刷新 SOTA,且仅用 8 张 P100 GPU 训练了 3.5 天,算力开销仅为文献中最佳模型的一个零头;
- 验证泛化能力:零样本地迁移至英语成分句法分析任务,展现出惊人的跨任务适应性。
整篇摘要没有任何空话套话,没有引经据典的自夸,只有明确的痛点、优雅的方案与压倒性的实验数据。
2. 算力维度的降维打击:从时序串行到矩阵并行
在 Transformer 诞生之前,长文本建模的主流是 LSTM 与 GRU。RNN 的计算拓扑天然决定了它是一个状态机:必须算完前一时刻的隐藏状态,才能开始计算当前时刻。
flowchart LR
    subgraph RNN["传统 RNN 架构:严格时序串行 (无法充分利用 GPU 硬件并行)"]
        direction LR
        x1["输入 x_1"] --> h1["隐藏层 h_1"]
        x2["输入 x_2"] --> h2["隐藏层 h_2"]
        x3["输入 x_3"] --> h3["隐藏层 h_3"]
        xn["输入 x_n"] --> hn["隐藏层 h_n"]
        h1 -->|"串行依赖 Step 1"| h2
        h2 -->|"串行依赖 Step 2"| h3
        h3 -->|"串行依赖 Step N-1"| hn
    end
这种时序锁步机制,将庞大的 GPU 集群降级成了串行流水线,极大地限制了吞吐效率。
而 Transformer 的 Self-Attention 直接将序列展开为全连接矩阵运算:
flowchart TD
    subgraph Transformer["Transformer 架构:O(1) 串行步数 (高并发矩阵张量乘法)"]
        direction TB
        X["输入矩阵 X (包含全部 n 个 Token)"] --> QKV["一次线性投影生成 Q, K, V"]
        QKV --> Attn["QK^T 矩阵乘法 + Softmax 归一化 (直接榨干 GPU Tensor Core)"]
        Attn --> Out["注意力加权输出 (所有位置一步并发生成)"]
    end
论文中经典的 Table 1 清晰地对比了三种架构的底层差异:
| 架构层级 | 每层计算复杂度 | 串行操作步数 | 最大信号传播路径长度 |
|---|---|---|---|
| Self-Attention | |||
| Recurrent (RNN) | |||
| Convolutional |
正是将串行计算步数从 彻底压降至常数级别的 ,才为后来的万卡集群并行预训练铺平了道路。这根本不是复杂的数学推导,而是极致敏锐的 计算机系统与硬件体系结构认知。
3. 架构与公式的纯粹:拒绝多余修饰
Transformer 的核心公式,简单到任何具备线性代数基础的大二学生都能在 5 分钟内读懂:
这个看似平淡无奇的公式背后,凝结着极高维度的工程权衡:
- 为什么选点积注意力而非加性注意力?
加性注意力(Bahdanau Attention)在理论表达能力上毫不逊色,但点积注意力可以通过高度优化的通用矩阵乘法(BLAS / GEMM)直接映射到 GPU 硬件核心上,实际计算速度比加性注意力快上数倍且大幅节省显存; - 为什么必须除以根号项进行缩放?
随着向量维度 的增大,点积的数值方差会同比例放大到 。当输入数值过大时,softmax函数的输出将极度偏向两极,导致其梯度趋近于 0(梯度消失死区)。除以 将方差重新拉回 1,以极小的计算代价确保了训练过程的反向传播稳定性; - 多头注意力机制(Multi-Head Attention)的本质是什么?
不是为了堆参数,而是为了让模型能够在不同的子空间(Subspace)中并行关注不同类型的信息——有的注意力头关注主谓宾语法依赖,有的关注代词指代,有的关注动宾搭配,而拆分后的投影维度让总算力开销与单头全尺寸几乎完全相同。
4. 罕见的作者分工透明度
在论文的首页底部,附带了一段如今已被奉为学术楷模的作者贡献脚注(Footnote):
“Ashish 与 Noam 提出了核心的注意力机制并主导了模型设计与改进;Niki 设计了 Multi-Head 注意力与实验代码;Jakob 构思了用注意力完全替代 RNN 的核心设想并主导了初始工程;Llion 提出了自注意力方案并负责模型命名;Aidan 和 Łukasz 编写并优化了 Tensor2Tensor 基础设施;Illia 设计并执行了大量翻译与跨任务评估……”
这种坦荡澄澈的分工说明,没有模糊不清的争夺,没有浮夸的挂名,展现了一支由顶尖工程师与科学家组成的团队最纯粹的极客精神。
三、极简复现力:20 行核心代码说明一切
衡量一篇架构论文是否真正优秀的黄金法则,是看它能否被工程师仅凭论文正文描述即可精准复现。
不需要隐晦的闭源库,不需要黑盒编译加速,仅仅使用原生 PyTorch,一个标准的 Scaled Dot-Product Attention 只需要不到 20 行清澈见底的代码:
import torch
import torch.nn as nn
import math

class ScaledDotProductAttention(nn.Module):
    def __init__(self, dropout=0.1):
        super().__init__()
        self.dropout = nn.Dropout(dropout)

    def forward(self, q, k, v, mask=None):
        # q, k, v 的形状: [batch_size, n_heads, seq_len, d_k]
        d_k = q.size(-1)

        # 1. 矩阵点积计算注意力得分: (Q * K^T) / sqrt(d_k)
        scores = torch.matmul(q, k.transpose(-2, -1)) / math.sqrt(d_k)

        # 2. 掩码机制(可选:用于自回归解码器)
        if mask is not None:
            scores = scores.masked_fill(mask == 0, -1e9)

        # 3. Softmax 归一化为概率权重
        attn_weights = torch.softmax(scores, dim=-1)
        attn_weights = self.dropout(attn_weights)

        # 4. 与 Value 矩阵相乘得到加权表征
        output = torch.matmul(attn_weights, v)
        return output, attn_weights
整段逻辑没有晦涩的控制流,没有难以言说的边缘条件。现代计算机工业能在这个基础上构建起参数量达万亿级的大语言模型,其核心正是因为 底层基石足够简单、足够鲁棒、足够可复现。
四、给技术人与架构师的四条反思
重温《Attention Is All You Need》与 @v0xium 的感触,不仅是对学术界的警醒,对于日常从事系统设计、技术写作与架构重构的工程师而言,同样具有深刻的启示:
- 奥卡姆剃刀永远生效:若无必要,勿增实体。一个系统最完美的时刻,不是无法再添加任何组件的时候,而是无法再删减任何组件、且整体依然稳定运转的时候;
- 警惕“智力虚荣心”:许多人在撰写技术设计方案(RFC)或业务架构文档时,喜欢堆砌晦涩的名词与多层微服务抽象。能用最朴素、具象的语言把复杂逻辑讲明白的人,才是真正吃透了问题本质的人;
- 硬件亲和性大于理论炫技:在现代算力生态下,算法的设计必须与底层硬件执行模型(SIMD/SIMT、内存带宽、显存层级)高度契合。看似高大上的理论模型,若无法在芯片上实现高并发映射,终究只是空中楼阁;
- 真正的伟大不需要浓妆艳抹:当一个想法具有颠覆时代的潜力时,最诚实、最清晰的表达就是最具震撼力的宣言。
原文链接与参考资料
- X (Twitter) 讨论原文:@v0xium on X: "Attention Is All You Need is one of the best written papers..."
- 论文原始出处:Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, Ł., & Polosukhin, I. (2017). Attention Is All You Need. arXiv:1706.03762. https://arxiv.org/abs/1706.03762
- 保罗·罗默关于伪数学化的论述:Paul M. Romer. Mathiness in Business Cycle Theory. American Economic Review, 2015.