
如何让每天 300 轮 CI 提速 50%?Ekstazi 与 Google TestSage 精准测试顶会论文研读
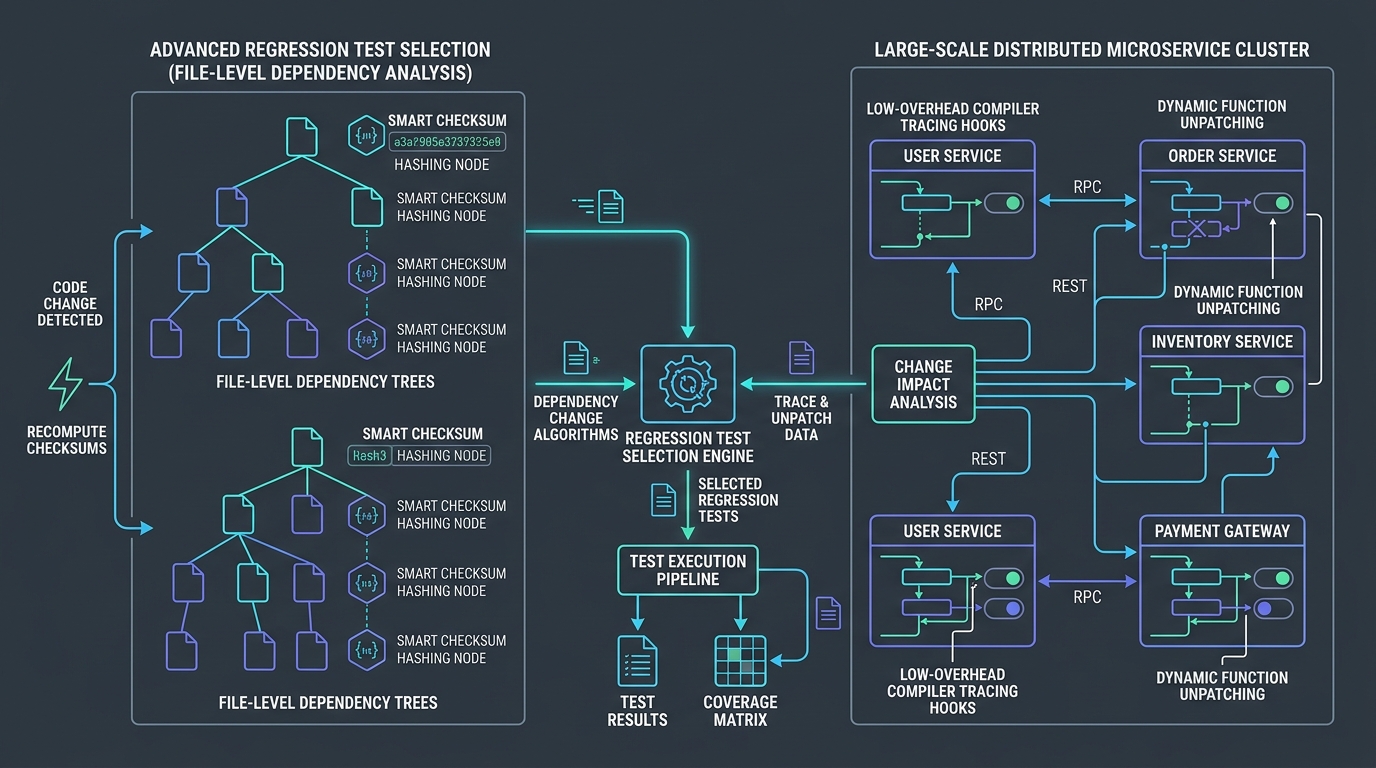
在上一篇关于 Vibe Coding 质量防线的探讨中,我们提到了高频交付团队的痛点:当 AI 驱动代码产出呈指数级激增,团队每天上线 50 次、流水线触发 300 轮 CI 时,全量测试的执行耗时与庞大算力开销将成为阻断交付的致命瓶颈。
此时,精准测试(Regression Test Selection, RTS)成为了现代效能工程的唯一解。但市面上多数团队自研或引入的测试选择工具,要么漏测频发,要么分析本身耗时甚至超过了跑测试的时间。
在精准测试近四十年的演进史上,有两篇里程碑式的学术与工业顶会论文彻底改变了该领域的工程范式:
- 《Practical Regression Test Selection with Dynamic File Dependencies》(ISSTA 2015 杰出论文奖,来自 UIUC 团队的 Ekstazi);
- 《TestSage: Regression Test Selection for Large-scale Web Service Testing》(ICST 2019 Industry Track,来自 Google Assistant 核心团队)。
这两篇经典论文究竟解决了什么看似无解的工程矛盾?它们给今天处于 AI 编码狂潮中的微服务与前后端流水线带来了哪些不可替代的架构启示?本文将带你展开一次透彻的端到端深度论文拆解。
1. RTS 经典三阶段与学术界三十年的“细粒度陷阱”
精准测试(RTS)的核心目标,是在代码发生局部变更时,仅挑选出可能受影响的测试子集运行,安全跳过无关测试。
无论何种 RTS 体系,经典工程模型都包含三个标准阶段:
- 分析阶段(Analysis, A):对比代码变更与已知依赖,决定当前提交需要运行哪些测试;
- 执行阶段(Execution, E):仅执行选出的测试子集;
- 采集阶段(Collection, C):监控测试执行过程,记录并持久化每个测试用例所访问的代码或文件依赖图,供下一次分析使用。
flowchart LR
    subgraph Traditional_RTS ["传统细粒度方法级 RTS 的端到端耗时"]
        direction TB
        A1["分析阶段 (A): 昂贵的 AST / 方法调用图 Diff (耗时长)"] --> E1["执行阶段 (E): 极简测试集 (耗时极短)"]
        E1 --> C1["采集阶段 (C): 繁重的字节码/语句级动态插桩 (耗时极长)"]
    end

    subgraph Ekstazi_RTS ["Ekstazi 文件级动态 RTS 的端到端耗时"]
        direction TB
        A2["分析阶段 (A): 毫秒级文件 Checksum 哈希比对"] --> E2["执行阶段 (E): 适度测试集 (执行耗时适中)"]
        E2 --> C2["采集阶段 (C): 类加载器与 IO 级文件追踪 (开销极低)"]
    end
1.1 为什么细粒度方法级 RTS 在工业界寸步难行?
自 1980 年代以来,学术界产出了数百篇关于 RTS 的论文,但绝大多数从未在真实生产中落地。原因在于学术界长期陷入了 “测试用例选择数量最小化” 的执念。
以学术界经典工具 FaultTracer 为例,它们试图将依赖精确到 函数级(Method-level) 甚至 语句级(Statement-level):
- 为了安全地判断一个方法是否受影响,必须分析复杂的面向对象语义:方法重写(Overriding)、多态分发、静态初始化块、类构造函数、字段访问、乃至反射调用;
- 残酷的工程代价:为了“少跑两个测试”,分析阶段(A)需要解析庞大的代码语法树(AST)并计算图交集,采集阶段(C)需要进行沉重的动态追踪。结果在端到端总时间(Wall-clock Time = A + E + C)上,细粒度 RTS 耗费的总时间往往比把所有测试闭着眼睛跑一遍还要漫长!
2. Ekstazi 的破局哲学:文件级粗粒度与智能哈希
来自伊利诺伊大学厄巴纳-香槟分校(UIUC)的 Milos Gligoric 等人在 ISSTA 2015 发表的 Ekstazi,以一种极具工程实用主义的哲学打破了僵局。
2.1 核心思想:以文件/类为依赖粒度(File-level Dependency)
Ekstazi 提出了一个极富洞察力的反直觉论点:哪怕在执行阶段(E)略微多跑几个测试,只要能把分析(A)和采集(C)的开销压缩到近乎为零,端到端总耗时就能实现断崖式下降。
Ekstazi 将依赖粒度放大到 文件级(File / Class level):
- 每个测试用例不再追踪调用了哪些具体的函数,而是记录其在运行期间加载了哪些
.class二进制字节码文件,以及通过文件 IO 读取了哪些外部资源文件; - 如果代码变更修改了某个类
D.class,那么所有依赖了类D的测试类/测试方法全部被标记为命中。
2.2 摆脱版本控制系统(Zero VCS Dependency)与智能哈希
传统 RTS 工具高度耦合 Git / SVN 等版本控制系统,必须依赖 Git Diff 来计算修改。而 Ekstazi 甚至不需要知道老版本代码长什么样:
- 哈希快照替代差异比对:Ekstazi 为每个测试实体生成一个轻量依赖记录文件,存储其运行时所接触文件的名称及其 MD5 校验和(Checksum);
- 毫秒级判定:分析阶段只需极速扫描当前测试依赖清单中的文件,计算当前磁盘上的 Checksum 是否发生变动。若完全一致,直接跳过;若不一致或属于新增测试,立即执行;
- 智能校验和(Smart Checksums):
- 源代码虽然改变(例如调整了代码格式、添加了空行、改写了注释),但编译出的字节码语义可能完全等价;
- Ekstazi 能够解析
.class文件的内部结构,在计算 Checksum 时自动剔除调试行号表(LineNumberTable)、局部变量名、以及无语义影响的编译期注解。这使得大量无害的重构与排版变更不会触发多余的测试重跑。
// Ekstazi 内部对类加载的轻量动态插桩逻辑示例
public class ClassLoadingMonitor {
    public static void onClassLoaded(Class<?> clazz) {
        // 获取类对应的真实磁盘文件或 JAR 包内路径
        URL resource = clazz.getResource(clazz.getSimpleName() + ".class");
        if (resource != null && "file".equals(resource.getProtocol())) {
            String filePath = resource.getPath();
            // 将文件记录到当前测试实体的活动依赖集合中
            ActiveTestContext.recordDependency(filePath);
        }
    }
}
2.3 宽松集成与 JVM 启停优化
Ekstazi 设计了与构建系统(Maven / Ant / Gradle)的两种集成模式:
- 紧密集成(Tight Integration):直接拦截测试框架(JUnit)内部的运行逻辑,在单进程内按需跳过测试方法;
- 宽松集成(Loose Integration):在构建系统准备生成测试类执行计划前,直接生成
excludes排除列表。对于为每个测试类独立 Fork 新 JVM 进程的大型工程,这能彻底避免启动新 JVM 与类加载的巨大固定开销。
[!TIP] 实证成果
论文在 32 个知名开源项目(涵盖 Apache Camel、CXF、Commons Math 等,累计近 500 万行代码、615 个历史提交)上进行了详尽测试。结果表明:Ekstazi 平均减少了 32% 的端到端构建耗时,在长耗时测试套件中更实现了 54% 的耗时削减,一举赢得了 ACM SIGSOFT 杰出论文奖。
3. 分布式巨无霸的质检挑战:Google TestSage 的微服务解法
Ekstazi 解决了单进程或单体代码库的单元测试与轻量集成测试问题。但当战局转移到大型分布式 Web 服务与复杂微服务集群时,传统 RTS 面临着全新的工程深渊。
在 ICST 2019 上,Google 团队发表了关于 Google Assistant 后台架构的精准测试工业实践:TestSage。
3.1 Web 服务集成测试的三重死穴
Google Assistant 每天承载数亿台设备的语音与语义请求,后端由极其庞大的 C++ 微服务集群构成,每天有超过 400 次代码合并提交。其自动化测试大多是跨进程的 E2E 接口与场景测试:
- 跨进程契约断裂:测试用例运行在测试客户端机器上,通过 RPC 跨网络调用远端服务器集群。测试客户端与被测服务(SUT)处于物理隔离的进程与环境中,无法通过类加载器或本地内存直接捕获代码依赖;
- 依赖数据海量膨胀:一条端到端自然语言查询测试(如“查询今天的天气”),在后端会穿透路由、鉴权、自然语言理解(NLU)、搜索、用户画像等数十个子系统,触发上百万次函数调用。全量采集 trace 数据会直接压垮存储并导致测试严重卡死;
- 多语言与非功能性代码实体(Non-functional Entities):C++ 代码不仅包含可执行函数(Functional),还包含海量宏定义(Macros)、全局常量、结构体与头文件变更。
sequenceDiagram
    autonumber
    participant TestRunner as TestSage 测试运行器
    participant VCS as Piper 版本控制系统
    participant SUT as Google Assistant 微服务集群 (SUT)
    participant XRay as LLVM XRay 动态运行时

    Note over TestRunner,VCS: 分析阶段 (A) - 秒级前置门禁
    TestRunner->>VCS: 获取本次提更改动的函数与静态传递闭包
    TestRunner->>TestRunner: 结合预存依赖库反查受影响测试集

    Note over TestRunner,SUT: 执行阶段 (E) & 采集阶段 (C)
    TestRunner->>SUT: RPC 启动追踪间隔 (Trace Interval)
    SUT->>XRay: 激活 XRay 覆盖率模式 (Coverage Mode)
    TestRunner->>SUT: 发送测试端到端业务 RPC 请求

    activate SUT
    Note over SUT,XRay: 首击采样:首次命中即 Unpatch 还原为原生机器码!
    SUT-->>TestRunner: 返回业务响应
    deactivate SUT

    TestRunner->>SUT: RPC 停止追踪间隔
    SUT->>TestRunner: 异步回传本次测试去重后的函数依赖列表
3.2 架构创新一:基于 LLVM XRay 的“首击即卸载”极速探针
为了在生产级 C++ 服务上无感采集函数调用,Google 摒弃了传统的 Gcov 或 Valgrind 等性能损耗高达数十倍的重型工具,创新性地基于 LLVM XRay 打造了定制的测试覆盖率探针:
- 编译期预埋跳板(Sleds):Clang 编译器在每个函数的入口和出口处插入特定的无害占位指令(如 16 字节的
nopw指令与专用 Jump 空间),对二进制性能几乎零影响; - 算法创新:CoverageHandler 首次命中即卸载:
- 默认的 XRay 会记录每一次函数进出,产生海量 Trace 日志;
- TestSage 自定义了
Coverage Mode:当某个函数在当前测试间隔中第一次被执行命中时,记录该函数已覆盖,随后立刻通过内存补丁(Unpatch)将该函数的探针还原为原生空指令! - 后续数万次对该函数的循环调用,将以 100% 的原生纯机器码速度执行,开销归零。
// TestSage 的 XRay 覆盖率核心处理算法伪代码
void CoverageHandler(int32_t FuncId, XRayEntryType Type) {
    if (g_CoverageModeEnabled) {
        // 1. 核心关键:一旦该函数被调用过一次,立即动态卸载探针,后续调用零开销!
        __xray_unpatch_function(FuncId);

        // 2. 记录当前函数已被本次测试覆盖
        LogFunctionHit(FuncId);
    } else {
        // 传统的性能分析轨迹记录模式...
    }
}
3.3 架构创新二:静态与动态混合补全(Bridging Functional & Non-Functional)
XRay 只能捕获动态执行的可执行函数。如果开发者仅仅改动了一个 const double TIMEOUT_MS = 5000; 或者修改了一个 C++ 宏定义,XRay 根本感知不到对应代码被“执行”。
TestSage 引入了静态分析传递闭包来弥合这一致命漏测缺口:
- 动态阶段利用 XRay 获取测试用例执行的功能性函数集合
FE; - 静态阶段遍历 Google 庞大的代码索引库,针对每个函数
fe ∈ FE,计算其所引用的所有非功能性实体(全局变量、宏、类型定义)的静态传递闭包NE; - 最终将
FE ∪ NE联合作为该测试的真实完整依赖集合,彻底确保了测试选择的完备性与安全性(Safety)。
3.4 架构创新三:双轨不对称架构(Pre-submit TestP 与 Continuous TestC)
Google 团队在工程落地中最精妙的架构决策,在于彻底打破了“每次测试都要采集依赖”的思维定势,推行了双轨非对称调度:
flowchart TD
    subgraph PreSubmit ["TestP: 提交前 Pre-submit 极速门禁 (日均 400+ 次)"]
        PR["开发者提交代码"] --> FetchDep["复用 TestC 异步产出的最新依赖拓扑"]
        FetchDep --> QuickFilter["执行秒级轻量测试过滤"]
        QuickFilter --> RunSubset["仅运行命中测试 (关闭 XRay 采集,耗时削减 50% 以上)"]
        RunSubset --> Merge["快速放行合并"]
    end

    subgraph Continuous ["TestC: 异步持续回归套件 (每 2 小时轮询)"]
        HeadSync["同步最新 HEAD 主干"] --> FullXRay["启用 XRay 覆盖模式执行测试"]
        FullXRay --> GenGraph["后台离线生成新一代精确依赖矩阵"]
        GenGraph -. "异步推流广播" .-> FetchDep
    end
- TestP(提交前门禁):开发者每次提交代码前触发。由于开发者急切需要几分钟内拿到反馈,TestP 阶段彻底关闭动态采集(Collection 阶段被砍掉),它直接复用由后台流水线提前计算好的最新依赖图,扮演一台纯粹的“极速过滤器”;
- TestC(持续集成流):每 2 小时在主干 HEAD 上执行一轮完整测试,在此阶段以独占间隔开启 XRay 追踪,负责离线刷新与发布全站最新的测试用例依赖图;
- 工程妥协与容错:Pre-submit 阶段依赖的图谱可能存在至多 1 ~ 2 小时的微小版本时差,但 Google 的实证数据证明,这一微小窗口在统计学上极罕见造成漏网之鱼,却为上千名工程师换回了每天数以万计小时的研发等待时间。
[!IMPORTANT] 实战效能收益
在连续 32 天针对 Google Assistant 核心服务的跟踪评测中:
- TestP 提交前门禁平均仅挑选了 44.74% 的测试执行,安全跳过了超过 55% 的无关测试,在 Borg 集群上减少了过半的计算核时;
- TestC 周期全量套件即便在承担所有追踪与采集开销的情况下,依然净节约了 34% 的端到端测试耗时。
4. Ekstazi 与 TestSage 深度对比与架构选型指南
两篇顶会论文分别代表了单体/组件级与大规模分布式场景下的巅峰之作。我们将其核心工程维度对比如下:
| 架构维度 | Ekstazi (ISSTA 2015) | Google TestSage (ICST 2019) |
|---|---|---|
| 主攻场景 | 单进程库、组件、单体应用、单元与集成测试 | 大规模跨网络、多层微服务集群、端到端接口测试 |
| 依赖跟踪粒度 | 文件级 / 类级(粗粒度最优解) | 函数级 + 静态非功能实体传递闭包 |
| 动态插桩底层 | Java 类加载器监控 + 字节码轻量注入 | LLVM XRay 跳板指令 + 首次命中内存动态还原 |
| 对版本库依赖 | 零依赖(基于纯 Checksum 校验和比对) | 依赖版本库(Piper)提供的函数级变更 Diff |
| 管线调度模式 | A / E / C 三阶段在单次运行中闭环或松耦合 | 双轨非对称(提交前纯过滤 vs 周期流跑全量采集) |
| 核心避坑杀手锏 | 智能 Checksum(忽略行号、注释与格式) | 覆盖率首击卸载(Unpatch)+ 静态传递闭包补漏 |
| 典型耗时收益 | 总体节约 32% ~ 54% 端到端时间 | 筛选率 44.7%,跳过 55%+ 无关端到端测试 |
5. 现代工程团队落地精准测试的行动指南
结合两篇论文的深刻洞见,对于今天正在使用 Node.js / TypeScript (Vitest)、Go、Java、Rust 构建系统的工程团队,如果希望落地一套高可靠、低开销的精准测试系统,可以遵循以下四条工程法则:
法则 1:拒绝过早追求函数级粒度,从“文件级”开始搭建
千万不要一开始就试图去解析复杂的 AST 函数调用链。基于模块导入关系(如 ESM / CommonJS 依赖树,或编译产物文件指纹)做文件级精准反查,能够在付出 10% 复杂度的前提下,收获 80% 以上的时间节约红利。
法则 2:将“依赖采集”从高频提交链路中剥离
如果你的集成测试依赖收集需要耗费额外时间,务必学习 Google TestSage 的非对称架构:
- 在 PR / Commit 校验的高频流水线中,只做基于缓存图谱的只读测试选择;
- 在夜间(Nightly)或定时流水线中,异步跑全量测试并更新全局测试依赖矩阵。
法则 3:引入远程依赖与 Checksum 缓存中心
借鉴 Ekstazi 的 Checksum 思想,将测试实体的依赖签名文件持久化至远程缓存(如 S3、Redis 或 CI Cache)。分析阶段只需拉取指纹对比 Hash,无需检出历史代码,实现真正的秒级响应。
法则 4:永远保留“逃生舱”兜底门禁
精准测试系统必须具备自动降级策略。一旦检测到下列变更,系统应自动绕过精准测试,强制触发全量回归:
- 核心基础设施或基础镜像升级;
- 全局环境变量、公共配置中心定义变动;
- 数据库持久层 Schema 迁移脚本(Migration);
- 核心依赖库(
package.json/go.mod)的重大版本升级。
6. 结语
软件工程的艺术,往往体现在对局部完美的克制与对全局效率的把控中。
三十年前的学者们为了追求理论上的“最少测试用例”,让 RTS 沦为了象牙塔内的概念游戏;而 Ekstazi 用粗粒度文件哈希唤醒了工业界的实用主义,Google TestSage 则用 LLVM XRay 动态卸载与非对称双轨架构攻克了微服务分布式调用的巍峨高墙。
在 AI 编码呼风唤雨的今天,理解并吸纳这些历经真实工业淬火的技术思想,正是我们打破 CI 算力桎梏、构筑坚固软件护城河的底气所在。