
走出 Vibe Coding 质量陷阱:从“自证清白”的虚假测试到日均 50 次发布的精准防线
随着 Claude Code、Cursor、Cline 等 AI 编码工具的全面普及,软件工程步入了烈火烹油的 “Vibe Coding” 狂欢。当生成语法合规的代码变得几乎零成本,代码产出呈十倍级暴涨,但软件的最终交付质量却普遍没有提升,甚至引爆了灾难性的维护危机。
资深架构师姚钢强(@yaogangqiang)在社交网络分享了来自一线创业团队的残酷共鸣:“由于 AI 堆砌出的 Bug 太多,团队天天在修 Bug,稍微长期来看,甚至觉得人肉写代码的速度更快。”面对此景,很多人脱口而出的解法是:“让 AI 给自己写测试不就行了吗?”
然而,现实往往走向另一个极端:AI 自动生成的测试,几乎全都是充满 Mock、严重绑定实现细节的脆弱测试,甚至沦为“用自己的实现来证明自己没错”的自证清白。 软件测试从来不是高质量的救命稻草——“Quality is designed in, not tested in”。面对日均 50 次线上发布、每天 300 轮 CI 的高压环境,工程团队究竟该如何筑起坚不可摧的质量防线与精准测试体系?
1. “方形轮子”陷阱:为什么海量测试换不来软件质量?
在讨论如何写好测试之前,我们需要厘清软件研发历史上一个永恒的常识:写代码,历来就是整个软件工程链路中最容易、最廉价的环节。
AI 时代的降临,只是把这个原本就容易的环节变得更加廉价与迅猛。但软件工程的本质挑战——系统设计的合理性、业务边界的严谨性、状态流转的自洽性、容灾降级与契约一致性——从来没有因为生成速度的提升而消失。
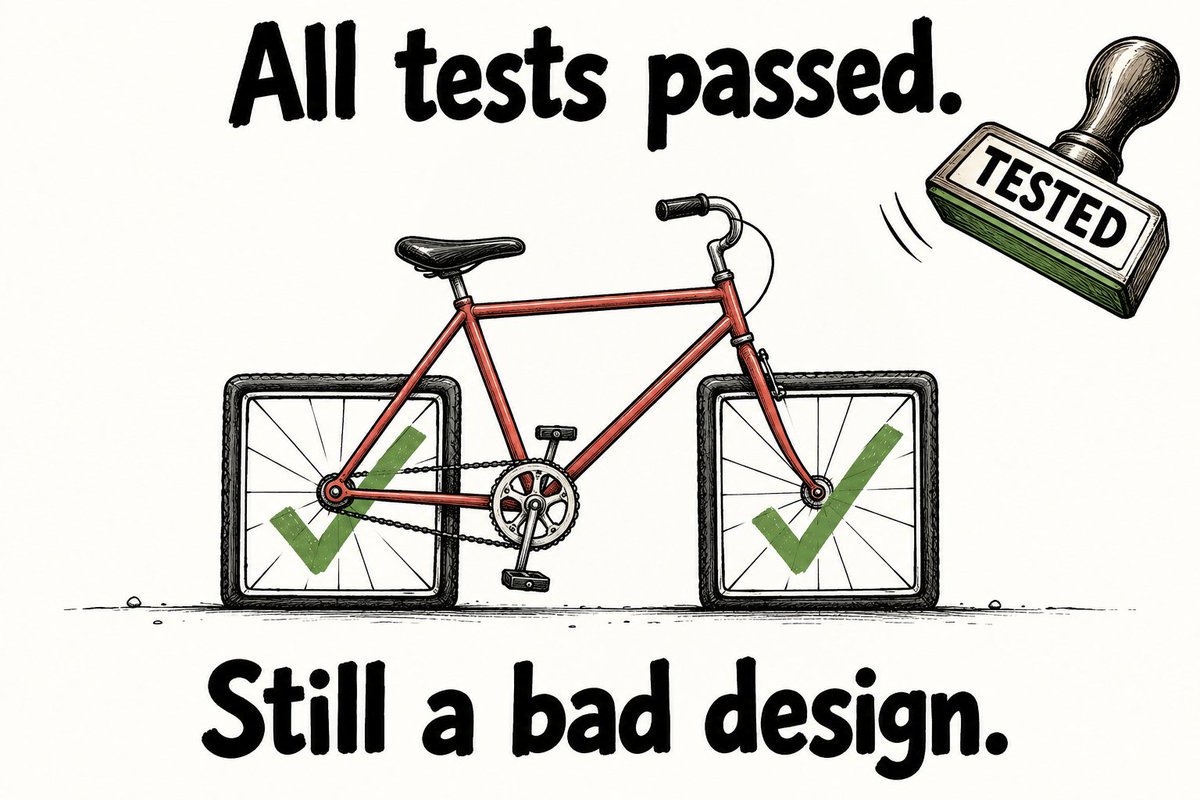
下图生动揭示了当下 Vibe Coding 团队最容易陷入的荒诞现状:
1.1 戴明质量定律与自证清白的死循环
现代质量管理大师威廉·爱德华兹·戴明(W. Edwards Deming)早在数十年前就提出了经典论断:“Quality is designed in, not tested in”(质量是设计出来的,不是检验出来的)。
把这一定律放到当下的 AI 编码语境中,尤为震聋发聩:
- 测试只能证明缺陷存在,不能证明没有缺陷;
- 如果系统架构本身设计拙劣、职责模糊、状态混乱,哪怕给它套上 100% 的单元测试,它依然只是一辆“通过了所有出厂检验的方形轮子自行车”;
- 自证清白(Tautological Tests):如果不做严格的工程调教,直接让 AI “为刚写好的函数补全单测”,AI 会本能地顺着刚才写好的私有逻辑,去 Mock 所有外部调用,断言刚才写出的分支。这本质上是用自己的错误实现来证明自己的正确性,一旦业务重构,测试瞬间碎成一地,而在真实生产环境中只要输入稍有偏差,系统依然瞬间崩溃。
另一幅在技术社区引发广泛共鸣的漫画,更加直击本质:
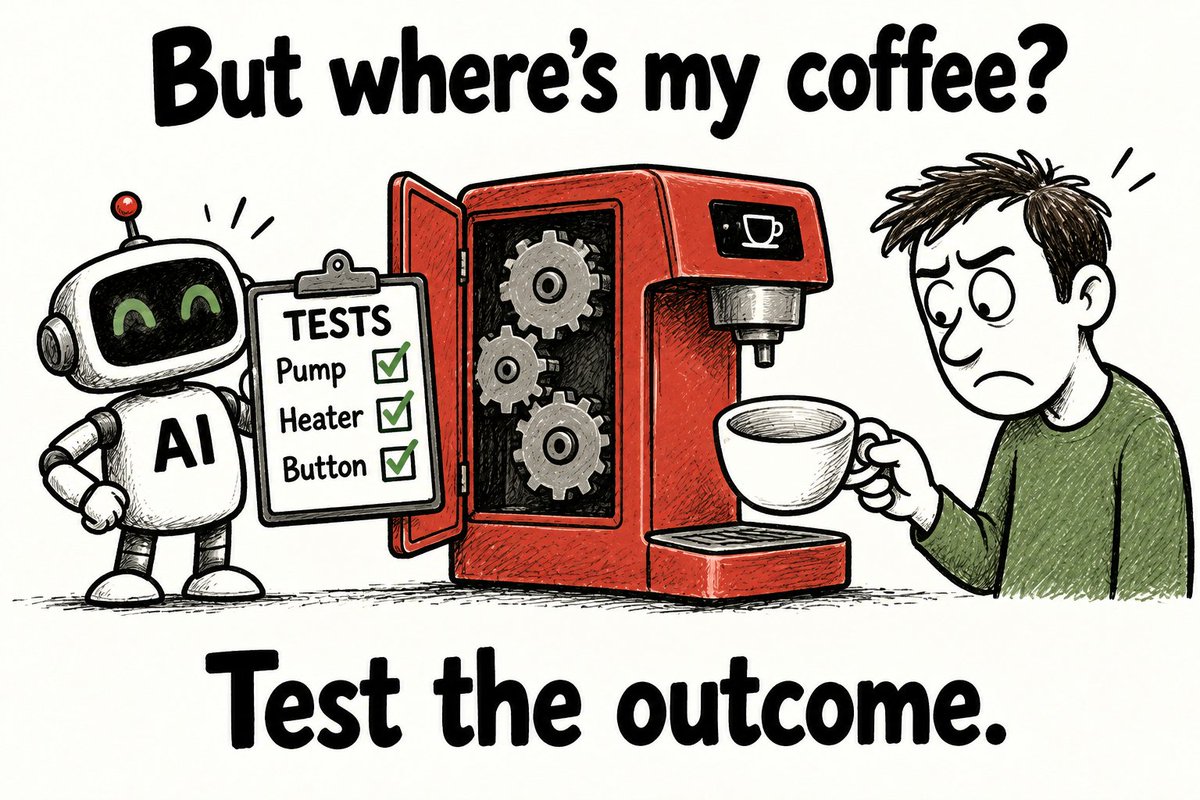
AI 机器人兴奋地拿着一张打满绿勾的测试单:“水泵测试通过!加热器测试通过!开关按键测试通过!”——然而站在咖啡机面前的用户,端着的却是一只空空如也的咖啡杯。
“Test the outcome, not the implementation.” 这正是业务工程测试的第一性原理。
2. 业务项目测试的六条硬核工程铁律
为了打破“AI 狂写垃圾测试”、“测试臃肿导致 CI 瘫痪”的恶性循环,结合姚钢强在一线高频研发团队的实操沉淀,我们梳理出针对 AI 编码时代业务系统的六条核心法则:
铁律一:测试行为,不测试实现(Behavior over Implementation)
在测试理论中,长期存在 经典学派(Detroit / Classical School) 与 伦敦学派(London / Mockist School) 的分野:
- 伦敦学派偏爱细粒度白盒 Mock,关注对象之间的函数调用次数与参数传递(Interaction Testing);
- 底特律学派主张状态验证与黑盒契约,尽量引入真实协作对象,关注输入与最终可见结果(State Verification)。
在人肉编码时代,过度使用 Mock 尚且会导致维护成本飙升;而在 AI 编码时代,AI 本能地表现为一个极端且懒惰的伦敦学派开发者。它极其擅长把所有依赖全盘 Mock 掉,测试某个私有方法是否被调用了 1 次。
// ❌ 错误示范:测试实现细节(极其脆弱,业务没变,重构即崩)
test('should call payment gateway once', async () => {
  const mockGateway = { charge: vi.fn() };
  const service = new OrderService(mockGateway);
  await service.checkout({ orderId: '123' });
  expect(mockGateway.charge).toHaveBeenCalledTimes(1); // 关注了私有调用
});

// ✅ 正确示范:测试业务行为(关注用户可见结果与状态自洽)
test('user should not be charged twice when retrying duplicate order', async () => {
  const user = await createTestUser({ balance: 100 });
  const order = await createTestOrder(user, { amount: 50 });

  // 模拟弱网抖动下的并发与重复请求
  const [res1, res2] = await Promise.all([
    client.post(`/orders/${order.id}/pay`),
    client.post(`/orders/${order.id}/pay`),
  ]);

  // 验证结果:只有一次扣款成功,用户余额严格自洽
  const updatedUser = await getUser(user.id);
  expect(updatedUser.balance).toBe(50);
});
判断基准:业务需求完全没变,仅仅因为代码重构优化了内部数据结构,如果测试碎了一地,那么这组测试从一开始就写错了。
铁律二:BDD 前置,先写验收场景再写业务代码
绝对不要让 AI 写完代码之后再去补测试。
一旦代码先生成,AI 的注意力窗口便已被自己的实现所锚定。正确的敏捷管线应当推行行为驱动开发(BDD, Behavior-Driven Development):
- 统一语言:测试用例描述一律以
user或业务角色开头,严格按照Given / When / Then结构展开; - 人类与 PM 可读:验收用例不仅是开发规约,更是跨角色对齐产品意图的真理源;
- 前置红灯驱动:先由人或引导 AI 产出清晰的 BDD 场景文件,确认其能够真实报错(Red),再让 Agent 进行功能实现,直至测试全部转绿(Green)。
Scenario: 积分抵扣逾期判定
  Given 用户拥有 500 积分且购物车金额为 100 元
  When 用户在结账页勾选“使用积分全额抵扣优惠券”
  And 该优惠券有效期已于 1 小时前截止
  Then 系统应当拒绝抵扣并返回明确的“优惠券已失效”友好提示
  And 用户的 500 积分账户应当保持未扣减状态
铁律三:严厉禁 Mock,真实容器与契约测试注入
“Mock 一时爽,上线火葬场。”随手 Mock 是 AI 制造虚假质量幻觉的罪魁祸首。在现代容器化与轻量化基础设施成熟的今天,完全可以做到拒绝无谓 Mock:
- 真实数据库优先:
- 对于 PostgreSQL,测试环境优先运行真实容器(如 Testcontainers),或采用轻量嵌入式的 PGlite(Wasm 版 PostgreSQL 内核,毫秒级启停,内存完全隔离);
- 对于 Redis,可直接启动原生单机实例或基于内存的严谨协议级替换;
- 外部不可控系统采用 Fake + 契约测试(Contract Testing):
- 诸如 AWS S3、Stripe 支付网关、短信发送服务等外部第三方,本地无法直连时,允许注入团队维护的 Fake 实现;
- 硬性红线:Fake 必须与真实第三方服务定期跑契约一致性测试,确保第三方接口变更时,Fake 能够第一时间感知识别;
- 时钟逻辑禁止暴力 Sleep:
- 涉及定时任务、超时重试、缓存过期的逻辑,严禁在代码中写
await sleep(3000)然后祈祷; - 必须使用严谨的模拟定时器(Fake Timers,如 Vitest 的
vi.useFakeTimers()),通过快进时钟(vi.advanceTimersByTime())进行确定性验证。
- 涉及定时任务、超时重试、缓存过期的逻辑,严禁在代码中写
铁律四:重 E2E 闭环与按需分级
很多传统敏捷教练言必称“测试金字塔”(大量单测、中量集成、少量 E2E)。但在业务高速迭代、AI 重构频繁的当下,从用户入口到可见输出的 E2E 粗粒度测试,反而具有最高的投资回报率(ROI)与架构韧性。
- 广义 E2E:这里的 E2E 并不是必须启动重型浏览器进行缓慢的 UI 点击,而是从服务顶层入口(HTTP / RPC / CLI)直达底层持久化状态与下游输出,跨越所有真实内部模块;
- 分级治理:随着业务膨胀,全量跑 E2E 必然拖慢 CI。必须引入依赖分析与分级策略,核心业务高频跑,非核心周期跑。
铁律五:理性审视分支覆盖率,深挖“未测的 10%”与变异测试
给工程团队设定一个 90% 的分支覆盖率(Branch Coverage)作为参考线是健康的,但切忌陷入古德哈特定律(Goodhart's Law:当指标变成目标时,它便不再是一个好指标):
- 重点不在于覆盖的 90%,而在于剩下的 10% 为什么没测:
- 核心关注失败路径(Failure Paths)、超时熔断、网络分区、反压与并发竞态;
- 严禁让 AI 为了冲刺 100% 覆盖率去编造毫无业务价值的垃圾断言;
- 引入变异测试(Mutation Testing):
- 真正检验测试好坏的终极手段,是故意改坏业务代码中的一处逻辑(例如将
>=改为>,或者删掉一行扣库存操作),看测试套件是否会立刻飘红(Kill the Mutant); - 无法识别代码变异的测试套件,覆盖率再高也只是纸糊的马奇诺防线。
- 真正检验测试好坏的终极手段,是故意改坏业务代码中的一处逻辑(例如将
铁律六:将规则全部代码化为 Lint 门禁
工程文化不能靠口头宣导或 Prompt 祈祷,必须将所有共识翻译为静态代码检查规则(Linter):
- 编写 ESLint / Biome 自定义规则,禁止测试代码中直接引入
vi.mock()/jest.mock(); - 禁止测试描述中出现不规范命名的非 BDD 句式;
- 检查异步测试中裸调用的
setTimeout; - 在 Git Pre-commit 与 CI 阶段直接硬性拦截违规测试。
3. 高吞吐 CI 破局:日均 50 次上线背后的 300 轮测试优化
写对了高质量测试,接下来面临的将是另一座大山:性能与成本。
在 Vibe Coding 驱动下,代码迭代节奏被加速到极致。以姚钢强负责的研发团队为例:团队一天上线 50 次,一天至少要跑 300 轮 CI 测试。
如果每次提交都要傻傻地等待 20 分钟的全量回归测试,整个团队的生产力将直接被 CI 队列锁死。如何在“保证不漏测”与“极致轻快”之间取得最佳平衡?
flowchart TD
    Commit["开发者提交代码 PR / Push"] --> Diff["源码变更精准分析 Code Diff"]
    Diff --> CheckConfig{"涉及全局配置/依赖/DB迁移?"}

    CheckConfig -- 是 --> FullRun["调度全量回归测试套件 Full Suite"]
    CheckConfig -- 否 --> RTS["执行 Ekstazi 文件级精准测试筛选"]

    RTS --> RunT0["立即执行 Tier 0: 核心 BDD + 受影响测试集"]
    RunT0 --> PassT0{"Tier 0 绿灯通过?"}

    PassT0 -- 否 --> Block["拦截发布 / 开发者快速修复"]
    PassT0 -- 是 --> Deploy["直接放行 50 次/日 极速生产部署"]

    Deploy -. "异步触发" .-> HourlyQueue["进入离线聚合队列"]
    HourlyQueue --> RunT1["Tier 1: 每小时集中跑一轮全量长耗时回归"]
3.1 精准测试(Regression Test Selection, RTS)的工程落地
精准测试的核心逻辑在于:通过构建测试用例与源码文件的依赖映射网络,反查源码变更(Git Diff)具体波及了哪些测试,只挑出受影响的测试子集来执行。
虽然 Vitest 等现代测试框架自带了简单的变更监听,但其在复杂业务工程中由于动态导入与全局副作用,往往效果有限。在工业界,关于精准测试通常有两种技术流派:
| 维度 | 函数/方法级精准测试 (Method-level RTS) | 文件/模块级精准测试 (File-level RTS) |
|---|---|---|
| 选中的测试量 | 理论上最小,跳过的无关测试最多 | 略微保守,会多跑一些同文件内相关测试 |
| 分析与采集开销 | 极高(需精确到 AST 方法调用链与动态插桩) | 极低(基于文件系统、模块导入依赖树与运行时跟踪) |
| 工具链维护成本 | 复杂,容易因动态反射、动态语言特性导致漏选 | 简单健壮,开箱即用,执行确定性高 |
| 综合节省的总时间 | 往往被高昂的依赖采集与比对耗时抹平 | 工业实战最优解(兼顾准确率与极速响应) |
在工业落地中,姚钢强和学术界的顶会成果给出了完全一致的答案:坚决选择文件级精准测试。
这里有两篇具有里程碑意义的顶级学术论文深入论证了这一点,非常值得工程团队精读:
- 《Practical Regression Test Selection with Ekstazi》(ISSTA 2015 ACM SIGSOFT 杰出论文奖,UT Austin 团队出品):
- 论文通过在十多个大型开源项目上的长期对比实证,揭示了一个反直觉的真相:细粒度(方法级)测试选择虽然能少跑几条测试,但在追踪依赖图、收集测试轨迹上的元数据计算开销巨大;相比之下,基于文件级粒度的 Ekstazi 工具在实际运行中综合耗时显著更短,工程鲁棒性极高;
- 《TestSage: A Hybrid Test Selection Tool for Large-Scale Web Services》(ICST 2019,Google 联合伊利诺伊大学团队出品):
- 详述了 Google 超大规模 Web 服务如何通过“动态运行时日志追踪 + 静态 AST 依赖图分析”相结合的混合模式,精准剔除不需要重跑的测试,每年为 Google 节省数以百万计的计算核心工时。
[!NOTE] 全局变更的豁免原则
文件级精准测试必须设立防御底线:一旦发生全局共享配置变更、公共初始化模块变动、或者数据库 Schema 迁移,系统必须自动回退至全量回归测试模式。
3.2 科学的测试分层调度(Test Tiering)
有了 BDD 场景和精准测试作为基础,团队就能够游刃有余地实施清晰的“双轨分层调度”:
- Tier 0(核心前置门禁,每次提交秒级触发):
- 仅包含核心主干业务路径(P0 Happy Paths)+ 精准测试反查出的变更影响子集 + 本次新增与修改的测试用例;
- 耗时严格压在 2 ~ 3 分钟以内,直接决定是否允许合并主干与上线;
- Tier 1(非核心长尾回归,每小时集中轮询):
- 只要代码有改动,由后台 CI 队列每隔一小时触发一轮全量跑;
- 工程哲学权衡:部分非核心旁路问题可能会被推迟数十分钟暴露,但这换来了团队核心链路一天部署 50 次的绝对敏捷性,这在业务竞争中是极为划算的架构取舍。
3.3 警惕 Runner 硬件陷阱与并发反噬
很多团队在发现 CI 跑得慢时,第一反应往往是盲目调大并行度(例如在 Vitest / Jest 中盲目把 --threads 或 --maxWorkers 拉满)。然而监控数据往往会泼上一盆冷水:并发开得越大,跑得反而越慢。
- IO 与上下文切换瓶颈:业务测试往往伴随着文件读写、本地内存数据库启动与网络套接字监听。过高的并发会导致严重的磁盘 IO 争抢与 CPU 调度抖动;
- 自建 Runner(Self-hosted Runner)的降本奇效:
- GitHub Actions 等托管云端 Runner 每次运行都需要冷启动虚拟机、重复拉取镜像和重装依赖,网络和 IO 性能中规中矩且收费昂贵;
- 切换至团队自建且针对性优化的物理机/裸金属本地 Runner(预热 Docker 缓存、配置高性能 NVMe SSD、在 RAM Disk / tmpfs 中挂载临时数据库),不仅测试耗时断崖式下降 50% 以上,硬件成本更远低于公有云计费。
4. 总结:AI 时代的卓越工程师范式
Vibe Coding 绝不等于“肆意堆砌未经验证的垃圾代码”。相反,当写代码的门槛被彻底抹平之后,架构设计的严谨度、对业务契约的敏锐度、以及质量管线的工程化能力,成为了区分顶级工程师与平庸拼贴者的唯一标尺。
从拒绝“装配了方形轮子的测试自行车”,到抵制“缺少咖啡交付的自证清白”;从坚守 BDD 行为验证、驱逐无谓 Mock,再到日均 300 轮 CI 压力下精准测试与自建 Runner 的运筹帷幄——构建这套高可用防线,正是我们在 AI 浪潮中保持清醒、持续稳健交付的立身之本。