
代码即视频(Code-as-Video):解密 Claude Opus 5.5 如何靠前端代码与无头浏览器逐帧画出动效大片
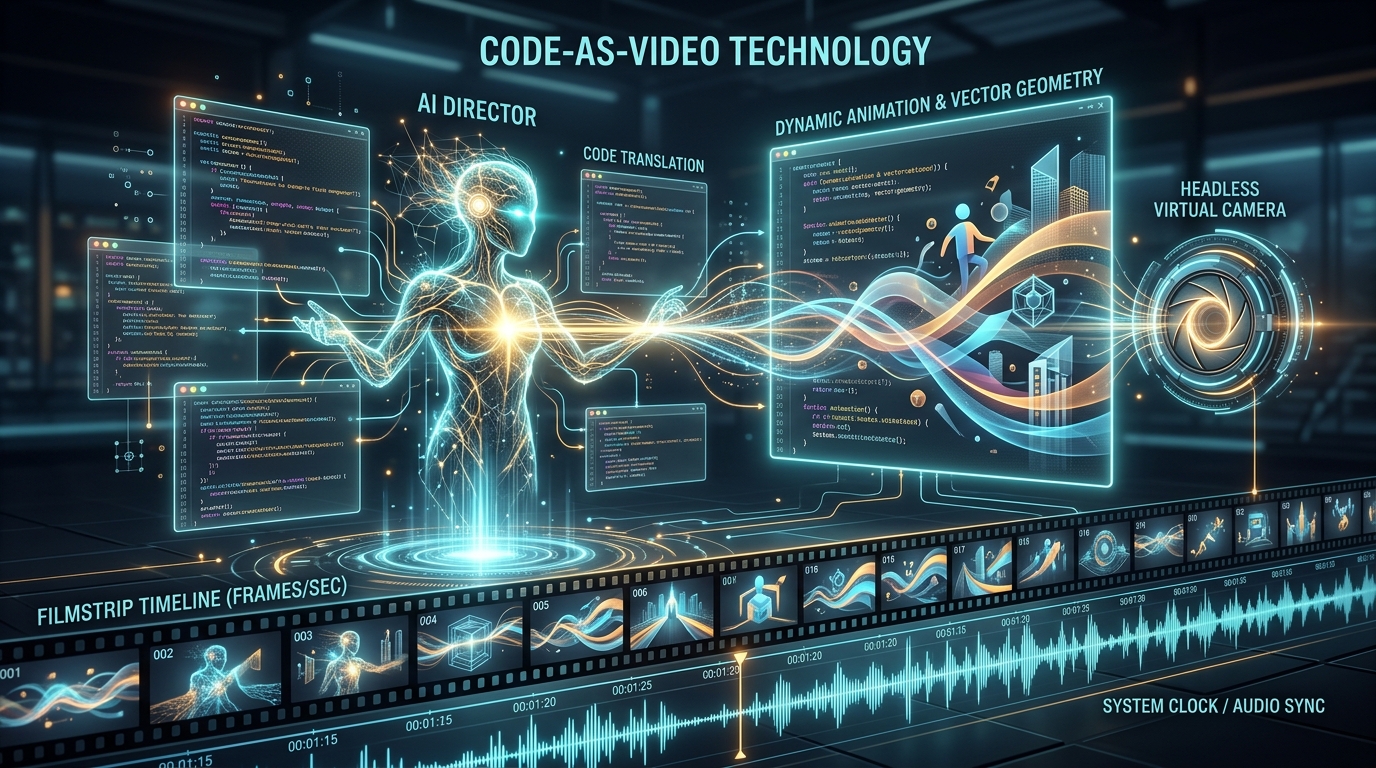
Anthropic 发布 Claude Opus 5.5 之后,技术社区与社交媒体上迅速涌现出一批令人惊叹的“一句话全自动视频”:15 秒极具视觉张力的动效展示、带语音解说的手绘风科普短片、配有钢琴音轨的动态设计演示,甚至还有一支长达两分半钟、具有复杂镜头转场与叙事节奏的独立音乐 MV。许多不明就里的围观者误以为 Anthropic 悄悄跟进了类似可灵或 Seedance 的扩散生成大模型;也有人猜测大模型只是敲了几行神秘代码,视频就自己从控制台蹦了出来。
然而事实的底层逻辑截然相反:Anthropic 发布的 Opus 5.5 根本没有原生视频输出能力,它既无法理解动态视频流,也不能生成哪怕一个真实的像素点,其本质输出依然只有纯文本与代码。这批刷屏动画与短片的底层范式,是一场极其精妙的 “代码即视频”(Code-as-Video) 工业级工程实践——Opus 5.5 在其中身兼“总导演”与“全栈工程师”,通过编写定义每一帧状态的时间函数,驱动后台无头浏览器(Headless Chrome)逐帧定格抓拍数千张高保真截图,最终由音视频管道 FFmpeg 完成拼接与多轨混音。本文将全景拆解这套颠覆传统 AI 视频认知的全新工程管线。
一、范式逆转:从“像素扩散抽卡”到“代码确定性渲染”
在探讨具体技术实现前,我们有必要先厘清当今 AI 视频生成领域正在发生的分野。
以字节跳动的 Seedance、快手可灵(Kling)、Runway Gen-3 以及 Sora 为代表的传统 AI 视频大模型,走的是纯正的 “像素级扩散模型(Diffusion / Flow-Matching)” 路线。这类模型通过在潜空间(Latent Space)中直接预测时空特征并重建三维张量像素点。
而 Claude Opus 5.5 引爆的这一波浪潮,则是完全平行的另一条技术支线:“程序化视频生成(Programmatic Video Synthesis)”。
flowchart TD
    subgraph DiffusionRoute["传统视频大模型路线 (Diffusion Models)"]
        D1["提示词 / 图像输入"] --> D2["视频生成大模型 (可灵 / Seedance / Runway)"]
        D2 --> D3["时空潜空间去噪 (Denoising in Latent Space)"]
        D3 --> D4["直接输出压缩像素流 (MP4)"]
        D4 --> D5["痛点:文字扭曲乱码、细节无法局部修改、画面如抽卡盲盒"]
    end

    subgraph CodeRoute["Claude Opus 5.5 路线 (Code-as-Video)"]
        C1["单条自然语言诉求 / 知识素材"] --> C2["Opus 5.5 兼任导演与程序员"]
        C2 --> C3["编写确定性时序代码 (HTML + SVG + GSAP / Canvas)"]
        C3 --> C4["语音时钟对齐 (带时间戳 TTS)"]
        C4 --> C5["无头浏览器逐帧定格抓拍 (Puppeteer Headless Chrome)"]
        C5 --> C6["FFmpeg 汇编图层与音频压制"]
        C6 --> C7["优势:矢量文字 100% 绝对清晰、改动只需改一行代码、确定性 1:1 复现"]
    end

    style DiffusionRoute fill:#fff3e0,stroke:#e65100,stroke-width:1px
    style CodeRoute fill:#e8f5e9,stroke:#2e7d32,stroke-width:2px
在这套管线中,视频不再是不可解释的黑盒张量,而被还原为最纯粹的数字本质:一串在时间轴上连续播放的离散画面(如每秒 30 帧)。视频生成的本质任务被抽象为一个极为严谨的数学命题:
只要大模型能够写出一个数学函数 f,对于任意给定的时间戳 t(例如第 2.5 秒),该函数都能百分之百确定地在屏幕上画出该毫秒所对应的所有矢量图形、文字排版与色彩位置,那么整部视频的骨架就已确立。
二、端到端五步系统流水线架构
著名 AI 架构师 宝玉(@dotey) 在深度复盘自身制作教学动画的实操流程中,将整套“写程序、逐帧拍照、汇编成片”的闭环抽象为标准五步法:规划、画面、动作、声音、拍摄与合成。
flowchart LR
    subgraph Step1["1. 规划 (Planning)"]
        A1["自然语言需求 / 原始资料"] --> A2["Opus 5.5 生成脚本与 STORYBOARD.md"]
        A2 --> A3["派发多个 Subagents 分镜头编写"]
    end

    subgraph Step2["2. 画面 (Visuals)"]
        B1["HTML / CSS 结构流"]
        B2["SVG 数学矢量图形"]
        B3["Three.js / p5.js / Canvas 渲染器"]
    end

    subgraph Step3["3. 动作 (Motion)"]
        C1["确定性时间轴编排"]
        C2["GSAP 时间轴精准锚定"]
        C3["Remotion 纯函数声明式帧计算"]
    end

    subgraph Step4["4. 声音 (Audio Clock)"]
        D1["TTS 旁白生成 (ElevenLabs / Gemini Flash)"]
        D2["提取字符级时间戳 (Timestamps)"]
        D3["生成 / 混入背景音乐 (Suno) 与 SFX 音效"]
    end

    subgraph Step5["5. 拍摄与合成 (Capture & Synthesis)"]
        E1["无头浏览器逐帧步进抓拍 (Puppeteer + Linux Chrome)"]
        E2["输出数千张高清 PNG 截图序列"]
        E3["FFmpeg 组装视频轨 + 复合音轨压制 MP4"]
    end

    Step1 --> Step2
    Step2 --> Step3
    Step4 -.->|"音频时间戳充当全片主时钟"| Step3
    Step3 --> Step5
    Step4 -->|"最终音频流送入"| Step5
带底色的核心模块(分镜编排、矢量渲染代码、时序动画逻辑)全部由 Claude Opus 5.5 独立手搓输出;而外部工具链(无头浏览器、TTS 引擎、FFmpeg)则充当高效的数字执行器。
三、第一步:导演规划与 Subagent 多智能体拆解
面对“帮我做一个视频”这种模糊宏大的长周期任务,普通模型往往会陷入“写几屏前端代码就发生逻辑漂移”的窘境。而 Opus 5.5 的核心杀手锏,在于其极其强悍的长时间跨度规划(Long-Horizon Planning)与多文件协同能力。
在官方测试中,Opus 5.5 已经展现出连续 18 小时无人值守完成大型工程构建的惊人稳定性。
1. 经典范例:两分半钟 MV《PDoomVideo》的规范沉淀
社区开源的一支长达 156.6 秒的完整音乐 MV《I'm Upping My P(doom)》(GitHub 开源项目 PDoomVideo)充分印证了这种能力。创作者在最初只投喂了歌词、歌曲音频以及一个角色原画构想,未提供任何中间场景插图。
Opus 5.5 在第一轮规划后,首先在工程根目录自主创建了一份长达数百行规范的 STORYBOARD.md(分镜设计规范手册):
# PDoomVideo STORYBOARD SPECIFICATION
1. 视觉连续性:角色形象具备严格的几何比例与锚点约束,全片 156 秒内保持统一。
2. 色彩叙事曲线:色调从开篇的暖奶油色(Warm Cream)逐步过渡到中段的深空紫(Space Purple),在危机高潮时跃迁至警报红(Alert Red),尾声再归于平复。
3. 动态守则:严禁静止画面,每一个镜头内必须至少存在一个持续运动的动力学元素。
4. 转场动机:场景切换必须由角色自身的动作引导触发(如大口啃咬触发黑屏切镜、高空坠落穿越地平线、镜头极速穿透角色的瞳孔)。
5. 表情过渡:角色微表情严禁离散跳变,必须通过贝塞尔插值实现连续渐变。
2. 借助 Subagent 划分时间轴管线
单份 JavaScript 文件的行数过长,会引发上下文灾难与逻辑死锁。Opus 5.5 会化身主架构师,在内部启动多个子智能体(Subagents):
- Subagent A 负责
scene-01-intro.js(0.0s ~ 28.5s); - Subagent B 负责
scene-02-development.js(28.5s ~ 74.0s); - 最终由主智能体调度一个集成的调度器,将各分镜文件无缝挂载到全局时间轴。
四、第二步与第三步:用前端代码构建画面,以数学时间锚定动作
1. 为什么代码比图片更适合做动效?
在传统视频生产中,每个镜头都需要美工绘制一张底图。但对于大模型而言,代码是其最高效、最精准的输出载体:
- SVG 与 HTML/CSS 的信息致密度:矢量图由坐标点、贝塞尔曲线公式与颜色代码直接定义。即使放大到 4K,线条边缘依然如同刀刻般锐利;
- 自包含(Self-contained):无需依赖外部图片服务器或承担未决的 CDN 网络开销,单份 HTML 即可完整打包整个宇宙。
例如,绘制一个动态角色与场景的核心结构,仅需几行声明式的矢量代码:
<svg width="1920" height="1080" viewBox="0 0 1920 1080">
  <defs>
    <linearGradient id="bg-grad" x1="0%" y1="0%" x2="100%" y2="100%">
      <stop offset="0%" stop-color="#0f172a" />
      <stop offset="100%" stop-color="#1e1b4b" />
    </linearGradient>
  </defs>
  <!-- 背景天幕 -->
  <rect width="100%" height="100%" fill="url(#bg-grad)" />
  <!-- 核心粒子与角色骨架 -->
  <g id="character" transform="translate(960, 540)">
    <circle cx="0" cy="-60" r="45" fill="#38bdf8" />
    <path d="M -40 0 L 40 0 L 25 120 L -25 120 Z" fill="#e2e8f0" />
    <circle id="heartbeat-core" cx="0" cy="30" r="16" fill="#f43f5e" />
  </g>
</svg>
除了纯 HTML/SVG,根据画风的不同,大模型还会自由切换底层图形库:
- 艺术水彩与手绘风:采用
p5.js结合噪点生成算法(Perlin Noise)模拟水彩在纸张上的晕染扩散效果; - 三维空间与镜头旋转:单文件引入
Three.js,构建具有动态光影与材质的三维几何体; - 严谨科学与数学解说:直接输出
Manim(3Blue1Brown 开源的数学动画库)的 Python 脚本,由本地 Python 运行时直接渲染。
2. 动作编排:GSAP 与 Remotion 的确定性时间轴
画面画好之后,必须赋予其运动的规律。在这一步,代码必须遵循严格的时间确定性:
方案 A:GSAP(GreenSock Animation Platform)
GSAP 允许在绝对时间轴上精准挂载缓动动作。开源工具 HyperFrames(HeyGen 团队开源)就深度重度依赖 GSAP:
import { gsap } from 'gsap';

const masterTimeline = gsap.timeline({ paused: true });

// 在第 1.5 秒时刻,核心开始高频脉冲放大
masterTimeline.fromTo('#heartbeat-core',
  { scale: 0.8, opacity: 0.5 },
  { scale: 1.4, opacity: 1, duration: 0.4, ease: 'back.out(2)' },
  1.5
);

// 在第 3.2 秒时刻,镜头横摇并移动角色
masterTimeline.to('#character',
  { x: 300, rotation: 12, duration: 1.2, ease: 'power2.inOut' },
  3.2
);
GSAP 的时间轴拥有一个致命特性:masterTimeline.seek(timestamp)。它允许渲染器在任意毫秒精确“定格”在指定的虚拟时刻,无需真实播放流逝时间。
方案 B:Remotion(React 声明式视频框架)
Remotion 则更加推崇函数式理念——每一帧的视觉状态都是一个以当前帧号(frame)为入参的纯函数:
import { interpolate, useCurrentFrame } from 'remotion';

export const AnimatedScene = () => {
  const frame = useCurrentFrame();

  // 随帧号确定性计算横向位移与透明度
  const opacity = interpolate(frame, [0, 30], [0, 1], { extrapolateRight: 'clamp' });
  const xOffset = interpolate(frame, [30, 90], [0, 400], { extrapolateRight: 'clamp' });

  return (
    <div style={{ opacity, transform: `translateX(${xOffset}px)` }}>
      <h1>代码即视频的架构跃迁</h1>
    </div>
  );
};
无论运行在一秒渲染 10 帧的破旧笔记本,还是配备 A100 的服务器集群上,只要帧号固定,输出的每一张画面结构完全等价。
五、第四步:声音是全片的主时钟
在传统的视频剪辑中,许多初学者习惯于先剪好画面,再去配音配乐。但在自动化代码视频流水线中,这种做法是绝对的灾难。
最优雅的工业实践是:先出配音,将配音提取为“绝对时钟”,再驱使画面去卡点音频。
flowchart TD
    Script["旁白文案稿件 (Opus 5.5 撰写)"] --> TTS["调用语音合成服务 (ElevenLabs / Gemini Flash TTS)"]
    TTS --> Audio["完整音频文件 (.mp3 / .wav)"]
    TTS --> Timestamps["高精度毫秒级时间戳 JSON 数据"]

    Timestamps -->|字词定位| Parser["时间戳解析器"]
    Parser --> T1["[00:01.240] 'Anthropic 发布了' -> 触发 LOGO 显隐"]
    Parser --> T2["[00:03.580] 'Opus 5.5' -> 触发版本徽标弹跳动画"]
    Parser --> T3["[00:06.120] '代码即视频' -> 触发代码雨背景瀑布流"]

    T1 & T2 & T3 --> GSAP["注入 GSAP / Remotion 时间轴动态参数"]
1. 带时间戳的 TTS 服务(ElevenLabs API)
以 ElevenLabs 为代表的高阶 TTS 接口,在返回音频流的同时,会附带一个精确到每个字符(Character-level)的开始与结束时间元数据数组:
{
  "characters": ["C", "l", "a", "u", "d", "e"],
  "character_start_times_seconds": [1.12, 1.18, 1.25, 1.31, 1.38, 1.44],
  "character_end_times_seconds": [1.18, 1.25, 1.31, 1.38, 1.44, 1.50]
}
通过这一层强关联,大模型在编写动画时间轴时,不再需要凭空瞎猜动作应当落在第几秒,而是直接绑定:当配音读到关键词“Claude”的第 1.12 秒,屏幕正中央的文字粒子恰好聚拢完成。
2. 音乐与音效的程序化配准
对于背景音乐(BGM)和交互音效(SFX):
- AI 音乐模型(Suno):Opus 5.5 可根据全片节奏风格拟定精细的提示词,生成固定拍速(例如 120 BPM 或 150 BPM)的音频底噪,并以固定节拍网格(Grid)安排转场切镜;
- 声音避让(Audio Ducking):在有旁白出现的时段,大模型会在 FFmpeg 汇编指令中写入自动化滤波参数,使背景音乐在人声响起时平滑降低 12dB,人声结束再逐渐恢复。
六、第五步:无头抓拍与确定性装配的工程深水区
写好了网页动画,如何将其转换为真正流通的 MP4 格式?为什么不直接开启屏幕录制软件录制浏览器播放界面?
1. 为什么“屏幕录屏”是业余做法?
HeyGen 团队在开发 HyperFrames 的底层渲染器时,曾详细披露过浏览器运行时的不可控性:
- 异步资源时序竞争(Race Conditions):在现代浏览器中,Web 字体的加载、CSS 渐变的抗锯齿绘制、高分辨率纹理的解码全是多线程异步进行的。直接以 1.0 倍速录屏,极易截到“字体还没渲染出来导致文字闪现”、“SVG 渐变还是空白底色”的穿帮帧;
- 硬件时钟漂移与掉帧(Frame Drops):一旦宿主机 CPU 瞬时负载突高,浏览器就会丢弃动画帧(Drop Frames),导致同一段代码在两台机器上录出来的总帧数和时长完全不同。
2. 确定性渲染的“三大铁律”
为了让每一帧的产出做到绝对可复现(Reproducible),代码必须遵守三条钢铁戒律:
| 禁令规则 | 违反后果 | 正确工程解法 |
|---|---|---|
| 严禁读取动态系统时钟 | 使用 new Date() 或 performance.now() 会导致不同机器渲染出不同画面 |
严格以全局虚拟帧号或虚拟时钟入参为唯一时间源 |
| 严禁使用未固定种子的随机数 | 直接使用 Math.random() 会导致两次渲染的粒子位置彻底变形 |
必须引入带固定 Seed 的伪随机数生成器(如 PRNG / Mersenne Twister) |
| 渲染期绝对禁止联网拉取资源 | 任何外部 CDN 请求在无头渲染时都会产生不确定的网络时延 | 所有字体、图片素材必须预先本地化,素材视频必须预切为序列帧图片 |
3. 特制 Chrome 逐帧定格抓拍
HeyGen 最终在 Linux 环境上运行了一个定制版的 Chromium,通过 CDP(Chrome DevTools Protocol)接管整个浏览器的渲染循环:
sequenceDiagram
    participant RenderEngine as 渲染调度器 (Node.js)
    participant Chrome as 无头浏览器 (Headless Chrome)
    participant Disk as 暂存磁盘 / 管道
    participant FFmpeg as FFmpeg 编码器

    RenderEngine->>Chrome: 加载本地打包好的 index.html
    RenderEngine->>Chrome: 等待所有 Local 资源与 WebFont 预加载就绪

    loop 遍历每一帧 (从 Frame 0 到 Frame 3760)
        RenderEngine->>Chrome: 执行 masterTimeline.seek(t = frame * 1/30)
        RenderEngine->>Chrome: 强制触发 DOM 重排、图层绘制与光栅化
        RenderEngine->>Chrome: 调用 Page.captureScreenshot()
        Chrome-->>Disk: 落盘为 frame_00000.png
    end

    RenderEngine->>FFmpeg: 读取 PNG 图像序列 + 混合多轨音频 (旁白/BGM/音效)
    FFmpeg-->>Disk: 输出最终高质量 1080p/4K MP4 视频
一段 150 秒、每秒 30 帧的视频,会被精准定格抓拍为整整 4500 张无损高清 PNG 图片。即便一台低配服务器要花费数十分钟才能拍完这 4500 张照片,最终拼合出的视频依然流畅丝滑、毫无丢帧卡顿。
更妙的是,因为帧与帧之间完全解耦,这 4500 帧可以轻而易举地分发给 10 个甚至 50 个并发无头浏览器实例分布式并行渲染,最后直接由 FFmpeg 顺序拼接,渲染效率呈线性爆发。
七、两大开源流派深度复盘:HyperFrames 与 Remotion
在当前将大模型与代码视频对接的开源方案中,存在两条截然不同的流派:
| 评测维度 | HyperFrames(HeyGen 开源) | Remotion(老牌 React 视频框架) |
|---|---|---|
| 底层开发范式 | 纯原生 HTML + CSS + GSAP + 原生 JS | React 组件 + TypeScript + Webpack/Vite |
| 大模型适应度 | 极高。大模型对原生 HTML/CSS/JS 的训练语料最多,代码极其自由 | 中等。大模型经常受困于复杂的 React 声明周期与 Hook 规则约束 |
| 渲染执行引擎 | Node.js + Puppeteer + Linux 定制 Chrome + FFmpeg | Node.js + @remotion/renderer (Chrome + WebGL + FFmpeg) |
| 生态成熟度 | 专为 AI Agent 打造,轻量灵活,无冗余框架开销 | 生态完备,有极其庞大的企业级模板库与丰富的播放器组件 |
| 安装与 Agent 接入 | 一行命令注入技能:npx skills add heygen-com/hyperframes |
运行 npx remotion skills add 引入官方技能集 |
HeyGen 团队的关键认知反转
HeyGen 在研发 HyperFrames 时分享过一段极具代表性的踩坑心路:
他们在项目立项初期,毫不犹豫地选择了业内最成熟的 Remotion(基于 React)。然而随着深入测试,团队惊讶地发现:施加给大模型的框架规则和语法抽象越多(例如复杂的 React Props、状态闭包、Remotion 定制 Hook),大模型写出的视频结构反而越保守、越呆板、千篇一律。
当他们痛定思痛、把整套底层推倒,全面退回到最原始、最质朴的纯 HTML、CSS 与原生 JavaScript 之后,大模型的创造力瞬间被彻底激活!Opus 5.5 能够随心所欲地利用原生 CSS Grid、灵动多变的 SVG 路径变形、以及 GSAP 任意拖拽的时间轴,写出惊艳全场的转场与视觉效果。
八、全维度对比:代码视频 vs. 像素扩散视频
为了让技术选型更加清晰,我们将 Claude Opus 5.5 代表的“代码即视频”与以可灵、Seedance、Sora 为代表的“像素扩散模型”进行全方位对照:
| 评估维度 | 代码即视频路线(Opus 5.5 + HyperFrames) | 像素扩散模型路线(Seedance / 可灵 / Sora) |
|---|---|---|
| 画面呈现机制 | 程序算出每一帧:数学矢量与 WebGL 渲染 | 模型直出像素点:潜空间反卷积去噪还原 |
| 文字与排版 | 100% 绝对精准:原生字体渲染,绝无错字与乱码 | 弱:极易产生字符扭曲、拼写幻觉与形变 |
| 局部细节修改 | 秒级手术刀定位:修改代码里的 1 个颜色或坐标即可 | 重新抽卡:无法单独改动局部,往往需要全镜重算 |
| 音视频毫秒同步 | 绝对精准:以毫秒级 TTS 时间戳为基准硬绑定 | 困难:音画容易各说各话,难以做到字字卡点 |
| 复杂运动确定性 | 1:1 确定可复现:相同代码与 Seed 永远输出同一视频 | 随机漂移:每次点击生成都是一次不可控的概率事件 |
| 写实画面与生物 | 劣势显著:近看多为几何色块、抽象扁平或粗糙 3D | 绝对霸主:真实人脸肌理、动物皮毛、自然流体极为逼真 |
| 最适宜的应用场景 | 科技产品动效、数据可视化、教学解说、动效演示、独立 MV | 真人影视大片、大自然实景、影视概念短片、氛围空镜头 |
终极演进范式:混合编排(Orchestration)
这两条路线绝非非此即彼的对立关系,社区最前沿的玩法正在将两者融为一体:
flowchart TD
    Orchestrator["Claude Opus 5.5 充当超级编排大脑 (Orchestrator)"] --> Plan["生成全局分镜时间轴 (Master Timeline)"]

    Plan --> BranchA["排版与动效:直接写原生 HTML / SVG / GSAP 代码"]
    Plan --> BranchB["真实人像镜头:通过 MCP 协议调用外部视频生成 API (如可灵/Runway)"]
    Plan --> BranchC["局部贴图材质:调用 Flux / Midjourney 生成逼真静态壁纸"]

    BranchB --> Split["FFmpeg 将生成的视频切成 PNG 序列帧"]
    BranchA & BranchC & Split --> Composite["无头浏览器统一载入并合成于一个 Canvas 视口"]
    Composite --> Final["输出兼具高保写真实感与 100% 精确文字卡点的混合大片"]
大模型充当总调度室(Master Brain),文字图表靠代码画,真人实景通过 MCP(Model Context Protocol)调用外部视频生成接口,生成后切片嵌入到网页特定的 div 或 3D 材质球上,最终统一由无头浏览器输出。
九、局限性剖析、Token 成本与审美把关
尽管“代码即视频”展现出了划时代的工程美感,但在当下的实际落地中,依然横亘着几座无法忽视的高山:
1. 真实生物与写实视效的物理天花板
无论大模型的 CSS 和 Canvas 技能多么精湛,它永远不可能靠几行贝塞尔曲线代码还原出人脸微小的肌肉抽搐、一缕飘逸的发丝,或是微风拂过水面泛起的逼真涟漪。强行让代码去画动物或真人,近看只会呈现出怪异的几何拼凑感。
2. 惊人的 Token 消耗与长上下文账单
让大模型凭空编写长达数千行的前端动画、分镜脚本与数学坐标,是一件极度消耗计算资源的操作:
- 社区创作者反馈,制作一支仅 3 分钟 带有丰富细节与转场的短片,直接耗尽了一个高级订阅账户每周可用 Claude 额度的约 7%;
- 若直接调用官方 API,Opus 5.5 的定价为每百万输入 Token 4 美元、每百万输出 Token 20 美元。复杂的 3D 场景与数学脚本常常在单次生成时直接撞破输出 Token 上限,必须极其严密地控制 Subagent 的任务切分粒度。
3. 审美天花板:人类导演依然不可或缺
正如全球著名前端技术导师 Wes Bos 所针砭的那样:
“这些视频里的很多动效,从专业动效设计师的角度看其实并不能算精巧绝伦。这项技术最震撼的地方在于:大模型居然真的能够把它完整做出来。但在镜头语言、留白节奏、配色品味上,大模型依然需要人类充当严厉的‘艺术总监’。给它一套成熟的调色板(Palette)与现成组件规范,成片质量才会跃升一个档次。”
十、结语:软件工程吞噬多媒体创作的又一座里程碑
Claude Opus 5.5 掀起的视频风暴,本质上并不是多媒体技术的胜利,而是计算机软件工程对传统创意产业的又一次降维渗透。
当一家大模型在逻辑推理、代码手搓和长跨度项目组织上的能力超越临界点时,它不需要专门去训练一个庞大的视频生成网络,它只需调动人类在过去三十年间积累的成熟 Web 标准——HTML、CSS、SVG、Canvas、WebGL、Chrome 与 FFmpeg,就能用纯粹的代码在时间轴上拼装出一个鲜活跳跃的世界。
代码是人类构建逻辑最严谨的符号,而如今,它也成为了 AI 绘制动态光影最锋利的画笔。
原文链接与参考资料
- 原推文出处:宝玉(@dotey)在 X 上的深度长文复盘 / X 平台专栏文章
- Anthropic 官方发布公告:Introducing Claude Opus 5.5
- HeyGen 渲染架构技术内幕:HTML to Video Was Not Easy: Here's How We Solved It (HyperFrames Research)
- OrcaRouter 社区深度拆解:Claude Opus 5.5 One-Shot a Music Video: What "Plan a Video" Actually Produces
- ElevenLabs 官方高精度时间戳文档:Create speech with timestamps API Reference
- daily.dev 社区案例集锦:Claude Opus 5.5 generates motion design and visual scenes entirely in code