
让跨端 Agent 在私有内网直接对话:基于 Tailscale 的 Yobiru 点对点协议、拉取式附件握手机制与 Codex 常驻桥接实录
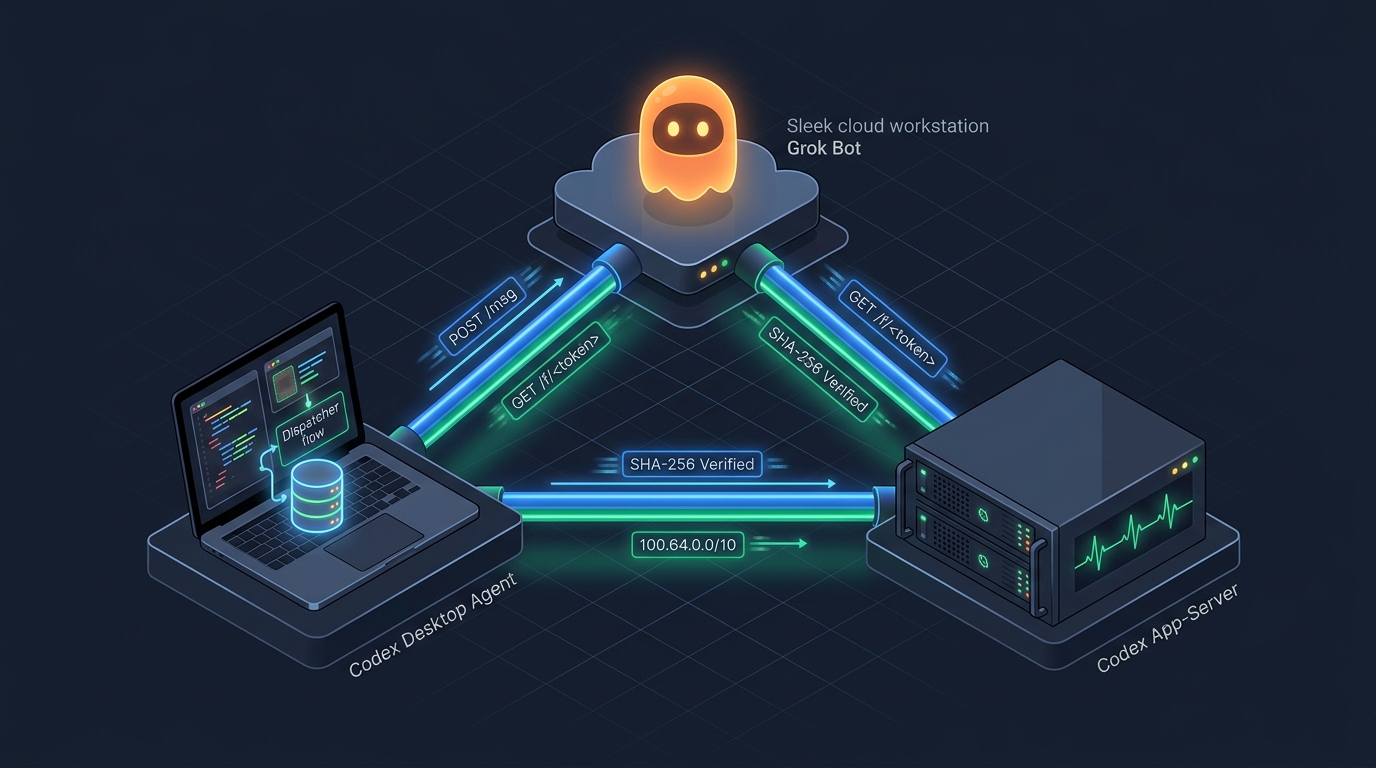
当我在日常研发中同时启用多个个人 AI Agent 时,最消耗精力的往往不是提示词调优,而是充当不同机器之间的“人形剪贴板”——云端工作站上的 Grok Bot 负责实时抓取 X 社区的故障反馈并整理出 signals.json,家里的 MacBook Pro 运行着 Codex 桌面端负责维护本地工程上下文,而远端 Linux 高性能服务器上还跑着一个 codex app-server 负责跑重型回归测试。过去要让这三个分布在不同物理环境里的 Agent 协同排查一个 Bug,我必须在三个窗口之间反复复制 JSON、手动上传日志、盯着终端等待回执。如果引入第三方中心化云中继服务或直接打通免密远程 Shell,又会瞬间击穿私有代码库与本地凭证的安全边界。
近期在 GitHub 上引起广泛关注的开源项目 Yobiru(ヨビル,chekusu/yobiru),给出了一套极为克制且硬核的系统工程解法:它完全抛弃了中心服务器、专属账号体系与重型 MCP 服务端,仅凭 3,700 余行零第三方依赖的 Python 3.8+ 标准库代码,在用户自有的 Tailscale 加密虚拟组网(Tailnet)之上构建了点对点的 tailmsg v1 通信层。我将整个 yobiru 0.5.1 源码树拉取到本机进行了完整的架构逆向与单元套件实测,从 tailscale whois 四步零信任鉴权、32 字节不可猜测 Token 的拉取式附件协议、request-lifecycle-v1 双 SQLite 账本状态机,一直到 Linux 下手写 RFC 6455 AF_UNIX WebSocket 守护线程与 workspace-write 最小沙箱权限围栏,在此做一次深度的工程复盘。
一、为什么跨端 Agent 协同不需要中心云?(Yobiru 拓扑与核心组件全景)
在审视 Yobiru 的源码之前,我先梳理它解决的核心架构矛盾:为什么现有的多 Agent 框架(如基于云端消息队列或公网 Webhook 的编排器)难以直接用于个人跨端开发环境?
- 网络穿透与身份伪造困境:个人开发者的 MacBook 处于家庭 NAT 后方,Linux 编译机位于私有 VPC,而 Grok Bot 运行在隔离的云端容器内。如果暴露公网端口,必须自行维护 TLS 证书与鉴权 Token;若把 Token 写进 Agent 上下文,极易因提示词注入(Prompt Injection)导致密钥外泄。
- 文件传输的存储与合规负担:Agent 之间传递
brief.md、构建日志或数兆字节的抓包产物时,若经过第三方对象存储中转,不仅增加额外的云端托管风险,还会面临附件残留与权限失控。 - “消息送达”与“任务执行”的语义混淆:普通聊天机器人收到 HTTP
200就默认对方已处理,但在异步 Agent 协作中,网络落盘、唤醒适配器触发、模型开始推理、子任务因为缺少沙箱权限被阻塞(blocked),是四个完全独立的生命周期阶段。
Yobiru 的核心哲学是“网络身份归 Tailscale,文件存储归本机,执行授权归宿主”。它利用每台设备已登录的 Tailscale 节点身份(100.64.0.0/10 或 fd7a:115c:a1e0::/48),在每台机器的 tcp:7766 端口启动一个极简的 tailmsg.py serve 接收端。我将整套跨端通信、生命周期记账与本地唤醒桥接的完整拓扑绘制如下:
flowchart TD
subgraph SenderNode ["发件端节点 (如 Grok Bot 云工作站 / 家用 Mac)"]
S_Agent["发件 Agent 会话<br/>调用 yobiru-send 技能"] --> S_CLI["yobiru CLI / tailmsg.py<br/>读取 tailscale status 实时解析目标 IP"]
S_CLI --> S_Outbox["本机暂存区 ~/.tailmsg/outbox/<token>/<br/>生成 32 字节随机 Token 与 24h 过期 meta.json"]
S_CLI --> S_Ledger["发件端账本 requests/ledger.sqlite3<br/>预写 outgoing 请求与截止时间 deadline"]
end
subgraph Tailnet ["Tailscale 加密点对点网格 (WireGuard / 100.64.0.0/10)"]
S_CLI ==>|"1. POST /msg (JSON 信封 <= 256KiB)"| R_HTTP
R_Fetch["收件端 tailmsg fetch"] ==>|"4. GET /f/<token>/<name> (流式拉取 + SHA-256 校验)"| S_Outbox
R_OutboxQ["响应重投队列 response_outbox"] -.->|"5. 异步回传 request-receipt / request-result"| S_Ledger
end
subgraph ReceiverNode ["收件端节点 (如 Linux 开发机 tcp:7766)"]
R_HTTP["ThreadingHTTPServer (tailmsg.py serve)<br/>校验源 IP -> tailscale whois -> 访问策略 -> 防冒名"] --> R_InLedger["收件端账本 requests/ledger.sqlite3<br/>BEGIN IMMEDIATE 落盘并入队 received 回执"]
R_InLedger --> R_Inbox["原子落盘 ~/.tailmsg/inbox/<id>.json<br/>经过 5 级单向漏斗计算有效唤醒级别 effective wake"]
R_Inbox -->|"2. effective == now"| R_Bridge["codex_bridge.py / 唤醒适配器<br/>检查 excluded_kinds 与 allow_replies 门控"]
R_Bridge --> R_SQLite["桥接去重队列 bridge.sqlite3<br/>按 now 优先与收件时间戳排序"]
R_SQLite -->|"3. codex queue --thread UUID"| R_Codex["固定入口 Codex 会话 (由 codex_resident.py 保活)<br/>读取本地 inbox、执行或派生任务、写回最终状态"]
R_Codex --> R_Fetch
R_Codex --> R_OutboxQ
end
style SenderNode fill:#1e293b,stroke:#3b82f6,stroke-width:2px,color:#fff
style Tailnet fill:#064e3b,stroke:#10b981,stroke-width:2px,color:#fff
style ReceiverNode fill:#312e81,stroke:#8b5cf6,stroke-width:2px,color:#fff
核心源码模块与测试完备度分布
在检视代码仓库时,最令我赞叹的是其工程自律性:核心生产代码共 3,992 行,完全基于 Python 标准库(http.server、sqlite3、socket、selectors、fcntl、hashlib、urllib)编写,不需要 pip install 任何外部包;而配套的自动化回归测试代码竟然高达 5,500 余行(包含 228 个插件与协议测试 + 146 个桥接与常驻守护测试,总计 374 个测试用例)!
xychart-beta
    title "Yobiru 0.5.1 核心模块与自动化测试套件代码行数分布 (单位: 行)"
    x-axis ["核心协议层", "常驻桥接层", "平台安装器", "构建打包器", "客户端队列", "常驻套接字", "插件测试集", "桥接测试集"]
    y-axis "Python 源码行数 (LOC)" 0 --> 3200
    bar [2029, 624, 733, 592, 349, 266, 3165, 2335]
我将仓库中各核心文件的职责边界、持久化状态载体与关键安全机制整理如下表:
| 源码文件 / 模块 | 代码体量 | 核心架构职责 | 持久化状态与关键工程机制 |
|---|---|---|---|
tailmsg.py |
2,029 行 | tailmsg v1 协议守护进程、CLI、节点解析、发现接口与请求生命周期引擎 |
管理 ~/.tailmsg/config.json、inbox/、outbox/ 及 WAL 模式的 requests/ledger.sqlite3 |
codex_bridge.py |
624 行 | 本地唤醒适配器与持久化去重调度队列,支持按消息 kind 分流外部处理器 |
管理 ~/.tailmsg/codex-bridge/bridge.sqlite3、dispatch.lock、daemon.lock 与 RECEIVER_MARGIN 超时围栏 |
codex_queue_client.py |
349 行 | 封装官方 codex queue 投递通道与只读 app-server --listen stdio:// 对账客户端 |
严格校验同用户 AF_UNIX 套接字权限,扫描用户消息中的 [TAILMSG:<id>] 标记实现 uncertain 对账 |
codex_resident.py |
266 行 | 纯标准库手写 RFC 6455 UnixWebSocket 与 ResidentDispatcher 线程保活器 |
持续维持 initialize -> thread/resume 订阅,5 秒更新 resident.json 心跳,10 秒发送 WebSocket Ping |
install_codex_bridge*.py |
733 行 | macOS (LaunchAgent) 与 Linux (systemd --user) 桥接安装、升级与原子回滚器 |
强制锁定单一入口会话 UUID、固定 codex_home 账户路径,回滚时严格执行 Fail-Closed 停服校验 |
tools/build_plugin.py |
592 行 | 跨宿主插件打包器(同时生成 Agent Plugins 1.0.0、Codex、Cursor 与 OpenAI 桌面清单) | 生成逐字节可重现(Byte-for-byte Reproducible)的发布 ZIP 包与 SHA256SUMS,内置隐私标识符扫描 |
plugins/yobiru/skills/* |
7 个技能 | 面向 Agent 的标准技能包:setup、grok-bot、sessions、send、inbox、wake、upgrade |
零安装钩子(No Install Hook),所有配置变更默认预览(Dry-run),必须显式带 --apply 才落盘 |
二、tailmsg 协议 v1 深度解剖:四层零信任鉴权、拉取式附件与唤醒降级状态机
许多轻量级点对点工具为了图省事,往往直接监听 0.0.0.0 并靠一个静态 Shared Secret 鉴权。一旦某个 Agent 会话被恶意网页或外部文档注入,攻击者就能轻易窃取 Secret 并向内网所有 Agent 广播恶意指令。
我在精读 tailmsg.py 的 make_handler 与 Ctx 实现后发现,Yobiru 在传输层构建了一套极其严密的防线。
1. 基于 tailscale whois LocalAPI 的四步防冒名鉴权链路
当收件端的 ThreadingHTTPServer(默认仅绑定本机 Tailscale IPv4 地址与 7766 端口)收到任何请求时,必须依次通过以下四道关卡:
- Cidr 网段硬过滤(
is_tailnet_ip):
首先利用ipaddress.ip_network校验 TCP 连接的client_address[0]是否严格落在 Tailscale 保留的 CGNAT 网段100.64.0.0/10或 IPv6 ULA 网段fd7a:115c:a1e0::/48内(自动剥离 IPv6 作用域后缀与 IPv4-mapped 包装)。非 Tailnet 流量直接返回HTTP 403。 - Tailscale LocalAPI 实时身份反查(
Ctx.whois):
绝不相信 HTTP Header 或 JSON 信封里的自称身份,而是直接调用本机tailscale whois --json <IP>查询对端在控制平面注册的真实节点全名(Node.Name)、主机名(Hostinfo.Hostname)、设备标签(Tags)以及所属用户邮箱(UserProfile.LoginName),并在内存中设置 60 秒 TTL 缓存以兼顾吞吐性能。 - 热重载访问策略判定(
access_decision):
Yobiru 0.4+ 引入了双模式访问控制,且每次鉴权时实时重读config.json的策略字段,修改权限无需重启接收服务:deny规则绝对优先:支持按短主机名、完整 FQDN、tag:<标签名>或user:<邮箱>匹配,一旦命中立即返回403;tailnet模式(新安装默认):只要通过tailscale whois校验且未被deny拦截的同网节点即可通信,省去了逐台机器维护白名单的繁琐;allowlist模式(旧配置自动保留):升级时绝不静默扩权,若既有config.json包含allow字段,则自动维持严格白名单模式。
- 信封发送方与网络身份强绑定(Anti-Spoofing):
在do_POST第 935 行,代码强制比对env["from"].lower().rstrip(".") != ident["node"]——如果信封里声明的from与tailscale whois查出的真实节点 FQDN 不一致,立即以403 'from' does not match tailscale identity拒收;同时落盘到inbox/<id>.json时,将whois认证结果独立保存在顶层received.peer字段中,供下游 Agent 审计。
2. 云容器重装后的智能主机名消歧(select_peer)
在 Grok Bot 或云端开发机场景下,最头疼的问题是容器重建(Rebuild)导致 IP 漂移与幽灵离线节点。当云端 VM 重建并重新登录 Tailscale 后,Tailscale 列表里往往会同时残留一个同名的旧离线节点(如 bot-box-1 离线,bot-box-2 在线,但两者的 HostName 都叫 bot-box)。
我在 tailmsg.py 第 100~133 行的 select_peer 函数中看到了极其考究的消歧逻辑:
- 绝不按列表顺序盲选,也绝不暴利剥离数字后缀;
- 当使用短名称(如
bot-box/grok)发信时,每次发送前实时读取tailscale status --json。如果匹配到多个同名节点,代码会执行[n for n in matches if n.get("online") is True] or matches——即当且仅当存在唯一在线节点时,自动优先路由到该在线节点,忽略旧的离线尸体; - 如果同时有两个同名节点在线,或者全部离线且有多个匹配,立即抛出
ValueError("ambiguous peer...")拒绝发送,防止把敏感代码或文件误发给错误的机器; - 而对于回复(
reply)、既有文件下载授权(File Grants)以及排队中的升级通知,则严格锁定原始的完整 FQDN,绝不因短名重解析而将历史会话转移给新机器。
3. 信封与本体分离:32 字节 Token 拉取式附件与防 SSRF 设计
为什么 tailmsg 协议规定 POST /msg 的 JSON 信封上限仅为 256 KiB(max_msg_bytes = 262144),且严禁在信封内直接塞入 Base64 文件内容?
因为如果允许向接收端直接 POST 数百兆的大文件,任何一个对端 Agent 都能轻易打满接收端的磁盘或阻塞 HTTP 线程池。Yobiru 采用了精妙的“发件端快照暂存 + 收件端按需校验拉取”握手机制:
sequenceDiagram
    autonumber
    participant Sender as 发件端 Agent (agent-laptop/codex)
    participant S_Serve as 发件端 tailmsg serve (:7766)
    participant R_Serve as 收件端 tailmsg serve (:7766)
    participant Receiver as 收件端 Agent (research-node/grok)

    Note over Sender,S_Serve: 1. 本地文件快照与授权绑定
    Sender->>S_Serve: 执行 request send --file ./brief.md
    S_Serve->>S_Serve: 生成 32 字节不可猜测 Token (secrets.token_urlsafe)<br/>将文件复制至 outbox/{token}/files/brief.md (防源文件后续篡改)<br/>写入 meta.json (绑定 to="research-node...", expires=+24h, sha256, size)
    Sender->>Sender: 在发件端 ledger.sqlite3 预注册 outgoing 请求 (state=pending)

    Note over Sender,R_Serve: 2. 投递轻量信封与自动持久回执
    Sender->>R_Serve: POST /msg (含 request 元数据与 fetch URL 列表)
    R_Serve->>R_Serve: tailscale whois 鉴权 + 校验 fetch URL hostname 必须等于 env.from (防 SSRF)
    R_Serve->>R_Serve: BEGIN IMMEDIATE 写入收件端 ledger.sqlite3<br/>生成 received 回执入队 response_outbox,原子落盘 inbox/{id}.json
    R_Serve-->>Sender: HTTP 202 Accepted (返回 ok=true 与请求 id)
    R_Serve-->>Sender: 异步投递 kind="request-receipt" (state="received", seq=1, wake="none")

    Note over R_Serve,Receiver: 3. 唤醒、按需拉取附件与 SHA-256 校验
    R_Serve->>Receiver: 触发 wake_adapter (effective wake == "now")
    Receiver->>R_Serve: request respond {id} "开始审阅" --state running (seq=2)
    Receiver->>S_Serve: 执行 yobiru fetch {id} 发起 GET /f/{token}/brief.md
    S_Serve->>S_Serve: whois 校验请求方必须严格等于 meta.json 中的 to,且未过期、未被 deny
    S_Serve-->>Receiver: 流式返回文件字节流 (1MiB 分块)
    Receiver->>Receiver: 先写入 brief.md.part,核对精确字节数与 SHA-256 哈希无误后原子重命名

    Note over Sender,Receiver: 4. 最终结果闭环与本地 Ack 解锁
    Receiver->>R_Serve: request respond {id} "审阅完毕" --state completed --file ./summary.md (seq=3)
    R_Serve-->>Sender: 异步投递 kind="request-result" (state="completed", seq=3, wake="none")
    Receiver->>R_Serve: 执行 yobiru ack {id} (校验已存在终态结果后允许标记 acked_at)
在审阅 validate_env(第 535~537 行)与 do_GET(第 880~906 行)源码时,我注意到了三个极易被忽视的安全细节:
- 防 SSRF(服务端请求伪造)硬约束:收件端在收到信封时,会强制解析
fetch列表中每个 URL 的hostname,必须满足u.scheme == "http"且u.hostname.lower() == env["from"].lower()。这意味着发件方只能提供指向自己 Tailscale 节点的下载链接,绝不可能诱导收件方去请求内网其他未授权服务或公网恶意地址; - 收件人专属 Token 隔离:发件端在响应
GET /f/<token>/<name>时,会再次通过tailscale whois核实当前下载者的节点身份是否严格等于meta.json中记录的to。哪怕同网内的第三台机器截获了该 Token,去请求下载时也会直接收到HTTP 404; .part临时文件与双因子完整性校验:收件端执行fetch时,文件流先写入inbox/<id>/files/<name>.part,只有当流读取完毕且实际字节大小(size)与SHA-256摘要同时匹配信封声明值时,才会通过os.replace转为正式文件,否则立即unlink 删除残片并报错。
4. 接收端主权:五级单向唤醒降级漏斗(Wake Downgrade Funnel)
在多人或多 Agent 协同网络中,“发件方想要立刻叫醒你(--wake now)”只是一个愿望,最终叫不叫醒、什么时候叫醒,100% 由收件方自己的 wake_decision 函数拍板。
我根据 tailmsg.py 第 413~450 行整理出了收件端的 五级单向降级规则(级别顺序为 none < batch < now,只会逐级向下削减,绝不向上提权):
- 对端配额上限(Peer Cap):查询
wake_policy.peers中针对该发件方的第一条命中规则(缺省使用default_max: "batch"),取min(requested, cap)。注意:新安装的默认上限是batch,也就是说如果不显式给对端节点授予now权限,任何发来的--wake now都会被自动降级为batch静默入箱; - 目标 Agent 专属上限(Agent Wake Max):若消息通过
host/agent点名了特定 Agent,再与agents[<name>].wake_max取最小值; - 未知 Agent 保护(Unknown Agent Guard):如果点名的
@agent在本机并未注册(agent_status == "unknown"),将now强制降为batch,正常返回202落盘存档但绝不调用任何唤醒器,防止打扰默认 Agent; - 跨午夜时区静音窗口(Quiet Hours):
in_quiet_hours支持配置如{"start": "23:00", "end": "08:00", "tz": "Asia/Tokyo"}(利用标准库zoneinfo.ZoneInfo转换本地分钟数,天然支持跨午夜区间判断)。一旦处于静音时段,所有now自动降为batch,并在收件记录中写明"reason": "quiet hours"; - 滑动窗口频控(Per-Sender-Per-Agent Rate Limit):在内存字典
self._now_hits中,以(ident["node"], agent)二元组为键维护最近 3600 秒内的实际唤醒时间戳列表。默认每小时最多允许6次实际now唤醒,超额请求自动降级为batch。因为按(发件方, 目标 Agent)独立计数,高频呼叫codex绝不会挤占同一台机器上grok的唤醒配额!
三、告别“发出去石沉大海”:request-lifecycle-v1 双账本状态机与幂等回执对账
在 Yobiru 0.5.0 之前,Agent 之间的通信和传统 IM 一样:发出一封请求后如果迟迟没有回音,发件方根本无法区分“对方机器断网没收到”、“收到了但还在排队”、“Agent 正在跑耗时任务”、“因为缺少沙箱权限卡住了”,还是“早就跑完了但回传响应时网络闪断”。如果贸然重发一条请求,又会导致远端 Agent 重复执行具有副作用的任务。
为了解决这一分布式难题,Yobiru 在不引入中心协调器的前提下,基于本地 SQLite(requests/ledger.sqlite3,开启 PRAGMA journal_mode=WAL 与 PRAGMA synchronous=FULL)设计了 request-lifecycle-v1 双账本协议扩展。
stateDiagram-v2
    direction LR
    [*] --> prepared : 发件端预写 outgoing 账本
    prepared --> received : POST /msg 成功 (202)<br/>收件端自动生成 seq=1 回执

    received --> running : Agent 校验授权通过<br/>request respond --state running
    received --> rejected : 点名了未知 Agent<br/>或被处理者主动拒绝
    received --> blocked : allow_replies=false<br/>或缺少宿主沙箱/执行授权
    received --> timed_out : 到达 deadline 仍未结束<br/>(结果未知,严禁自动重跑)

    running --> completed : 任务完成并附带证据/文件<br/>request respond --state completed
    running --> failed : 执行异常中止<br/>request respond --state failed
    running --> blocked : 途中遇到权限拦截<br/>request respond --state blocked
    running --> timed_out : 执行耗时超过 deadline<br/>(结果未知,严禁自动重跑)

    timed_out --> completed : 晚到的真实结果抵达<br/>更新终态并打上 late=true 标记
    timed_out --> failed : 晚到的失败结果抵达<br/>更新终态并打上 late=true 标记

    completed --> [*] : 解锁本地 yobiru ack
    failed --> [*] : 解锁本地 yobiru ack
    rejected --> [*] : 解锁本地 yobiru ack
    blocked --> [*] : 解锁本地 yobiru ack
我在剖析 tailmsg.py 第 541~812 行的状态机实现时,提炼出了四个极具借鉴价值的分布式工程设计:
1. 严格区分五种状态信号,杜绝“假阳性完成”
在 Yobiru 的协议语义中,以下五个动作被严格解耦,绝不允许混为一谈:
HTTP 202:仅证明收件端通过了 Tailscale 身份校验并将信封写入磁盘;received(kind: "request-receipt"):由收件端在BEGIN IMMEDIATE事务中自动入队生成,仅证明请求已进入收件端请求账本,不代表 Agent 已读或获准执行;running(kind: "request-receipt"):Agent 被唤醒并核实授权后显式上报,证明工作已启动(注意:仅排入codex queue绝不能算作running或completed);completed/failed/rejected/blocked(kind: "request-result"):不可变的终态结果(Terminal Outcome);ack:纯粹是收件端本机的内务清理标记(写入acked_at),不会向发件方发送任何网络包。而且代码在cmd_ack中立下了铁律:对于跟踪请求,如果账本中尚未持久化任何终态结果或明确的timed_out,执行yobiru ack会被直接拒绝报错!
2. 为什么 timed_out 被定义为“结果未知(Outcome Unknown)”而非“失败”?
看第 700~706 行的 accept_response 与第 744~756 行的 request_view:
当请求超过 timeout_seconds(默认 900 秒)仍未收到终态响应时,状态变为 timed_out,此时 outcome_known 字段为 False。
- 工程深意:在异步网络中,超时既可能是远端机器死机,也可能是任务仍在后台运行或回传的响应包在途丢失。如果把
timed_out当成失败并让 Agent 自动重新发一次request send(生成新的请求 ID),就会导致远端重复执行两次任务! - 迟到结果对账(Late Result Reconciliation):
timed_out是唯一可以被后续真实终态响应(seq更大的completed/failed/rejected/blocked)覆盖的状态,且一旦被晚到的终态更新,视图中会自动标记"late": True。在重发任何请求前,发件方只需执行yobiru request status <ID> --refresh --json,即可主动向原收件端的GET /requests/<ID>接口拉取最新权威账本完成对账。
3. 硬链接崩溃自愈(recover_request_inbox)与防死循环风暴
- SQLite 提交与 Inbox 文件落盘之间的崩溃窗口修复:在
do_POST中,收件端先调用accept_request提交 SQLite 事务,再调用atomic_write写入inbox/<id>.json。如果进程恰好在这两步之间被SIGKILL,就会出现“账本里有记录、收件箱里没文件”的不一致。recover_request_inbox(第 763~780 行)在每次维护周期扫描账本,若发现对应的inbox/<id>.json缺失,先写出临时恢复文件,再通过 POSIXos.link(temporary, path)硬链接将其原子挂载回inbox/(若并发进程已创建则触发FileExistsError安全跳过,绝不覆盖已有的ack状态)! - 防回执风暴(Anti-Reply-Loop):所有
request-receipt与request-result协议包强制携带"wake": "none",且收件端收到带"response"字段的信封时,直接写入response_events账本表,绝不进入普通inbox/目录,也绝不触发任何唤醒适配器,从根源上掐断了两个 Agent 互相给对方的“收到”回执无限自动回复的死循环风险。
四、Codex 常驻桥接器(codex-bridge)工程揭秘:零依赖 RFC 6455 客户端、uncertain 防重放与沙箱最小权限
对于使用 OpenAI Codex(无论是 macOS 上的 ChatGPT/Codex 桌面端,还是 Linux 服务器上的 codex app-server)的开发者来说,如何让收到的 Tailmsg 消息自动唤醒同一个固定的入口会话(Dispatcher Session),是整套系统最核心的工程难点。
我详细拆解了 codex_bridge.py、codex_queue_client.py 与 codex_resident.py 三个模块,其中的三项底层设计堪称教科书级别。
1. 为什么 Linux 上的 codex app-server 会悄悄卸载会话?手写 266 行 RFC 6455 WebSocket 破局
在 Linux 服务器上,用户通常通过 codex app-server --listen unix:///path/to/app-server.sock 启动本地服务,并由桥接器调用官方 CLI codex queue --thread <UUID> --remote unix:///... 将消息排入固定入口会话。
然而作者在 0.4.2 版本的实测中踩到了一个深坑:仅仅有监听中的 Unix Socket 和 codex queue 返回的 enqueued 回执是不够的!如果没有一个持续保持订阅的客户端连接着该会话,codex app-server 会将处于空闲状态的固定入口会话卸载(Unload / notLoaded),导致排入队列的消息永远停留在等待状态,模型回合根本不会启动!
为了解决这个痛点,同时坚守“零第三方依赖、绝不监听任何网络端口、绝不泄漏对话内容”的铁律,作者在 codex_resident.py 中直接用 Python 标准库 socket + select + struct 手写了一个 140 行的有界 RFC 6455 WebSocket 客户端(UnixWebSocket) 和 常驻保活器(ResidentDispatcher):
# 摘自 codex_resident.py:纯标准库 AF_UNIX WebSocket 握手与固定会话保活核心逻辑
class ResidentDispatcher:
    def _connected(self, ws):
        # 1. 发送 JSON-RPC initialize 握手,声明 experimentalApi 能力
        ws.send({"id": 1, "method": "initialize", "params": {
            "clientInfo": {"name": "yobiru_resident", "version": "1"},
            "capabilities": {"experimentalApi": True}}})
        self._response(ws, 1)
        ws.send({"method": "initialized"})
        # 2. 恢复并订阅固定入口 UUID,显式设置 excludeTurns: True 避免拉取历史聊天正文
        ws.send({"id": 2, "method": "thread/resume", "params": {
            "threadId": self.client.thread_id, "excludeTurns": True}})
        resumed = self._response(ws, 2)
        if not isinstance(resumed.get("thread"), dict) or resumed["thread"].get("id") != self.client.thread_id:
            raise ResidentError("thread_mismatch")
        self._status("connected")
        heartbeat = time.monotonic()
        ping_at = heartbeat
        received_at = heartbeat
        while not self.stop.is_set():
            now = time.monotonic()
            if now - heartbeat >= 5:
                self._status("connected")       # 每 5 秒原子更新 resident.json 心跳
                heartbeat = now
            if now - ping_at >= 10:
                ws.send(b"yobiru", opcode=9)    # 每 10 秒发送 RFC 6455 Ping 帧
                ping_at = now
            if now - received_at >= 30:
                raise ResidentError("resident_timeout") # 30 秒无任何帧响应立即判定断线重连
这段实现有四个极其严谨的安全边界:
- 只订阅不越权:
thread/resume仅传入安装时绑定的threadId和excludeTurns: True,绝不覆盖原有的工作目录、模型、指令或沙箱权限; - 丢弃正文与拒绝代答审批:在
_response和保活循环中,所有服务端推流下来的会话文本通知(Turn Notifications)在内存中读取后立即丢弃,绝不写盘;如果收到服务端发来的敏感操作审批请求(Approval Requests),常驻连接绝不代答,必须留给用户在自己的 Codex 客户端中人工确认; - 指数退避重连与归零恢复:断线后按
1s -> 2s -> 4s ... -> 60s指数退避重连;一旦连续稳定连接满 60 秒,退避延迟自动重置回1s; - 新鲜度门控(
resident_status):外部执行yobiru codex-bridge status读取resident.json时,如果state == "connected"但updated_at距今超过 15 秒,会立即将其判定为"stale"(陈旧失效),绝不用过期的静态文件欺骗用户。
2. 破解 CLI 半途崩溃引发的重复投递:uncertain 状态与 [TAILMSG:<id>] 对账
当 codex_bridge.py 调用外部子进程 codex queue --thread UUID --message PROMPT 时,如果子进程超时(TimeoutExpired)、返回非零退出码,或者因为进程被杀导致没有拿到标准输出里的 Queued message <queueId> for thread <threadId>. 回执,桥接器该怎么办?
如果简单粗暴地当作失败并在 15 秒后重新调用一次 codex queue,那么当上次调用其实已经送达 app-server 只是回执丢失时,就会造成同一条指令在入口会话里被排入两次!
来看看 codex_bridge.py(第 448~520 行)与 codex_queue_client.py 是如何实现精确状态区分的:
flowchart LR
    A["pending / retry<br/>确定尚未发出"] -->|"1. 调用前预检 Socket / 桌面进程失败<br/>(delivery_unknown = False)"| B["retry 状态<br/>指数退避自动重投"]
    A -->|"2. 先持久化标记为 sending<br/>再启动 codex queue 子进程"| C{"子进程执行结果"}
    C -->|"拿到精确 Queued message 回执"| D["enqueued 状态<br/>投递完成"]
    C -->|"超时 / 非零退出 / 进程崩溃中断<br/>(delivery_unknown = True)"| E["uncertain 状态<br/>严禁自动重发!"]
    E -->|"3. 启动只读 app-server --listen stdio://<br/>执行 thread/read 扫描最近 100 轮 userMessage"| F{"是否找到 [TAILMSG:id]?"}
    F -->|"找到标记"| G["delivered 状态<br/>确认已送达"]
    F -->|"未找到标记"| E

    style A fill:#1e293b,stroke:#3b82f6,stroke-width:2px,color:#fff
    style B fill:#451a03,stroke:#f59e0b,stroke-width:2px,color:#fff
    style D fill:#064e3b,stroke:#10b981,stroke-width:2px,color:#fff
    style E fill:#3f1717,stroke:#ef4444,stroke-width:2px,color:#fff
    style G fill:#065f46,stroke:#10b981,stroke-width:2px,color:#fff
- 投递前探针 vs 投递中异常:在启动
codex queue之前,客户端会先通过unix_socket_problem检查 Socket 文件是否存在、是否属于当前 UID、所在目录是否可被其他用户篡改(防止粘滞位缺失导致 Socket 劫持),并执行一次零字节connect()探针。如果在这阶段失败(如socket_stale或 macOS 桌面进程未启动),抛出CodexAppError(..., delivery_unknown=False),桥接器将其记为retry并放心自动重试; sending先落盘,崩溃即uncertain:一旦准备真正执行codex queue,桥接器先在 SQLite 中执行UPDATE messages SET state='sending'并commit()。哪怕此时整台机器掉电或进程被强杀,下次dispatch_due启动时的第一行代码就是:
任何进入self.db.execute("UPDATE messages SET state='uncertain',error='interrupted_send' WHERE state='sending'")uncertain的记录,永远不会再次调用codex queue重发!- 只读
stdio://标记对账(_reconcile):对于uncertain记录,桥接器会拉起一个短生命周期的只读codex app-server --listen stdio://(显式固定CODEX_HOME环境变量,确保读取的账户与目标运行时完全一致),发送thread/read读取最近 100 个 Turn。注意_user_markers(codex_queue_client.py第 61~71 行)的一个极佳细节:它只扫描item.type == "userMessage"中的文本是否包含[TAILMSG:<id>]标记,绝不扫描模型输出或工具输出 ——因为模型输出或工具报错里完全可能出现该 ID 字符串,那不能作为用户消息已入队的证据。一旦找到标记,状态立即收敛为delivered。
3. 进程组超时围栏(RECEIVER_MARGIN)与 workspace-write 沙箱最小权限边界
在 codex_bridge.py 中还有两处令我印象深刻的防御性设计:
- 外层超时减 10 秒安全垫(
handler_budget):
当用户配置了excluded_kinds将特定类型的消息分流给外部本地程序处理时,接收端tailmsg.py调用唤醒适配器的总超时默认是hook_timeout_s = 120秒。如果外部处理程序卡死,而桥接器也等满 120 秒,接收端就会直接把桥接器进程杀掉,导致外部处理程序变成孤儿进程残留后台。因此,handler_budget()强制取min(self.handler_timeout, hook - RECEIVER_MARGIN)(预留 10 秒余量),并在超时瞬间通过os.killpg(process.pid, signal.SIGKILL)将外部处理程序及其派生的整个进程组彻底清理干净,然后以退出码0返回给接收端,确保已启动过的外部程序绝不被接收端自动重放! - 为什么严禁把
~/.tailmsg整个目录加入 Codex 沙箱可写根?
在 Linux 下以sandbox_mode="workspace-write"运行入口会话时,很多开发者图省事会把整个~/.tailmsg挂进writable_roots。作者在docs/CODEX_SANDBOX.md中一针见血地指出:如果把整个~/.tailmsg或~/.tailmsg/codex-bridge设为可写,一旦入口会话遭遇恶意消息的提示词注入,模型就能直接篡改config.json(放宽access_policy白名单)、修改codex-bridge.json(强行把allow_replies: false改成true外发敏感数据)甚至篡改bridge.sqlite3队列!
正确的最小权限配置只开放以下三个精确子目录(若需附带文件回复则加上outbox):
甚至连为什么不能只挂载codex app-server --listen unix:///home/you/.codex/yobiru.sock \ -c 'sandbox_mode="workspace-write"' \ -c 'approval_policy="never"' \ -c 'sandbox_workspace_write.writable_roots=["/home/you/.tailmsg/inbox","/home/you/.tailmsg/requests","/home/you/.tailmsg/codex-bridge/handled"]' \ -c 'sandbox_workspace_write.network_access=false'inbox/<id>.json单文件都解释得清清楚楚:因为yobiru ack与追踪响应需要创建同级临时文件(.tmp-*)并执行原子替换(os.replace)以及写入 SQLite WAL 日志,因此必须赋予这三个子目录级的写权限,同时让上层的config.json与代码文件保持严格只读。
五、本机实测与跨平台深水区排障:我在 macOS (Darwin + Python 3.13) 跑通 Yobiru 0.5.1 的真实踩坑记录
在 docs/VERIFICATION.md 第 216 行,作者坦诚地注明了一项尚未覆盖的验证边界:“0.5.0/0.5.1 的隔离发布测试套件均在 Linux (Python 3.12) 上运行,尚未在真实 macOS 或 Windows 环境上跑过完整测试与 yobiru 命令。”
为了验证 Yobiru 0.5.1 在真实 macOS(Apple Silicon,Darwin,Homebrew Python 3.13.1) 上的表现,我将仓库克隆至本机工作区,完整执行了构建一致性校验、paths / onboard / doctor 诊断,以及全部 374 个自动化单元测试。
1. 构建校验与本机 onboard / doctor 实测输出
首先运行打包一致性与隐私卫生检查:
# 校验插件同步与隐私边界
python3 tools/build_plugin.py check
# 输出: check: ok
接着在隔离的 --home 目录下实测 paths、onboard 与 doctor:
# 1. 查看运行时路径与 Python 解释器解析结果
sh plugins/yobiru/scripts/yobiru --home ./test_tailmsg paths
{
  "plugin_root": ".../yobiru/plugins/yobiru",
  "plugin_version": "0.5.1",
  "python": "/opt/homebrew/opt/python@3.13/bin/python3.13",
  "python_version": "3.13.1",
  "home_source": "--home",
  "config_exists": false
}

# 2. 执行只读引导检查
sh plugins/yobiru/scripts/yobiru --home ./test_tailmsg onboard
Yobiru onboarding for Darwin (read-only; nothing was changed)
Installing the plugin ran nothing: there is no install hook. These steps make it work.
[x] 1. Python 3.8+: 3.13.1
[ ] 2. Install Tailscale: install the Tailscale app (Mac App Store or the standalone download), open it, approve the VPN / system extension prompt in System Settings, then sign in from the menu bar. The app's CLI is /Applications/Tailscale.app/Contents/MacOS/Tailscale
        docs: https://tailscale.com/docs/install/mac
        who: user (GUI approval needed)
...
[ ] 6. Run the receiver as a service: print the definition, install it at the place named in its header and start it
        command: yobiru service-template launchd
        who: agent
注意上面 paths 输出中的一个精妙工程细节:我的当前 Python 实际可执行文件位于 /opt/homebrew/Cellar/python@3.13/3.13.1/Frameworks/Python.framework/Versions/3.13/bin/python3.13,但 Yobiru(自 0.4.4 版本起)自动通过 os.path.samefile 将其归一化为了稳定的 Homebrew 软链路径 /opt/homebrew/opt/python@3.13/bin/python3.13!这彻底解决了 macOS 开发者最常遇到的一个痛点:一旦日后执行 brew upgrade python@3.13 升级到 3.13.2,旧的 Cellar/.../3.13.1 目录被清理,普通写死 sys.executable 的 launchd plist 服务就会立刻无限崩溃重启,而 Yobiru 生成的服务模板则能跨越小版本升级持续稳定运行。
2. 在 macOS 上跑 374 个单元测试暴露出的 4 处 Linux/Darwin 底层差异
当我直接在 macOS 默认环境下运行 python3 -m unittest discover -s tests(228 个测试)与桥接测试套件(146 个测试)时,我发现了 4 个非常典型的 Linux 与 macOS (BSD) 底层系统行为差异,这也是第一手实机测试才能挖出的干货:
| 踩坑序号 | 触发的测试模块 | macOS 实机报错现象 | 底层系统根因剖析与排障方案 |
|---|---|---|---|
| 坑位 1 | test_install_codex_bridge_linux.py (21 个测试 Error) |
self.listener.bind(str(self.socket_path)) 抛出 OSError: AF_UNIX path too long |
BSD sockaddr_un.sun_path 104 字节硬上限:Linux 下默认 TMPDIR 是 /tmp(4 字节)且上限为 108 字节;而 macOS 默认 TMPDIR 是 /var/folders/n4/.../T/(长达 49 字节),加上测试生成的嵌套目录名后总长超过 104 字节。实测修复:显式指定 TMPDIR=/tmp python3 -m unittest ... 后,21 个 Linux 桥接安装器测试在 macOS 上 100% 全部通过! |
| 坑位 2 | test_service_python.py & test_install_codex_bridge.py |
AssertionError: '/var/folders/...' != '/private/var/folders/...' |
macOS /var -> /private/var 符号链接:macOS 的 /var 与 /tmp 均是指向 /private/var 与 /private/tmp 的系统级软链。Python tempfile.TemporaryDirectory() 返回未解析的 /var/folders/...,而子进程内部通过 Path.resolve() 或 sys.prefix 拿到的则是解析后的 /private/var/folders/...。在编写跨平台路径断言时需统一先做 .resolve()。 |
| 坑位 3 | test_cli.py (WakeConfigTests) |
error: /bin/false is not an executable file |
POSIX 基础工具路径差异:在 Debian/Ubuntu Linux 上,false 位于 /bin/false(或 /usr 合并软链);而在开启了 SIP 的现代 macOS 上,false 仅存在于 /usr/bin/false,/bin/false 并不存在(而 /bin/sh 存在)。因为 Yobiru 的 wake-config --exec 会严格校验可执行文件真实存在且具备 +x 权限,所以在 macOS 上配置测试适配器时应使用 /usr/bin/false 或 /usr/bin/true。 |
| 坑位 4 | test_transport_diagnostics.py |
期望捕获 ConnectionRefusedError,实际返回 TimeoutError: [Errno 60] Operation timed out |
macOS 本地网络栈与防火墙行为差异:当向一个刚刚关闭监听的临时回环端口发起连接时,Linux 内核立即回复 RST 触发 ConnectionRefusedError,而在开启了本地网络过滤器的 macOS 环境下可能触发 3 秒连接超时(Errno 60)。不过 Yobiru 的诊断输出在两种异常下均正确打印了目标节点、tailscale ping --c 3 --timeout 3s 排障建议以及未知投递状态的 Message ID,核心安全语义完全符合预期。 |
六、总结与个人部署建议
通过对 Yobiru 源码与协议规范的完整拆解,我认为它为当前火热的 Agent 工具生态提供了一个极其清醒的范本:并非所有 Agent 协同都需要构建复杂的云端 SaaS 平台或开放高危的远程代码执行接口。
在我自己的多机开发流中落地这套架构时,总结出以下三条最佳实践供参考:
- 坚持使用稳定短主机名路由(
HOST/AGENT):日常发信统一使用dev-server/codex或bot-box/grok,让 Yobiru 在每次发送时动态读取tailscale status --json并自动选中唯一在线节点;对于云端容器环境,务必将数据目录独立挂载在持久化卷(如--home /workspace/.tailmsg),避免容器重建后丢失请求账本; - 区分“通知(Notice)”与“追踪请求(Tracked Request)”:日常构建完成提醒、日报推送一律使用
--kind notice(无需回复,不占对方模型额度);凡是需要对方 Agent 给结论或改代码的任务,一律使用request send --timeout-seconds 900,遇到超时先跑request status ID --refresh对账,绝不盲目重发; - 严守“消息不是批准”与沙箱最小可写根原则:在 Linux 上部署
codex-bridge时,务必启用codex_resident.py保活守护进程,并严格只将inbox、requests与codex-bridge/handled三个子目录加入writable_roots,将allow_replies的开启权牢牢掌握在自己手中。