
当全网都在狂欢 Vibe Coding:独立开发者该如何构建“营销工程化”智能体底座
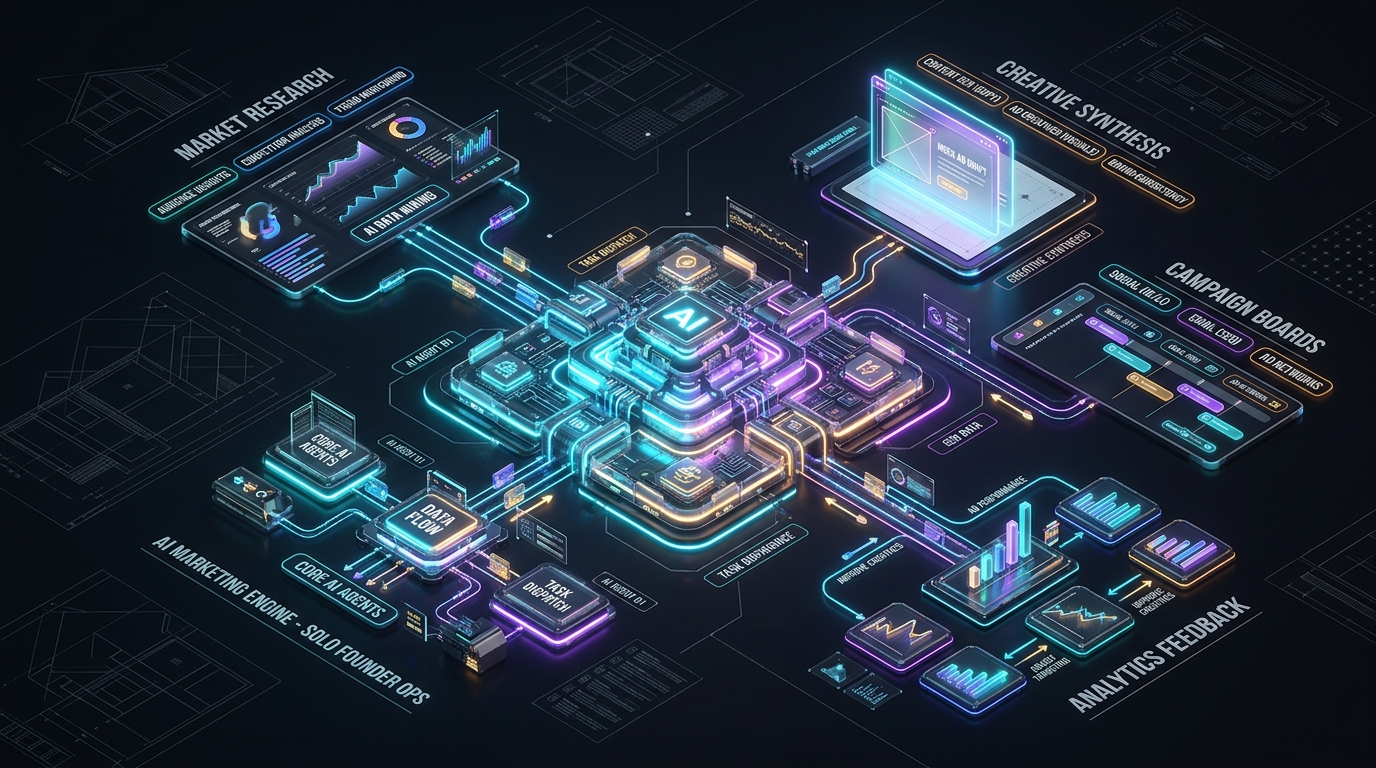
随着大语言模型与智能体开发环境(ADE)的普及,“Vibe Coding”(氛围编码)正在以惊人的速度席卷整个开发者社区。如今,一名独立开发者或 Solo Founder 仅凭一个点子、几轮自然语言 Prompt 与 Cursor、Windsurf 或 Codex 的协同,就能在几天甚至几小时内搓出一款功能完备的 SaaS、微型工具或移动端应用。然而,一个残酷的现实随之浮出水面:当软件生产的边际成本趋近于零,分发与获取用户注意力的成本却在指数级攀升。
绝大多数技术出身的独立创业者,面临着相同的困境:代码写得飞快,上线后却是一片死寂。传统营销建议往往要求开发者“去写推文、去拍短视频、去搞冷邮件外联”,但这不仅严重消耗开发者的心智带宽,更容易沦为零散、低效且缺乏系统反馈的体力消耗战。
近日,独立产品人 Su(@Sukiea1008)分享了一篇深度长文《Vibe Marketing:如何成为营销工程师》(译自技术营销专家 Shann Holmberg 的核心思想体系)。文章抛出了一个切中时代脉搏的论断:既然我们能够用“工程师思维 + AI 智能体”将软件开发变成高效流水线,为什么不能用同一套工程化范式,将混沌的市场营销重塑为自动化、可迭代、有明确闭环反馈的工程系统?
本文将结合一线独立开发者的实战经验,深度拆解从 “Vibe Coding” 跃迁到 “Vibe Marketing(营销工程化)” 的底层逻辑,并为你提供一套可直接落地的智能体营销系统架构指南。
1. 范式转移:从“营销玄学”到“营销工程(Marketing Engineer)”
在传统的软件团队中,研发与营销往往是两套完全割裂的语言体系:
- 研发思维:确定性输入、版本控制、CI/CD 自动化流水线、单元测试、错误重试、可观测性监控;
- 传统营销:感性灵感、零碎的文案草稿、主观审美、分散在几十个 SaaS 后台的数据报表、难以溯源的转化归因。
当团队规模缩减为一人公司(Solo Company)时,这种割裂会瞬间拖垮创始人。你不可能上午写底层高并发代码,下午突然切换脑回路去凭空写 10 条小红书文案或推特营销话术。
flowchart LR
    subgraph Old["传统割裂模式:高内耗与断层"]
        direction TB
        Dev["开发者 (Vibe Coding 狂搓代码)"] -->|"代码交付"| Product["产品上线"]
        Product -.->|"手工拼凑/凭感觉营销"| Mktg["零散推文 / 手工发信 / 盲目投放"]
        Mktg -.->|"数据孤岛/归因模糊"| Void["市场沉寂 (无法迭代)"]
    end

    subgraph New["营销工程化 (Marketing Engineering)"]
        direction TB
        Knowledge["企业/产品知识库 (Ground Truth)"] --> Engine["智能体流水线 (ADE + Harness)"]
        DataLayer["统一度量与数据层 (Ad/Web/CRM)"] --> Engine
        Engine -->|"工单驱动 + 自动 Checklist 循环"| Deliverables["多渠道资产交付 (内容/落地页/广告)"]
        Deliverables -->|"真实市场表现"| Feedback["结果复盘与回填"]
        Feedback --> Knowledge
    end
营销工程师(Marketing Engineer)的核心定位,不再是每天手动敲字、发帖的内容苦力,而是 营销自动化系统的架构师。你的职责是:
- 定义上下文资产:将产品主张、目标受众画像、客户痛点、异议清单沉淀为机器可理解的结构化数据;
- 串联数据与智能体:编写自动化脚本与 Skill,让模型能够拉取实时表现数据;
- 制定质检规则(Checklists):建立明确的准入准出验收机制(Definition of Done),让智能体在有限上下文内自迭代;
- 保留人类审核哨卡(Human-in-the-Loop):只在战略决策、方向确认和最终上线扳机处执行人工仲裁。
2. 营销工程智能体系统的四层四维架构
一套工业级可复用的营销工程系统,必须包含清晰的层次划分。正如构建微服务架构一样,缺乏分层的 Prompt 堆砌最终只会导致上下文污染与严重幻觉。
flowchart TD
    subgraph L1["第一层:知识与上下文层 (Knowledge & Context Layer)"]
        K1["内部真实数据 (audience.md, approved-claims.md, product-offer.md)"]
        K2["外部动态情报 (last30days 调研, 竞品监控, 行业热点, SEO 搜索词)"]
    end

    subgraph L2["第二层:数据与度量层 (Marketing Data Layer)"]
        D1["广告平台 (Meta/Google Ads API)"]
        D2["行为分析 (PostHog/GA4/Umami)"]
        D3["交易与CRM (Stripe/HubSpot)"]
        D_Sync["定时拉取与归一化脚本 (Cron Jobs)"]
        D1 --> D_Sync
        D2 --> D_Sync
        D3 --> D_Sync
        D_Warehouse[("轻量营销数据仓库 SQLite / DuckDB")]
        D_Sync --> D_Warehouse
    end

    subgraph L3["第三层:工作空间与拓扑调度 (Workspace & Orchestration)"]
        ADE["智能体环境 (Cursor / Orca / CLI Agents)"]
        CoordAgent["协调智能体 (Coordinator Agent)"]
        Spec_Content["内容创作智能体"]
        Spec_Paid["投放创意智能体"]
        Spec_CRO["落地页转化智能体"]
        ADE --> CoordAgent
        CoordAgent --> Spec_Content
        CoordAgent --> Spec_Paid
        CoordAgent --> Spec_CRO
    end

    subgraph L4["第四层:工单驱动与质检闭环 (Tickets & Execution Loop)"]
        Ticket["工单系统 (tickets/xxx.md)"]
        Loop["自校正循环 (Generate -> Self-Check -> Fix)"]
        Gate["人类终审门禁 (Human Gatekeeper)"]
        Publish["分发渠道 (X / Blog / Email / Ads)"]
        Ticket --> Loop
        Loop --> Gate
        Gate --> Publish
    end

    L1 --> L3
    L2 --> L3
    L3 --> L4
    Publish -.->|"新数据与转化回填"| D_Sync
2.1 知识与上下文层(Knowledge Layer)
智能体之所以输出泛泛而谈、毫无灵魂的营销废话,99% 的原因不是模型不够聪明,而是提供给它的上下文严重欠缺。
在营销工程中,知识必须严格区分为两类:
- 内部事实资产(Ground Truth):
audience.md:极为细致的目标受众画像、核心痛点场景、常用术语习惯;product-and-offer.md:产品的核心功能清单、定价策略、不可动摇的交付承诺;approved-claims.md(核心红线文件):经过法务、技术和产品负责人背书的可宣传论据,严禁模型虚构不存在的性能或效果;customer-objections.md:真实用户访谈、客服工单中遇到的购买犹豫与反驳理由。
- 外部动态情报(Dynamic External Context):
- 行业最新讨论痛点(借助
/last30days等 Skill 实时扫描 X、Reddit、YouTube); - 竞品发布动态、落地页文案变更与广告创意监控。
- 行业最新讨论痛点(借助
[!IMPORTANT]
真实性防火墙原则:调研材料进入知识库前,必须显式标注其可信等级与时间戳。智能体必须能明确区分“已经过数据验证的事实”、“创始人随口提出的构想”与“网络竞品未经证实的吹捧”,绝不可混为一谈。
2.2 营销数据层(Marketing Data Layer)
单次营销活动的点击率并不能说明问题。你真正关心的是:哪一套文案切入点,带来了留存率最高、付费意愿最强的高净值客户?
这需要将碎片化的数据打通:
- 链路标识传递:在链接中埋入标准 UTM 参数、Campaign ID 与 Ad ID,并确保这些标识能够伴随注册事件一路沉淀进 Stripe 或 CRM;
- 离线轻量数仓:无需搭建昂贵复杂的大数据平台,利用简单的 Node.js/Python 定时脚本(Cron Job)每天凌晨同步一次广告消耗、页面 PV/UV 与实际付费,存入轻量数据库(如 DuckDB、SQLite 或 Supabase);
- 标记未知归因:遇到因隐私防护或跨设备造成的追踪丢失,明确标记为“未知来源”,杜绝模型盲目脑补虚假的 100% 转化归因。
2.3 智能体工作空间与拓扑结构(Workspace Organization)
不要将所有营销任务塞给同一个通用聊天窗口。正如代码仓库需要清晰的包目录结构,营销工程空间应当以职能模块进行系统化建构:
marketing/
├── shared-knowledge/               # 跨职能共享基准文件
│   ├── audience.md                 # 目标用户与痛点
│   ├── product-and-offer.md        # 产品规格与方案
│   ├── positioning.md              # 市场定位
│   └── approved-claims.md          # 唯一允许采用的宣传口径
├── paid-and-creative/              # 付费广告与视觉创意
│   ├── knowledge/                  # 投放专属知识(客户异议、历史测试)
│   ├── briefs/                     # 投放简报
│   ├── creative-checklist.md       # 创意合规审查清单
│   └── outputs/                    # 最终生成的素材资产
├── content/                        # 博客、推特、长文内容流水线
│   ├── workflows/                  # 可复用发布流程
│   ├── skills/                     # 定制化分析与撰写 Skill
│   └── drafts/                     # 草稿区
├── campaigns/                      # 专项营销战役工作区
│   └── 2026-v2-launch/             # 例如:V2.0 大版本发布活动
│       ├── brief.md                # 本次战役共享核心目标
│       ├── tickets/                # 细分可并行执行的工单
│       └── results-and-learnings/  # 最终效果与复盘日志
3. 闭环执行实战:从一张工单到自愈循环
营销工程的核心精髓,在于用确定性的工单驱动智能体,并使用自动化 Checklist 建立自校正循环。
3.1 工单系统(Tickets-Driven Execution)
当你要策划一次营销动作(例如新功能上线、新落地页搭建),首先在 tickets/ 目录下创建结构化 Markdown 工单。这种方式将模糊的“做点营销”具象为明确的交付约束:
# 工单:生成新版本付费创意素材与文案套装
- **执行角色**:Paid Creative Specialist Agent
- **前置依赖**:`campaigns/2026-v2-launch/brief.md` 审核通过
- **状态**:等待执行

## 1. 必读上下文
- 必须遵循:`shared-knowledge/approved-claims.md`
- 视觉规范:`campaign-book/visual-guidelines.md`
- 历史踩坑:`paid-and-creative/knowledge/creative-test-learnings.md`

## 2. 交付要求
- 针对痛点 A、B 分别生成 3 套差异化的切入文案(面向开发者与面向团队 Lead);
- 输出每组文案对应的构图布局代码与配图 Prompt;
- 撰写一份合规核查报告,链接所有引用的论据来源。

## 3. 自动化门禁清单(Checklist)
- [ ] 所有宣传话术均能在 approved-claims.md 中找到明确依据
- [ ] 文案中严禁出现绝对化修饰词(如“全网唯一”、“绝对无 Bug”)
- [ ] 导出尺寸严格匹配 16:9 与 1:1 双规格
- [ ] 广告承诺的核心利益点与落地页实际功能 100% 保持一致

## 4. 人工终审触发条件
- 满足全部 Checklist 后,将工单状态变更为 `Pending Human Review`;
- 严禁自行调用 API 进行公开发布或扣款投放。
3.2 自校正执行循环(Self-Correction Loop)
传统使用 ChatGPT 的痛点是:生成出来的文案往往总有几处不合要求,用户需要来回口头纠错。而在营销工程体系中,我们利用智能体环境的命令行与测试工具,让智能体在封闭沙箱中完成“自我纠偏”:
sequenceDiagram
    autonumber
    actor Founder as 创始人 / 营销工程师
    participant Coordinator as 协调智能体
    participant Specialist as 专业制作智能体
    participant Checker as 质检规则 (Checklist Runner)
    participant Repo as 资产仓库 (Outputs)

    Founder->>Coordinator: 下发活动工单 (tickets/xxx.md)
    Coordinator->>Specialist: 注入专属上下文并分配任务
    loop 自主修正循环 (Max: 3次)
        Specialist->>Specialist: 检索内部知识 + 撰写素材变体
        Specialist->>Checker: 提交草稿比对 approved-claims.md 与格式
        alt 存在违规或格式缺失
            Checker-->>Specialist: 反馈具体违规条目与行号 (不通过)
            Specialist->>Specialist: 针对性重写与调整
        else 全部检查通过
            Checker-->>Specialist: 绿灯标记 (通过)
        end
    end
    Specialist->>Repo: 存入 outputs/ 并生成审核比对简报
    Specialist->>Founder: 触发人工审批通知 (Pending Review)
    Founder->>Repo: 人工核准 / 调整参数后触发上线
4. 独立开发者起步实战:从手头的一项任务开始
你不需要在一夜之间搭建起包含几十个智能体的大型系统。正如敏捷软件开发提倡 MVP(最小可行产品),营销工程化也应当以 MVE(Minimum Viable Engine,最小可行引擎)起步。
推荐的第一个起点:竞品与市场情报雷达
如果你准备对产品进行迭代或策划一次推广,建议先从 自动化竞品雷达 开始搭建第一条流水线:
# 典型的三步走渐进式搭建:
1. 创建轻量监控脚本:抓取核心竞品 3 家的产品落地页与更新日志 Changelog;
2. 接入 LLM 语义差异比对:对比竞品在定价策略、主打核心关键词、支持功能上的变化;
3. 输出情报周报:让智能体结合你产品的 positioning.md,总结出“我们当前的相对优势点”与“可攻击的市场空白区”。
避坑指南:给技术创始人的 4 条硬核防坑建议
- 警惕“智能体过度设计”(Agent Over-Engineering):
早期往往容易陷入误区——明明一个清晰包含约束的 Prompt 就能完成的任务,非要拆成 4 个智能体互相握手。优良的上下文资产(Context),其威力远远超过盲目增加智能体数量。 - 严格隔离密钥与执行权限:
数据分析需要“读取”权限,创建草稿需要“写入”权限,而划扣信用卡预算、公开发布内容则属于“高危生产权限”。务必将 API Key 存放于环境变量并设立门禁,严禁将生产发布权全权委托给无人工看护的自主智能体。 - 杜绝“未转义美元符”与符号灾难:
在涉及代币符号、价格标注(如8 ~ 13 美元)或技术变量时,必须采用标准化代码块包裹或显式文本单位,防止 Markdown 与 KaTeX 解析器将价格误判为行内数学公式定界符,造成排版乱码。 - 将每一次人类干预沉淀为资产:
当你在审核中否定了智能体生成的某套创意时,不要仅仅在对话框里回复“不行”。把你的理由写成一句话追加到customer-objections.md或creative-checklist.md中(例如:“该切入点向非技术受众推介底层协议细节,认知负荷过高”)。下一次运行同一工作流时,整个系统的防御力就会自动提升一级。
5. 总结:一人公司的终极护城河
在人工智能重塑生产力的下半场,代码本身的壁垒正在被快速抹平。未来衡量一名独立创业者、独立开发者核心竞争力的,绝不仅仅是你敲击键盘生成代码的速度,而是你 能否将“产品构建”与“市场分发”两套飞轮同时工程化 的能力。
- Vibe Coding 赋予了你十倍于往昔的产品生产力;
- Vibe Marketing(营销工程化)则赋予了你源源不断触达真实客户、验证商业闭环的确定性抓手。
别再让凝结心血的优秀代码在互联网的角落悄无声息地荒废。从今天起,打开你的终端,像编写系统架构一样,为你的产品敲下第一个 marketing/ 目录吧。