
用心智图谱穿透分布式迷雾:ByteByteGo system-design-101 的全栈架构可视化解构与实战权衡
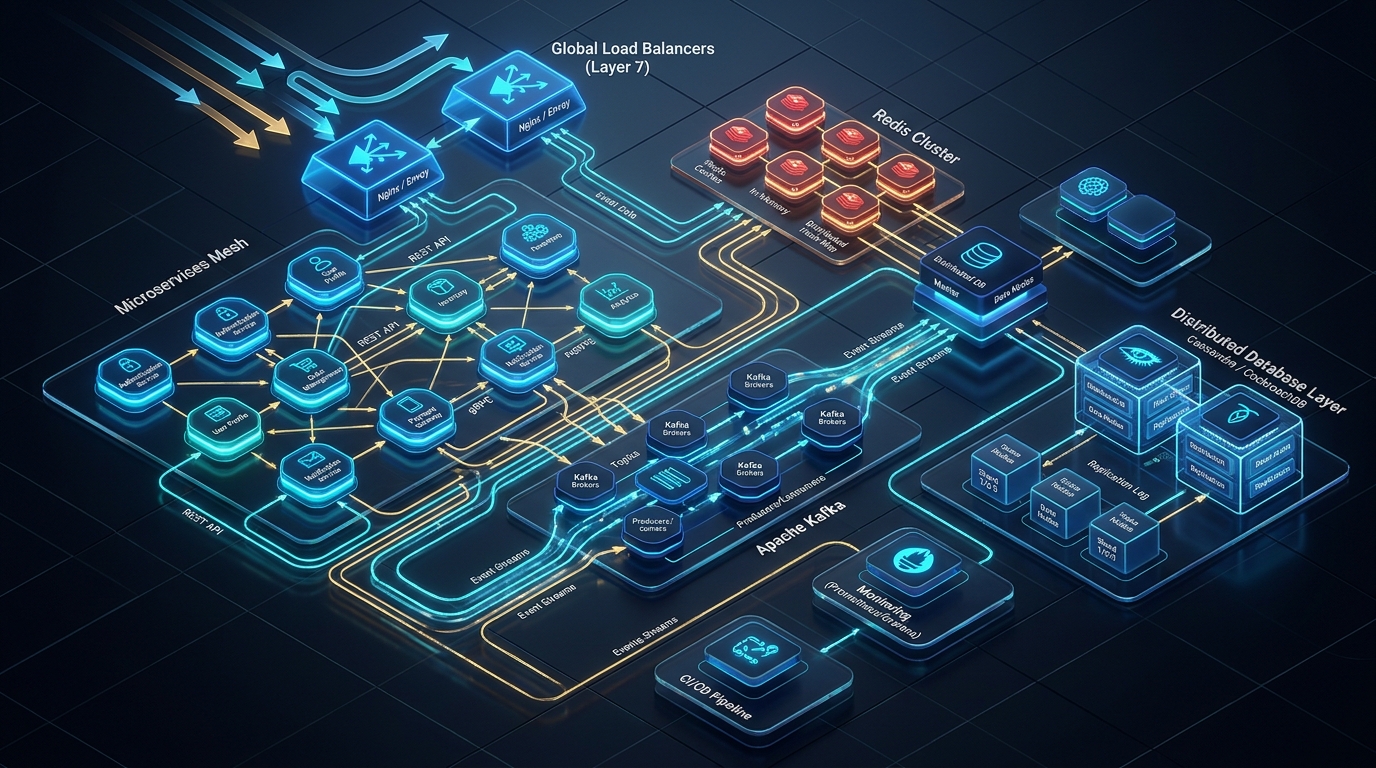
在分布式系统与大规模软件工程领域,系统设计(System Design)始终是衡量工程师从“代码搬运工”跨越到“资深系统架构师”最关键的分水岭。然而长期以来,系统设计的学习体验极其割裂:一端是充斥着晦涩数学推导的学术论文与厚达数百页的底层 RFC 协议规范;另一端则是碎片化、缺乏上下文的八股面试题。初学者面对微服务治理、缓存一致性、存储引擎演进与高并发网络模型时,极易陷入“只见技术名词,不见系统脉络”的认知瘫痪。
在 GitHub 上狂揽超过 11 万 Stars 的开源项目 ByteByteGoHq/system-design-101,以教科书级的可视化水准重构了这一知识图谱。它不仅涵盖了从网络传输层、API 网关、缓存拓扑、消息队列到分布式存储的完整基础设施图谱,更收录了 Netflix、Uber、Figma、Discord、Twitter 等一线科技巨头在百亿级流量下的真实架构演进实录。本文将以系统工程的视角,深度拆解其全栈心智模型与工业级设计权衡。
一、 全景心智图谱:分布式系统的五层分层架构
现代复杂分布式系统之所以难以掌控,核心在于其组件之间的非线性交互。system-design-101 最具工业价值的贡献,在于将纷繁复杂的云原生中间件与设计模式,归纳为自顶向下的五层确定性心智模型:
flowchart TD
    subgraph Layer1 ["1. 接入与网络传输层 (Traffic & Transport)"]
        DNS["Anycast DNS / CDN 全球边缘加速"]
        L4["L4 负载均衡 (LVS / IPVS / eBPF)"]
        L7["L7 负载均衡与反向代理 (Nginx / HAProxy / Envoy)"]
        Gateway["API 网关 (认证鉴权 / 限流降级 / 协议转换)"]
        DNS --> L4 --> L7 --> Gateway
    end

    subgraph Layer2 ["2. 通信协议与服务协同层 (Protocols & Microservices)"]
        REST["RESTful API (JSON / HTTP/1.1)"]
        gRPC["gRPC (HTTP/2 多路复用 / Protobuf)"]
        Realtime["实时全双工 (WebSocket / SSE / Webhook)"]
        SAGA["分布式事务编排 (SAGA / TCC / Outbox 模式)"]
    end

    subgraph Layer3 ["3. 高速缓存与性能加速层 (Caching & Acceleration)"]
        LocalCache["进程内本地缓存 (Caffeine / Guava)"]
        RedisCluster["分布式缓存集群 (Redis Cluster / Sentinel)"]
        CachePattern["读写拓扑 (Cache-Aside / Write-Through / Write-Behind)"]
        Defense["防崩塌防御网 (布隆过滤器 / 互斥锁 / 随机过期抖动)"]
    end

    subgraph Layer4 ["4. 消息总线与异步流处理层 (Messaging & Streaming)"]
        Kafka["分布式事件日志 (Apache Kafka / Pulsar)"]
        Queue["任务队列 (RabbitMQ / SQS)"]
        CDC["变更数据捕获 (Debezium / Flink CDC)"]
        ZeroCopy["底层高吞吐 (Sendfile 零拷贝 / 顺序磁盘追加写)"]
    end

    subgraph Layer5 ["5. 持久化存储与数据引擎层 (Storage & Persistence)"]
        BTree["读密集关系型引擎 (B+ Tree: MySQL / PostgreSQL)"]
        LSM["写密集分布式引擎 (LSM-Tree: RocksDB / Cassandra)"]
        Consensus["分布式共识算法 (Raft / Paxos / Multi-Paxos)"]
        Replication["多副本同步 (WAL / 读写分离 / 分库分表)"]
    end

    Layer1 --> Layer2
    Layer2 --> Layer3
    Layer2 --> Layer4
    Layer3 --> Layer5
    Layer4 --> Layer5

    style Layer1 fill:#e1f5fe,stroke:#0288d1,stroke-width:2px
    style Layer3 fill:#fff3e0,stroke:#f57c00,stroke-width:2px
    style Layer5 fill:#e8f5e9,stroke:#2e7d32,stroke-width:2px
这一分层架构清晰地展示了真实请求的完整生命周期:从边缘网络进入网关过滤,穿透协议层到达业务逻辑,利用多级缓存阻挡大部分流量冲击,通过事件总线进行异步削峰与最终一致性同步,最终沉淀到底层持久化引擎。
二、 核心攻坚一:网络接入与 API 传输架构的演进密码
在分布式系统的前哨战中,许多开发者常常混淆 反向代理(Reverse Proxy)、负载均衡器(Load Balancer)与 API 网关(API Gateway)的边界。system-design-101 给出了精准的职责划分与选型依据。
1. 边缘三剑客的职责边界
| 维度 | 反向代理 (Reverse Proxy) | 负载均衡器 (Load Balancer) | API 网关 (API Gateway) |
|---|---|---|---|
| 典型代表 | Nginx, Caddy | AWS ALB, F5, HAProxy | Kong, Apache APISIX, Spring Cloud Gateway |
| 核心定位 | 屏蔽真实后端,提供静态加速与 TLS 卸载 | 跨多个实例均匀分配流量,防止单点过载 | 业务流量入口控制器,处理跨横切面非功能需求 |
| 工作层级 | Layer 7 (应用层) | Layer 4 (传输层) 或 Layer 7 | Layer 7 (深度理解 HTTP 协议与业务语义) |
| 核心功能 | Gzip 压缩、SSL/TLS 终止、缓存静态资源 | 轮询/最小连接数算法、健康检查(Health Check) | 鉴权认证 (JWT/OAuth2)、动态路由、限流熔断、API 聚合 |
2. API 通信协议的四维权衡
系统内部与外部的通信不是单一的 REST 就能满足的。面对不同延迟与数据密度要求,架构师必须进行精准匹配:
classDiagram
    class REST {
        +协议: HTTP/1.1 or HTTP/2
        +载荷: JSON (自描述纯文本)
        +适用场景: 公共开放 API, CRUD 系统
        +缺陷: 头阻塞, 载荷大, 缺乏强类型
    }
    class gRPC {
        +协议: HTTP/2 (流控与复用)
        +载荷: Protocol Buffers (二进制序列化)
        +适用场景: 内部微服务高性能 RPC, Polyglot 系统
        +缺陷: 浏览器原生兼容差, 调试成本高
    }
    class WebSocket {
        +协议: 独立双向全双工长连接
        +载荷: 任意文本或二进制
        +适用场景: 实时金融交易, 协同编辑, 在线聊天
        +缺陷: 有状态连接维持难, 负载均衡需粘性会话
    }
    class SSE {
        +协议: HTTP 纯文本长流 (Server-Sent Events)
        +载荷: event-stream
        +适用场景: LLM 大模型流式输出, 监控通知单向推送
        +缺陷: 仅支持单向服务端到客户端推送
    }
- 对外接口:优先选择 REST / GraphQL,享受广泛的生态支持、浏览器原生兼容性与高调试友好度;
- 内部微服务:必须坚定转向 gRPC。通过 HTTP/2 单一 TCP 连接上的二进制多路复用(Multiplexing)与 Protobuf 高效序列化,将通信序列化开销与网络带宽直接压缩 50% ~ 80%;
- AI 与大模型交互:优先采用 SSE(Server-Sent Events)替代笨重的 WebSocket。SSE 基于原生 HTTP 协议,完美兼容标准反向代理、自动重连机制与 CDN 流式缓冲,是当前 LLM Token 流式渲染的事实工业标准。
三、 核心攻坚二:存储底层物理学——B+ Tree 与 LSM-Tree 的读写代价
数据库是所有高并发系统的最终承压点。system-design-101 在数据库专题中用极其精辟的可视化图解,阐明了一个根本物理定律:没有任何存储引擎能够同时在随机写、顺序写、范围查询与存储空间上做到极致。
flowchart LR
    subgraph BTreeWorld ["B+ Tree 引擎 (MySQL InnoDB / PostgreSQL)"]
        direction TB
        B_Write["随机写入 (In-place Update)"] -->|页分裂 Page Split / 离散磁盘 I/O| DiskPage["数据页落盘 (昂贵的随机寻道)"]
        B_Read["点查与范围查询 (Point & Range Query)"] -->|O(log N) 树深度寻址 / 连续叶子节点双向链表| FastRead["极致稳定的高速读性能"]
    end

    subgraph LSMWorld ["LSM-Tree 引擎 (Cassandra / RocksDB / ScyllaDB)"]
        direction TB
        L_Write["高速写入 (Append-only)"] -->|顺序追加| WAL["预写日志 WAL"]
        L_Write -->|内存排序| Mem["MemTable (跳表/红黑树)"]
        Mem -->|批量 Flush| SST["SSTable (多层不可变磁盘文件)"]
        L_Read["多层读放大 (Read Amplification)"] -->|布隆过滤器 Bloom Filter 过滤无用 SSTable| Compaction["后台定期 Compact 归并消除过期墓碑"]
    end

    style BTreeWorld fill:#e8eaf6,stroke:#3f51b5,stroke-width:2px
    style LSMWorld fill:#fbe9e7,stroke:#ff5722,stroke-width:2px
1. 物理读写代价对比
- B+ Tree 的就地更新代价(In-place Update):
- 数据直接修改在特定的 16KB 页(Page)内。当数据离散插入时,会导致严重的磁盘随机寻道与页分裂(Page Splitting),写入吞吐受限于硬件 IOPS;
- 优势:读取确定性极高,叶子节点构成双向链表,范围查找(Range Scan)只需在树上定位起点即可顺序扫描,无冗余多版本干扰。
- LSM-Tree(Log-Structured Merge-Tree)的追加写美学:
- 彻底摒弃磁盘随机写!所有写入均先追加写入 WAL(保证持久性),随后写入内存中的 MemTable;
- 内存写满后一次性顺序 Flush 到磁盘生成不可变 SSTable(Sorted String Table);
- 代价:引发了“读放大(Read Amplification)”与“空间放大”。读取时需要逐层检查各个 SSTable。工业界必须通过在每个 SSTable 头部嵌入 布隆过滤器(Bloom Filter),在纳秒级时间内排除绝大多数不包含该 Key 的文件。
2. 工业案例实证:Discord 的万亿级消息演变
Discord 的真实架构迁移正是这一底层取舍的教科书实录:
- 第一阶段(MongoDB):早期数据量小,单节点易用;
- 第二阶段(Cassandra,基于 LSM-Tree):消息量爆发至百亿级,每秒海量并发写入,Cassandra 的追加写完美承接了洪峰;
- 第三阶段(ScyllaDB,C++ 重写版 LSM-Tree):JVM 的 GC 停顿与读放大随着万亿消息沉淀开始恶化,最终迁移至无 GC 机制、直接利用 Linux AIO 优化的 ScyllaDB,将 P99 读取延迟稳定在 5 毫秒以内。
四、 核心攻坚三:高并发韧性防御——缓存三灾与支付幂等流
在真实生产环境中,系统崩溃往往不是因为正常业务代码逻辑有 Bug,而是因为边缘异常引发了雪崩效应。
1. 缓存防崩塌立体防御矩阵
flowchart TD
    Req["客户端并发请求"] --> Bloom{"布隆过滤器 Bloom Filter"}
    Bloom -- "判定 Key 必定不存在" --> Reject["直接拦截响应 404 (防御缓存穿透)"]
    Bloom -- "判定 Key 可能存在" --> CacheQuery{"查询 Redis 缓存"}

    CacheQuery -- "Cache Hit (命中)" --> ReturnData["快速返回业务数据"]
    CacheQuery -- "Cache Miss (未命中)" --> LockCheck{"互斥锁获取 (Mutex Lock)"}

    LockCheck -- "获取锁成功" --> LoadDB["查询底层数据库并回种缓存 (防御缓存击穿)"]
    LockCheck -- "未抢到锁" --> WaitRetry["短暂自旋等待 / 降级兜底返回旧快照"]

    LoadDB --> RandomTTL["设置 TTL = 基准时间 + 随机扰动 (防御缓存雪崩)"]
    RandomTTL --> ReturnData
- 缓存穿透(Cache Penetration):攻击者构造大量数据库根本不存在的恶意 Key,绕过缓存直接冲垮数据库。
- 解法:在接入层部署 布隆过滤器(Bloom Filter),用极小的位图空间快速阻断不存在的请求;对于空结果同样进行短期空对象缓存(Empty Object Caching with TTL)。
- 缓存击穿(Cache Breakdown / Hotspot Invalidation):某个超高频访问的单点热 Key 突然过期,瞬间万级并发穿透至 DB。
- 解法:使用分布式互斥锁(Mutex Lock),保证同一时刻只有一个线程去回源查库并重建缓存,其余请求排队或读取旧版本快照。
- 缓存雪崩(Cache Avalanche):大量 Key 被设置了相同的固定过期时间,某时刻集中失效,导致整个系统瘫痪。
- 解法:所有缓存实体的 TTL 必须施加 随机抖动因子(Jitter),例如
Base_TTL + Uniform(0, 300) 秒,实现平滑离散过期。
- 解法:所有缓存实体的 TTL 必须施加 随机抖动因子(Jitter),例如
2. 支付与交易系统的终极防线:幂等流水线
在涉及真实资金的交易场景中,网络抖动与客户端疯狂重试是日常常态。Shopify 在 system-design-101 中分享的支付弹性准则指出:分布式系统的网络调用只有三种结果:成功、失败、以及未知的超时(Timeout)。
sequenceDiagram
    autonumber
    actor User as 用户客户端
    participant Gateway as API 网关
    participant PayService as 支付核心系统
    participant DB as "分布式账本数据库 (ACID)"
    participant PSP as "银行/三方支付网关 (Stripe/PayPal)"

    User->>Gateway: POST /pay (携带客户端唯一生成的 Idempotency-Key: uuid-v4)
    Gateway->>PayService: 路由支付请求
    PayService->>DB: 开启事务: INSERT INTO payment_records (idempotency_key, status='PENDING')
    alt 插入成功 (首次请求)
        DB-->>PayService: 插入成功
        PayService->>PSP: 发起真实扣款 API (透传相同 Idempotency-Key)
        PSP-->>PayService: 扣款成功 (Transaction ID)
        PayService->>DB: UPDATE payment_records SET status='SUCCESS', psp_tid=...
        PayService-->>User: 扣款成功凭证
    else 唯一键冲突 (重复提交/网络超时重试)
        DB-->>PayService: 主键冲突 DuplicateKeyException
        PayService->>DB: SELECT * FROM payment_records WHERE idempotency_key=...
        DB-->>PayService: 返回当前处理中的状态 (PENDING 或 SUCCESS)
        PayService-->>User: 直接返回幂等结果,绝不发起二次扣款!
    end
关键设计准则:
- 客户端主导的幂等键(Client-generated Idempotency Key):表单在渲染时即嵌入全局唯一 UUID,无论用户因超时点击重试多少次,HTTP Header 必须携带同一个 Key;
- 数据库唯一性约束(Unique Constraint)作为第一道防线:在订单表或支付凭证表将该 Key 设为唯一索引,利用底层数据库的原子唯一性判定彻底阻断并发双发;
- 透传外部通道:调用银行或三方支付网关时,必须将该幂等标识作为请求参数原样向下游透传,形成端到端的幂等保护链路。
五、 顶尖科技巨头的真实架构演进实录
技术不是孤立存在的,脱离业务场景谈架构毫无意义。system-design-101 梳理的几个代表性工业案例,展现了世界级团队如何通过架构重构支撑万倍业务增长:
flowchart TD
    subgraph Figma ["Figma: 100x Postgres 扩展演进"]
        F1["垂直单库极限"] --> F2["逻辑只读副本分流"]
        F2 --> F3["水平分区分表 (Partitioning)"]
        F3 --> F4["分布式连接代理池"]
    end
    subgraph Netflix ["Netflix: 全球多活高可用演进"]
        N1["单体 Monolith 拆解"] --> N2["Eureka 注册发现"]
        N2 --> N3["Zuul/Envoy 智能网关"]
        N3 --> N4["全球多可用区 Active-Active 容灾"]
    end
    subgraph Uber ["Uber: 派单与调度系统演进"]
        U1["早期 Python 单体"] --> U2["H3 地理六边形分片"]
        U2 --> U3["Ringpop 事件网络"]
        U3 --> U4["自研微服务服务编排"]
    end
1. Figma 的 100 倍 PostgreSQL 扩展奇迹
作为协同设计领域的独角兽,Figma 没有盲目追逐新潮的 NoSQL,而是将经典的 PostgreSQL 发挥到了极致:
- 垂直拆库(Vertical Partitioning):按业务领域将用户表、文件元数据、协同画布数据物理隔离;
- 动态只读分流(Read Replicas Routing):基于读写比例构建只读从库集群,由应用层中间件自动路由读请求;
- 水平拆表(Horizontal Sharding):自研轻量级分片代理,针对单个巨大文件使用分片算法分发,硬生生在单引擎上抗住了数十倍的用户暴增。
2. Netflix 的全球多活与推流架构
Netflix 处理着全美超过 15% 的互联网下行流量:
- Open Connect CDN 专用硬件部署:直接将自研缓存服务器物理插入全球 ISP 的机房内部,95% 以上的高清视频流量无需经过公网骨干网络;
- 混沌工程(Chaos Engineering):在生产环境中运行 Chaos Monkey 随机杀掉可用区实例,通过强制性的容灾演练,逼迫所有微服务实现无状态(Stateless)设计与自动重试降级。
六、 架构师的工程心智法则
通读 ByteByteGoHq/system-design-101 的数百篇架构图解与案例,在我看来,每一位系统工程师都应沉淀三条极其深刻的现实法则:
- 没有银弹,只有适配当前场景的权衡(Every Design is a Trade-off):
在微服务、分布式存储、最终一致性与强一致性之间,每一次技术选型都是在拿“复杂度”兑换“某种维度的能力”。如果一个单体应用每秒只有几百 QPS,盲目引入 Kafka、SAGA 事务与服务网格只会给团队带来灾难性的技术负债。 - 可观测性不是辅助工具,而是系统架构的第一等公民:
一个无法被监控、缺乏分布式全链路追踪(Tracing,如 OpenTelemetry)与指标聚合(Prometheus)的系统,根本谈不上高可用。只有当系统故障可以在秒级被定位与止血时,架构才真正具备韧性。 - 向下扎根底层的物理现实:
无论上层的无服务器架构(Serverless)或 AI 智能体编排多么梦幻,底层的物理定律从未动摇——网络包传输受光速约束、内存寻道远快于磁盘 I/O、分布式网络必定会发生分区(Partition)。深刻理解 Linux 内核 I/O、TCP 滑动窗口、内存屏障与存储物理介质,才是驾驭复杂分布式系统的真正定海神针。
相关链接与参考资料:
- 官方开源仓库:ByteByteGoHq/system-design-101
- ByteByteGo 架构官方平台:ByteByteGo: Explain Complex Systems with Visuals
- 官方技术专栏(Substack):ByteByteGo Newsletter
- YouTube 架构可视化频道:ByteByteGo Official Channel