
代码能跑不等于合规:基于新加坡 AI Verify 11 原则构建企业内部 AI 安全编码与治理闭环
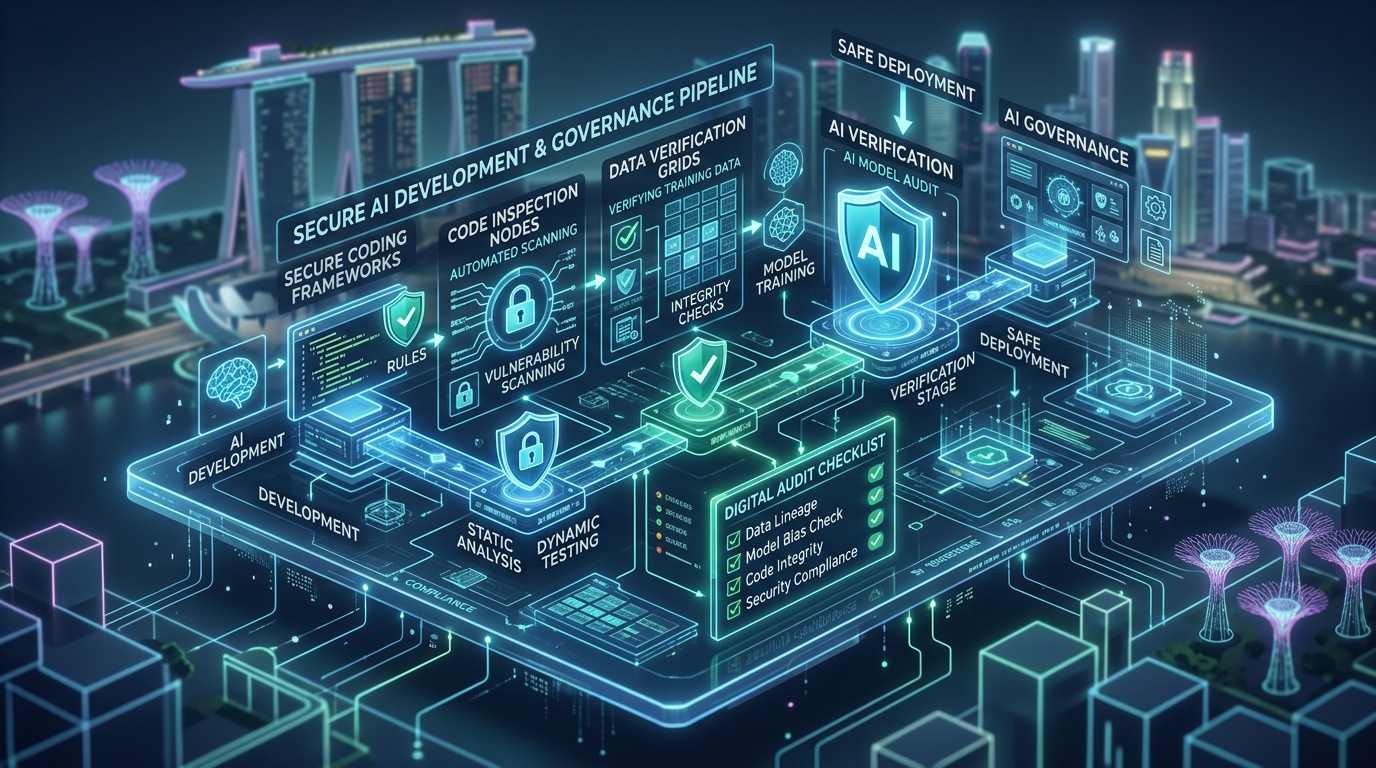
随着生成式 AI 和各类编程智能体(Coding Agents)全面渗透研发流水线,工程团队的代码产出速度被提升到了前所未有的量级。然而,在“代码能运行、测试用例通过、API 返回 200 OK”的繁荣表象之下,AI 辅助编程正悄然将企业推向巨大的合规与安全黑洞——AI 不懂商业机密边界,更无法对真实世界的隐私侵害承担法律责任。
当代码运行逻辑从传统的确定性编写转向概率性生成,企业如何保证交付的软件不仅“功能正确”,而且“合规可控”?由新加坡资讯通信媒体发展局(IMDA)与个人资料保护委员会(PDPC)联合推出的 AI Verify 治理框架,为技术组织提供了一套将抽象的伦理原则转化为严密工程防线的工业级参考范式。本文将结合新加坡最新的合规实践与真实踩坑案例,深度拆解如何以 AI Verify 11 项原则为基线,构建企业内部的 AI 安全编码闭环。
一、AI 时代的“皇帝新衣”:当代码可运行遭遇语义合规黑洞
在传统软件工程中,质量保障体系通常由单元测试、集成测试、代码静态扫描(Lint / SonarQube)与自动化 CI/CD 管线构成。如果所有自动化测试亮起绿灯且代码顺利部署,工程师通常会认定该功能交付达标。
然而,在 AI 辅助编程时代,这种传统的工程直觉正在失效。
最典型的现实警钟莫过于新加坡知名老字号食品企业美珍香(Bee Cheng Hiang)的客户数据泄露事件。开发团队借助 AI 工具生成调用 Twilio SendGrid 接口的群发营销邮件脚本,脚本语法完全合法、逻辑运行毫无报错,在生产环境成功向 95,000 多名客户发送了邮件。但由于 AI 生成的数据结构在 personalizations 字段中将本应隔离的收件人数组嵌套包裹在了同一个批次对象内,导致所有收件人的邮箱地址直接暴露在每封邮件的 To 标头中,最终被新加坡个人资料保护委员会(PDPC)立案调查并责令整改。
这个案例刺破了 AI 研发的“皇帝新衣”:代码在语法与执行层面 100% 成功,但在业务与语义合规层面却是 100% 的灾难。
传统软件思维:输入合法 → 执行无报错 → 响应 200 OK = 功能交付成功
AI 治理思维:代码可运行 ≠ 语义合规 ≠ 隐私安全 ≠ 免除法律问责
AI 不具备人类对业务上下文、数据主权、隐私敏感度的内在敬畏。如果企业仅仅把 AI 视作单纯的代码生成加速器,而没有建立相应的治理围栏,那么产研团队实际上是在用“十倍速生成未经审查的潜在法律负债”。
二、解构 AI Verify:它到底是什么,不是什么?
新加坡 AI Verify 框架最初由 IMDA 和 PDPC 于 2022 年联合发起,随后设立了由全球科技领袖与行业先驱组成的 AI Verify Foundation(包括红帽、谷歌、IBM、微软等)。
理解 AI Verify 的首要前提,是厘清它的能力边界与设计哲学:
flowchart LR
    A["治理原则 (Principles)"] --> B["预期结果 (Outcomes)"]
    B --> C["执行流程 (Processes)"]
    C --> D["审计证据 (Audit Evidence)"]
1. 它不是什么
- 它不是一张“免责安全许可证”:没有任何第三方机构或工具能给企业的 AI 系统颁发一张盖章即可免除监管责任的“绝对免罪金牌”。
- 它不是传统安全审查的替代品:它绝不能取代现有的代码安全审计(Code Review)、黑盒/白盒渗透测试(Pentest)、威胁建模或基础设施访问控制。
- 它不是单纯的口头伦理声明:它严厉排斥泛泛而谈的道德修辞,所有原则必须落地为可执行的工程动作与不可篡改的过程证据。
2. 它到底是什么
AI Verify 是一套将负责任 AI(Responsible AI)的抽象原则转化为可测量指标、可验证流程与可审计证据的结构化治理体系。
在企业内部研发场景中,内部 AI 治理与安全编码体系的本质定义可以概括为:
以 AI Verify 11 项原则为合规基准线,把 AI 工具准入、用例登记、敏感数据分类、代码生成控制、自动化断言测试、独立人工复核、上线双人审批、运行态监控与事故应急响应无缝缝合的企业安全工程闭环。
三、AI Verify 11 项原则与安全编码工程落地点
新加坡 AI Verify 将 AI 系统的风险划分为 11 项核心原则。下表详细剖析了每一项原则在企业内部研发与安全编码场景中的“治理追问”与“工程落地解法”:
| 编号 | 核心原则 | 企业内部治理核心追问 | 安全编码与架构工程落地点 |
|---|---|---|---|
| 01 | Transparency 透明度 | 开发者、代码审查人与受影响用户是否知悉 AI 在系统中的参与程度与范围? | 建立 AI 资产台账;在代码提交记录(Git Commit)、PR 描述及系统清单中强制显式标记 AI 工具、版本、生成范围与局限性说明。 |
| 02 | Explainability 可解释性 | 团队能否清晰解释 AI 生成的架构或代码为何产生当前结果?是否知晓其底层逻辑? | 维护完备的系统架构说明、数据流向拓扑图(DFD);强制要求 AI 生成的关键数据结构或算法附带语义注释与设计决策推导。 |
| 03 | Repeatability / Reproducibility 可重复性 | 在相同环境与约束下,系统构建、代码生成和测试表现能否稳定复现? | 固化基础大模型版本、系统级 Prompt、外部三方依赖锁版本;测试环境使用固定的基准脱敏数据集与确定性的流水线配置。 |
| 04 | Safety 系统安全性 | 系统是否可能因逻辑异常或意外行为对个人、组织或物理世界造成直接或间接伤害? | 编写强制性负面测试用例;对数据外发设置严格硬限流(Rate Limiting);部署生产一键紧急熔断与无损回滚机制(Kill Switch)。 |
| 05 | Security 安全防护 | 系统是否能有效抵御越权访问、数据泄露、提示词注入、恶意篡改与破坏? | 生产与测试环境强隔离;实行最小权限原则与 API Key 凭证自动化轮换;部署防数据泄露引擎(DLP)与静态/动态安全扫描。 |
| 06 | Robustness 鲁棒性与韧性 | 面对异常输入、极端边界场景或恶意畸形载荷,系统是否会发生危险崩溃或降级? | 全面覆盖边界测试(边界值 ±1)、故障注入(Chaos Testing);在代码中植入运行时安全不变式断言(Safety Assertions)。 |
| 07 | Fairness 公平性 | AI 系统产出的逻辑或模型决策是否对特定群体或个体构成不合理歧视? | 审查训练/推理上下文中的偏见;在涉及推荐、授信、用户分群等业务场景中设立防偏离偏差基准测试。 |
| 08 | Data Governance 数据治理 | 代码生成与系统运行过程中的数据来源、敏感分级、调用权限与存储留存是否可控? | 强制执行敏感数据严禁输入未授权 AI;测试用例全部使用 Faker 合成数据;制定端到端的数据生命周期留存与自动擦除策略。 |
| 09 | Accountability 问责机制 | 谁最终对 AI 系统的功能缺陷、数据外泄或合规失败承担第一法律责任? | 确立“人负最终责任”铁律;指定系统业务负责人、DPO(数据保护官)、代码独立复核人与生产发布审批人,消除权责真空。 |
| 10 | Human Agency & Oversight 人类监督 | 在全自动化的系统流转中,人类是否始终保留最终的知情、干预、纠错与接管权? | 严禁 AI 自动化端到端无人发版;关键敏感行为执行双人人工复核审批(Dual Sign-off);保留人工干预与应急降级通路。 |
| 11 | Societal Well-being 社会与环境福祉 | AI 系统的长期运行是否会引发社会信任危机、不当资源耗尽或公关合规风险? | 全面开展业务影响评估(BIA);优化推理计算开销与碳足迹;在发生数据意外时第一时间履行监管通报与用户保护承诺。 |
四、透视美珍香案:11 项原则视角下的失控切片与工程对照
回到美珍香的真实案例,若我们将发生泄露的代码置于 AI Verify 的 11 项原则显微镜下,其失控的链条便一目了然:
flowchart TD
    subgraph 灾难链路
        A1["开发者使用 AI 生成 SendGrid 脚本"] --> A2["缺乏数据隔离断言(鲁棒性缺失)"]
        A2 --> A3["直接接入真实会员数据(数据治理缺失)"]
        A3 --> A4["单人提交并直接触发生产推送(人类监督与问责缺失)"]
        A4 --> A5["9.5 万名客户邮箱在 To 标头完全暴露(安全性与防护击穿)"]
    end
1. 代码缺陷的底层语义对照
在调用第三方邮件服务提供商(SendGrid)的 API 时,AI 给出了如下格式的 Python 代码:
# ❌ 错误示范:AI 生成的代码(灾难版本)
# 列表推导式被放在了单个 personalizations 字典内部
# 这意味着:创建了一个包含 N 个客户邮箱的单个邮件投递任务
# 结果:所有收件人出现在同一封邮件的 To 字段,互相完全可见!
payload = {
    "personalizations": [
        {
            "to": [{"email": str(e)} for e in chunk]
        }
    ]
}
而符合隐私隔离规范的标准代码应该是:
# ✅ 正确示范:严格隔离收件人作用域
# 列表推导式放在外层,为切片内的每一个客户独立生成一个单独的 personalization 对象
# 结果:SendGrid 底层执行独立投递,每位客户只能看到自己的名字与邮箱
payload = {
    "personalizations": [
        {
            "to": [{"email": str(e)}]} for e in chunk
    ]
}
2. AI Verify 维度的失陷与修复对照
下表清晰地展示了该事件在 AI Verify 原则下的全面复盘与补救措施:
| AI Verify 原则 | 美珍香事件中暴露的失控盲区 | 现代化研发体系必须构建的防御措施 |
|---|---|---|
| 透明度 (Transparency) | 团队内部没有任何记录证明这段逻辑是由 AI 工具生成的,排查时难以溯源。 | 在 Git Commit 和 PR 模板中引入 AI-Assisted: true 标记,留存生成时的 Prompt 与原始响应。 |
| 可解释性 (Explainability) | 研发人员仅看了代码能把请求发出去,未深入理解第三方 API 关键字段的数据结构语义。 | 建立核心外部接口数据字典与架构审查规范,严禁在不了解 SDK / API 语义的前提下直接采用 AI 建议。 |
| 鲁棒性 (Robustness) | 代码缺乏防御性编程意识,没有对批处理对象的内部元素数量施加断言。 | 在业务执行前注入防御性代码断言:assert all(len(p['to']) == 1 for p in personalizations)。 |
| 数据治理 (Data Governance) | 开发和自测阶段缺乏隔离,直接调用了包含真实客户个人资料的生产列表。 | 设立严格的环境边界,测试与沙盒环境全面推行脱敏数据与虚拟 Faker 邮箱体系。 |
| 人类监督 (Human Oversight) | 自动化脚本由单名研发人员独立编写并触发,缺乏第二双眼睛与生产红线拦截。 | 推行双人审批机制(Four-eyes Principle);引入外部邮件网关出向 DLP 策略。 |
| 问责机制 (Accountability) | 事故初期责任归咎于“AI 工具生成的代码有问题”,忽视了企业自身作为数据控制者的主体地位。 | 建立明确的角色矩阵:明确业务负责人、系统责任人、代码审查人与 DPO 的权责清单。 |
五、企业级 AI 安全开发生命周期(AI-Secure SDLC)工程蓝图
将 AI Verify 原则落地到日常研发流程,不能靠工程师的道德自觉,而必须将其焊进 CI/CD 流水线与研发治理制度。企业应推进如下标准化的 AI 安全开发生命周期(AI-Secure SDLC):
flowchart TD
    A["1. AI 用例登记与敏感度分级"] --> B["2. 数据分类与隐私影响评估 (DPIA)"]
    B --> C["3. 选择企业白名单批准的 AI 工具/模型"]
    C --> D["4. 使用脱敏/合成数据生成代码"]
    D --> E["5. 静态分析 (SAST) 与依赖软件供应链扫描"]
    E --> F["6. 独立技术与隐私架构审查 (Code Review)"]
    F --> G["7. 沙盒隔离端到端负面与边界测试"]
    G --> H["8. 双人审批与小流量金丝雀灰度"]
    H --> I["9. 生产发布、实时监控与熔断机制"]
    I --> J["10. 事故应急预案、证据链归档与复盘"]
1. 需求与设计阶段:明确安全不变量(Security Invariants)
在需求提出阶段,架构师与业务分析师必须把“安全不变量”写入需求文档。例如,在营销邮件场景中,业务需求绝对不能简略写成“支持批量群发营销邮件”,而必须强制注明:
【安全不变量】
每一位外部收件人接收到的邮件中,To、Cc、Bcc 字段必须且仅能出现收件人自身的邮箱地址,
绝对严禁将多个不同收件人的信息合并在同一可见字段中。
2. 代码生成阶段:建立零信任提示词与隔离防线
企业应明确规定:将任何由 AI 工具生成的代码视同为不可信的第三方代码(Untrusted Third-party Code)。
- 严禁投喂真实生产数据:在 Prompt 编写过程中,严禁附带客户姓名、身份证号、企业 API 密钥、数据库连接字符串等高危资产。
- 显式注入安全约束指令:在给 AI 提示词时,要求其遵循安全编码范式。例如要求其编写具备单元测试、边界值检查和防御性断言的代码。
3. 自动化测试与运行时断言工程
为了杜绝类似美珍香案的语义结构错误,研发团队必须在代码中写入强力的运行时检查,并在 CI/CD 中覆盖完备的负面测试用例。
(1) Python 代码层防御性断言范例
from typing import List, Dict, Any

def validate_email_personalizations(personalizations: List[Dict[str, Any]]) -> None:
    """
    针对第三方邮件推送载荷执行硬性安全合规断言检查。
    一旦发现违背数据隔离原则的数据结构,立即抛出异常阻断执行。
    """
    for index, p in enumerate(personalizations):
        # 1. 验证每个投递单元中,To 字段必须存在且长度严格等于 1
        to_recipients = p.get("to", [])
        if not isinstance(to_recipients, list) or len(to_recipients) != 1:
            raise SecurityComplianceError(
                f"安全阻断:第 {index} 个 Personalization 单元的 To 收件人数量异常 "
                f"(当前数量: {len(to_recipients)}),必须严格等于 1!"
            )

        # 2. 严禁在批量推广场景中意外包含共享的 Cc 或 Bcc 造成连带泄露
        if "cc" in p and p["cc"]:
            raise SecurityComplianceError(f"安全阻断:第 {index} 个投递单元检测到未授权的 Cc 抄送!")
        if "bcc" in p and p["bcc"]:
            raise SecurityComplianceError(f"安全阻断:第 {index} 个投递单元检测到未授权的 Bcc 密送!")

    # 3. 确保批次内收件人无重复
    all_emails = [p["to"][0]["email"].strip().lower() for p in personalizations]
    if len(all_emails) != len(set(all_emails)):
        raise SecurityComplianceError("安全警告:批次中检测到重复的收件人邮箱,可能引发重复投递!")
(2) 出向邮件网关防御规则(DLP)
除了代码内部的断言,企业在网络层与邮件网关层也必须部署出向流量监控规则:
- 单封外发收件人阈值拦截:外部群发邮件网关若检测到单封邮件的
To标头中包含超过 1 个外部邮箱地址,一律直接挂起阻断并触发告警。 - 单次突发流量异常熔断:单日或单小时内外部 API 调用的数量若出现阶跃式暴增(如超过历史均值 300%),自动降级进入人工审批队列。
六、中小企业开箱即用:最小可行落地基线(MVB)与审计清单
许多中小型团队常有一种误解,认为构建完整的 AI 治理体系需要巨大的法务与安全团队投入。实际上,借助以下精简后的“最小可行落地基线(Minimal Viable Baseline, MVB)十条铁律”,团队完全可以在数日内构建起基础免疫力:
1. 内部 AI 治理 10 条硬规则
- AI 工具白名单准入:仅允许员工使用经过安全与法务评估的企业级 AI 账号,严禁使用未授权个人版工具处理公司业务。
- 敏感个人资料绝对熔断:全员推行安全红线,严禁将生产数据库 Dump、客户名单、身份凭据粘贴进任何 AI 输入框。
- AI 生成代码视同不可信:所有用于生产环境的 AI 代码,必须由具备足够资历的人类工程师逐行 Review 并签署责任。
- 测试环境全面去真实化:自测与集成测试必须且只能使用脱敏数据或纯 Faker 生成的假数据。
- 核心边界植入自动化断言:在涉及外部通信、数据导出、权限鉴权的模块中,强制编写防御性不变量断言。
- 高危动作执行双人审批:生产环境批量发信、全量数据推送、核心模型配置变更必须通过双人人工审批确认。
- 保留一键物理熔断开关:任何自动化任务执行通道,必须配备可以随时在后台一键终止的紧急中断开关(Kill Switch)。
- 保留完整的版本与审计凭证:记录 AI 参与系统研发的 Prompt、模型版本、审查意见与发布审批记录。
- 上线后建立外向流量异常监控:对生产环境数据外发行为(邮件、短信、Webhook)部署异常峰值监控。
- 常态化演练安全事故预案:建立清晰的数据泄露上报与外部通报机制,明确事故第一责任人与 DPO 职责。
2. 企业内部 AI 研发安全自查清单(Checklist)
组织可以打印以下清单,在每一个迭代发版前进行对照打钩自检:
### 一、治理与准入 (Governance)
- [ ] 团队是否具备正式发布的《企业内部生成式 AI 使用政策》?
- [ ] 当前项目使用的 AI 工具与模型版本是否位于企业批准白名单内?
- [ ] 是否已为该系统指定明确的业务负责人(Owner)与代码审查人?
- [ ] 该 AI 辅助功能是否已在企业 AI 用例台账中完成登记?

### 二、数据与隐私控制 (Data & Privacy)
- [ ] 是否已梳理该功能的数据流向,并绘制了完整的数据流拓扑图?
- [ ] 是否确保在 AI 生成代码及调试过程中没有任何真实个人信息进入?
- [ ] 测试用例是否 100% 采用虚构合成数据(Synthetic Data)?
- [ ] 针对敏感数据读取,是否遵循最小可用权限(Least Privilege)原则?

### 三、代码构建与验证 (Code & Testing)
- [ ] AI 生成的关键函数与数据结构是否附带清晰的业务逻辑与注释?
- [ ] 是否在核心数据组装位置编写了防御性断言与运行时检查?
- [ ] 自动化测试集是否覆盖了空边界、单用户、超大批次、超时等负面异常场景?
- [ ] 是否执行了独立的人工代码走查(Independent Code Review)?
- [ ] 是否在沙盒环境中实际检查了最终输出的真实业务载荷(如测试邮件头)?

### 四、发布与运行时监控 (Release & Operation)
- [ ] 进入生产发布前,是否已获得至少两名有权人员的独立审批?
- [ ] 生产环境是否已具备小流量金丝雀灰度验证机制?
- [ ] 系统是否保留一键紧急停止(Kill Switch)与快速回滚能力?
- [ ] 外部通信与数据外发渠道是否已配置速率上限与 DLP 规则?
- [ ] 是否建立了完备的故障通报与事故应急响应流程?
七、写在最后:从追逐速度到敬畏边界
新加坡 AI Verify 框架给全球技术行业带来的最大启示在于:它将“负责任 AI”从空洞的哲学道德探讨,拉回到了严谨的现代软件工程实践。
AI 时代的软件开发,竞争的不仅是谁能用 AI 写代码写得更快,更是谁能建立一套韧性更强、合规更严密的安全编码护城河。AI 生成的代码越快,企业就越需要给流水线装上坚固的刹车和转向系统。
美珍香的教训证明,技术团队绝不能躲在“这是 AI 写的”借口之后。在法律与监管的标尺面前,企业永远是自身产品与客户数据的最终守护者。把 AI Verify 的 11 项原则焊进每一次代码提交、每一次断言测试与每一次发布审批中,才是每一家拥抱 AI 变革的现代企业应有的清醒与担当。
原文链接与参考资料
- 新加坡 AI Verify 基金会与测试框架:AI Verify Foundation - Testing Framework
- 新加坡个人资料保护委员会(PDPC) :Singapore’s Approach to Model AI Governance Framework
- 新加坡资讯通信媒体发展局(IMDA) :Artificial Intelligence in Singapore
- AI Verify 官方示例审计报告:AI Verify Sample Testing & Assessment Report (PDF)
- PDPC 美珍香案件自愿承诺书:Voluntary Undertaking by Bee Cheng Hiang Marketing Pte Ltd
- Twilio SendGrid API 文档:Personalizations in SendGrid v3 Mail Send