
它连字都不会写,凭什么重构 Computer Use?Jev 毫秒级单选题与 WebMCP 协同真相
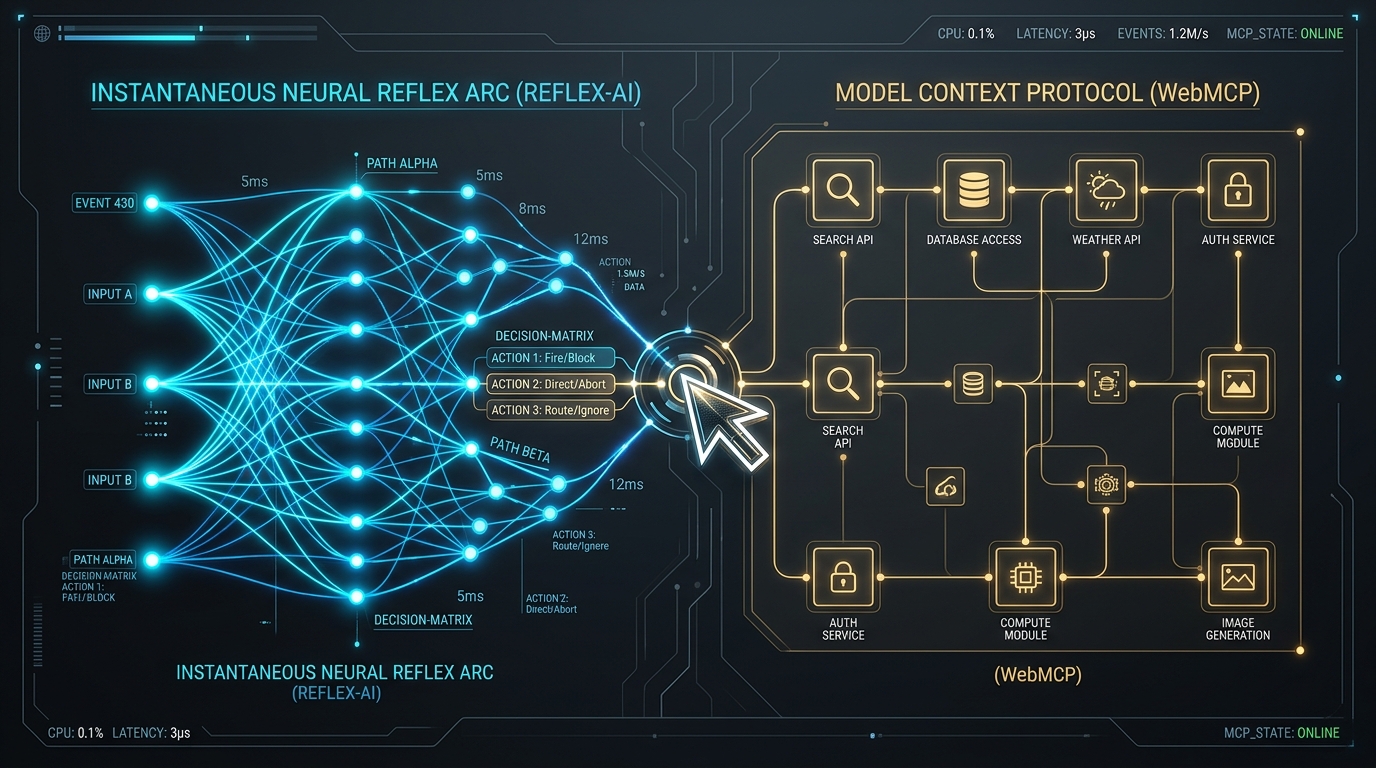
拿到 TypeSafe AI 开放内测的决策模型 Jev 之后,很多习惯了 ChatGPT 和 Claude 的开发者第一反应往往是困惑:它甚至连一段通顺的文字都不会写,无法生成任意字符串,怎么能被称为“操控电脑的神器”?然而,当它被接入浏览器与桌面自动化管线时,开源社区却集体炸开了锅——订机票 7 秒搞定、界面单步决策仅需 90 毫秒、单次任务模型成本骤降至 0.001 美元。
在过去很长一段时间里,让自回归大模型操作电脑宛如看一场 2 FPS 的慢速 PPT:每点一次鼠标,都要等千亿参数模型慢悠悠“写一篇小论文”。为什么一个只会做“单选题”的模型能将传统截图式 Computer Use 彻底干趴?当它与 WebMCP 结合时,为何能将基准评测成功率直接拉满到 100%,并将运行成本狂砍 112 倍?本文将为你深度拆解这场正在颠覆智能体底层逻辑的“分流革命”。
一、 传统 Computer Use 的 PPT 噩梦:请“老教授”点鼠标的系统性灾难
过去两年,无论 Anthropic 发布的 Computer Use 接口,还是基于 GPT-4o 或 GPT-6 Astra 的各类自主浏览智能体,在实际落地中都面临着令开发者抓狂的“三大死穴”:奇慢无比的响应时延、令人肉疼的 Token 账单,以及极易失控的误差累积。
sequenceDiagram
    autonumber
    actor User as 用户 ("帮我查周五去旧金山的航班")
    participant Screen as 桌面/浏览器环境
    participant Vision as 视觉编码模块
    participant LLM as 通用多模态大模型 (System 2)
    participant Act as 键鼠执行驱动

    loop 传统截图式循环 (单步耗时 3~8 秒,费用昂贵)
        Screen->>Vision: 截取高分辨率全屏图像 (1080P/4K)
        Vision->>LLM: 灌入数千图像 Token + 历史长上下文
        Note over LLM: 缓慢自回归推理 (CoT):<br/>"观察到页面加载完毕...<br/>我准备点击左上角搜索框..."
        LLM-->>Act: 吐出长文本与坐标 JSON {"action": "click", "x": 420, "y": 180}
        Act->>Screen: 移动鼠标并点击
    end
    Note over Screen: 订一张机票需重复 30~50 次,耗时数分钟,花费数美元
1. 时延雪崩:每点一下鼠标都在“写小论文”
在传统的自回归大模型范式下,智能体每迈出一步,都需要经历完整的“截屏 → 图像分块编码 → 唤醒千亿级大模型 → 输出长串思维链(CoT)推理 → 格式化吐出坐标 JSON → 驱动点击”的繁重链路。
即便模型输出的内容仅仅是点击一个“下一步”按钮,它也必须在后台把整个上下文重新自回归计算一遍。单次操作耗时动辄 3 到 8 秒,点完一份外卖需要经历几十次点击,整个操作过程如同播放幻灯片般一卡一卡。
2. 成本黑洞:高射炮打蚊子的账单代价
每一次全分辨率截屏都会产生 1,500 到 3,000 个 Vision Token。叠加数十轮历史交互记录后,上下文窗口迅速膨胀至数万甚至数十万 Token。
仅仅为了定位一个“提交”按钮,系统就要为数百亿参数的密集网络买单。单次自动化任务的 API 成本往往高达 0.1 到 0.5 美元,商业落地的投资回报率(ROI)被彻底击穿。
3. 根源剖析:认知层级的严重错配
这在本质上犯了一个系统架构设计的大忌:强行调用人类大脑中最高阶的 “慢思考” (System 2) 去接管最机械、最条件反射的 “快思考” (System 1)。
这就好比请了一位顶尖大学终身教授来替你玩扫雷游戏:每移动一次鼠标,教授都要伏案写上一篇三页纸的论证报告;而现实操作中,我们需要的仅仅是门口保安伸手一指的 0.1 秒本能反应。
二、 Jev 的底层真相:连字都不会写的“单选题战神”
Jev 由前 OpenAI 资深研究员、RLHF(人类反馈强化学习)与 InstructGPT 核心发明人之一 Diogo Almeida 创立的 TypeSafe AI 研发推出。
与市面上所有自回归生成式模型不同,Jev 在设计之初就摒弃了“对话”、“写作”与“通用文本生成”的一切能力。
flowchart LR
    subgraph InputState["输入状态 (State)"]
        Task["当前业务目标"]
        Context["环境观测数据"]
        Candidates["离散候选操作空间<br/>[Option A, Option B, Option C, Option D]"]
    end

    subgraph JevCore["Jev 核心推理引擎 (非自回归)"]
        direction TB
        RLCD["RLCD 校准概率网络<br/>(单次前向传播)"]
        Timer["耗时: 70ms ~ 90ms"]
    end

    subgraph Output["强类型决断输出"]
        Choice["选择动作: Option B"]
        Confidence["校准置信度: 0.96"]
    end

    InputState --> JevCore
    JevCore --> Output
1. 纯粹的离散状态机分流器
Jev 的核心契约极其简单且克制:
- 输入:当前上下文描述 + 一组离散的候选动作列表(Options A、B、C、D……);
- 输出:在几十毫秒内直接输出命中选项的索引及其 校准置信度(Calibrated Confidence) ;
- 能力硬边界:它无法自由回答常识问题,无法写诗,无法在搜索框里凭空敲出一段复杂的长句。
它不是一个聊天机器人,而是一个硬件级吞吐的 离散决策路由器(Discrete Decision Router) 。
2. 为什么是 RLCD,而非 RLHF?
传统大模型普遍采用 RLHF(Reinforcement Learning from Human Feedback)。Diogo Almeida 深刻认识到,RLHF 优化的是“人类评判者的心理偏好”,这必然诱导模型产生以下两大致命暗疾:
- 阿谀奉承与过度自信:模型倾向于用极其笃定的语气给出错误答案,只为了听起来让评委信服;
- 长篇大论的表达欲:模型通过倾倒大量无关解释来展示思考深度,极难给出干脆利落的概率定界。
为了解决这一问题,TypeSafe AI 提出了 RLCD(Reinforcement Learning for Calibrated Decisions,校准决策强化学习) :
- 它不再奖励“讨人喜欢的解释”,而是严格奖励“置信度与真实命中率的统计对齐”;
- 当 Jev 输出 0.90 的置信度时,在数万次基准回放中,其决策的真实正确率就严丝合缝地落在 90%;
- 这种确定性让工业级工程代码能够设立明确的熔断策略:当置信度高于 0.85 时毫秒级直接放行执行;一旦置信度跌破阈值,才平滑上报给大模型或人工接管。
三、 开源社区的四种极速落地流派
在 Jev 开启内测后短短数天内,全球开源生态与独立开发者迅速探索出了四种极具颠覆性的工程应用范式:
flowchart TD
    subgraph S1["流派一: Sac 的 Mac 本地日历"]
        A1["系统 Accessibility 事件"] --> A2["Jev 毫秒级命中按键"] --> A3["丝滑无顿挫操作"]
    end

    subgraph S2["流派二: Browser Use 的 Ultrafast"]
        B1["DOM 控件抽取为表格"] --> B2["Jev 选按钮 + 小模型打字"] --> B3["7 秒搜完机票"]
    end

    subgraph S3["流派三: Milind Labs 的零像素外传"]
        C1["本机 CoreML 分割按钮"] --> C2["本地 OCR 提取文字"] --> C3["Jev 纯文本决策 (隐私零泄露)"]
    end

    subgraph S4["流派四: Stagehand 远程浏览器"]
        D1["提取 a11y 无障碍树"] --> D2["Jev 决策动作流"] --> D3["单任务成本 0.001 美元"]
    end
1. 中文博主 Sac 的「Jev Use」:消灭系统顿挫感
在日常办公中,“给 macOS 日历添加一条包含地点与提醒的日程”是典型的多步离散交互。
中文博主 Sac 使用 Codex 内置的 Computer Use 与基于 Jev 封装的「Jev Use」进行了同屏实机对比:
- Codex 原生:在每次点击下拉菜单、切换日期标签时都要停滞数秒,界面呈现肉眼可见的卡顿;
- Jev Use:整个添加过程行云流水,操作几乎无缝衔接,如同真人在使用物理快捷键;
- 最终评测显示,在完成相同交互精度的前提下,两者的 Token 消耗几乎持平,但执行时延被压低了一个数量级。
2. Browser Use 创始人 Gregor 的「Ultrafast」:7 秒订机票神话
开源浏览器自动化框架 Browser Use 的创始人 Gregor 展示了其基于 Jev 打造的 jev-ultrafast 引擎:
- 任务目标:打开预订网站,搜索特定日期的单程国际机票;
- 最终成绩:全程仅耗时 7 秒,端到端模型开销仅为 0.0039 美元!视频以 1 倍速实录,毫无快进痕迹;
- 协作逻辑:将视口内的 DOM 交互元素拍平成紧凑表格交由 Jev 选点;只有当光标移入文本框需要打字时,才唤醒极小的辅助语言模型快速填充文字。
3. Milind Labs 的隐私奇迹:不截屏、不读 DOM、零像素离机
在很多企业安全合规要求极高的金融与医疗场景中,主流多模态智能体因为需要频繁将桌面截图上传至云端而遭到全面禁用。
开发者 Milind 提出了一种颠覆性的完全本地化感知架构:
- 在本地 Mac 上运行轻量级 CoreML 模型,实时对当前屏幕画面的控件与按钮进行边界框(Bounding Box)分割;
- 利用 macOS 原生 OCR 引擎,只提取被识别区域的纯文本标签;
- 整个过程中,没有任何图像像素离开用户的本地电脑;
- 发送给 Jev 的仅为几个文字选项标签,Jev 以约 90 毫秒一次的超高频决策循环,驱动系统模拟点击,直至目标达成。
4. Browserbase / Stagehand:0.001 美元的远程浏览器执行
Kyle 将 Stagehand 自动化引擎与 Jev 进行深度整合:
- 观察远程无头浏览器页面,将当前 DOM 的可访问性树(Accessibility Tree)压缩为决策动作空间;
- Jev 毫秒级输出下一拍动作,由 Stagehand 原生协议立即执行;
- 单次复杂网页采集任务的综合执行成本被硬生生压缩至约 0.001 美元。
四、 为什么 WebMCP 才是真正绝杀?从 25/49 到 49/49 的质变跃迁
虽然 Jev 在执行点击操作时快如闪电,但在面对极其复杂的现代 Web 页面时,纯粹的“在原生 DOM 上点按钮”仍然存在先天局限。
Jev 本质上是一个离散分流器。面对充斥着横幅广告、弹窗遮罩、套娃 div 与动态渲染的混乱网页时,页面上往往散落着上百个无意义的超链接与按钮。在一个充满视觉垃圾的备选池里,即便是 90 毫秒的决策战神也难免点偏。
根据 0xidanlevin 在开源评测基准 WindTunnel 上的公开实测:
- 裸用 Jev 点击原生网页控件:在 49 个基准任务中仅成功完成了 25 项,成功率仅为 51%;
- 核心瓶颈在于:选出一个语法正确的按钮,并不等于选出了符合业务逻辑的正确下一步!
flowchart TD
    subgraph Dilemma["纯 DOM 控件点击的困境 (成功率: 25/49)"]
        RawWeb["混乱真实网页 (广告/Cookie弹窗/复杂嵌套div)"] --> ParseDOM["提取出 120 个可点击元素"]
        ParseDOM --> JevStruggle["Jev 从海量垃圾候选中盲选"]
        JevStruggle --> MissClick["容易点进广告、陷入分页死循环"]
    end

    subgraph Solution["Jev + WebMCP 绝杀范式 (成功率: 49/49, 满分通过)"]
        WebMCP["WebMCP 官方标准工具接口<br/>(1. search_products, 2. add_to_cart, 3. checkout)"]
        CleanOpts["干净明确的 3~5 个高阶动作候选"]

        JevChoice["1. Jev 秒选下一步工具<br/>(耗时 80ms, 解决『下一步干嘛』)"]
        MercuryGen["2. Mercury 2.5 填充参数<br/>(1000+ tok/s, 解决『搜索框填啥』)"]

        WebMCP --> CleanOpts
        CleanOpts --> JevChoice
        JevChoice --> MercuryGen
        MercuryGen --> NativeExec["网站原生无损执行 API"]
    end
1. 什么是 WebMCP:网站为 AI 开启的“快捷通道”
WebMCP(Web Model Context Protocol)是让网站主动向 AI 暴露结构化能力的协议。
网站不再强迫 AI 像人类那样用肉眼在像素堆里找按钮,而是像提供 OpenAPI 或快捷菜单一样,直接向智能体暴露强类型的语义工具:
- 工具 1:
search_products(query: string) - 工具 2:
add_to_cart(sku_id: string, count: number) - 工具 3:
proceed_to_checkout()
2. 震撼的 112 倍成本碾压:WindTunnel 基准成绩
当把 Jev 放到 WebMCP 搭建的清洁跑道上时,奇迹发生了:
| 架构评测组合 | 任务完成率 (Pass Rate) | 相对模型成本 (Cost Ratio) | 单步中位延迟 (Latency) |
|---|---|---|---|
| GPT-6 Astra (截图式 Computer Use) | 81.6% (40/49) | 245x 基准线 | 3.5s ~ 6.0s |
| GPT-6 Astra (代码执行版 Computer Use) | 89.8% (44/49) | 112x 基准线 | 2.0s ~ 4.5s |
| Jev 原生 (仅点击 DOM 按钮) | 51.0% (25/49) | 1.22x | ~90ms |
| Jev + Mercury 2.5 + WebMCP | 100.0% (49/49) | 1x(降维暴击) | ~120ms |
[!NOTE]
在 WindTunnel 基准测试中, Jev + WebMCP 达成了 49/49 满分通关 !
其综合模型成本不仅比 Jev 纯点 DOM 又降了 18%,更直接比 GPT-6 Astra 的代码执行 Computer Use 暴降 112 倍 ,比 Astra 的截图版 Computer Use 狂砍 245 倍 !
3. “三权分立”的极速协同流水线
这套方案之所以能实现性能与成本的双重奇迹,源于其近乎完美的架构分工:
flowchart TD
    subgraph Pipeline["三权分立协同流水线"]
        direction LR

        subgraph JevBox["1. 动作决断中枢 (System 1)"]
            direction TB
            J1["Jev 决策引擎"]
            J2["• 职责: 动作选拔与路由<br/>• 输入: 目标 + WebMCP 工具列表<br/>• 产出: 目标工具名称 (如 search_products)<br/>• 延迟: ~90ms 毫秒级反射"]
        end

        subgraph MercuryBox["2. 参数填补员 (System 2 Lite)"]
            direction TB
            M1["Mercury 2.5 极速小模型"]
            M2["• 职责: 细粒度参数构造<br/>• 产出: query='降噪耳机', brand='Sony'<br/>• 特性: 1000+ tok/s,成本极低"]
        end

        subgraph WebMCPBox["3. 接口契约层 (WebMCP)"]
            direction TB
            W1["WebMCP 官方标准接口"]
            W2["• 职责: 消除 DOM 乱象与广告噪音<br/>• 将繁琐点击压缩为原子 API<br/>• 执行: 浏览器原生直接调用"]
        end
    end

    JevBox -->|"① 选定下一步工具"| WebMCPBox
    MercuryBox -->|"② 填充调用参数"| WebMCPBox
    WebMCPBox -->|"③ 执行结构化交互"| Browser["原生浏览器 / 业务后端"]
在现实自动化任务中,最耗费心智的核心矛盾永远是“下一步究竟该执行什么业务动作”,而不是“在搜索框里输入哪几个字”。
- Jev 专注定方向:在清晰的 WebMCP 接口列表中,以 90 毫秒的置信度瞬间选定调用
search_products; - Mercury 2.5 专注填参数:调用每秒输出 1,000+ Token 的廉价超小模型,只负责把用户意图翻译为
{"query": "Sony WH-1000XM5"},耗时仅几十毫秒; - WebMCP 消除所有视觉噪点:原本需要点击 6 次、耗时半分钟的页面跳转交互,被浓缩为一次直接的工具调用。
正如 Idan 所言:Jev 最生猛的舞台,从来不是去混乱的公网网页里当“扒网页的苦力”,而是在已经整理清晰的工具菜单里当“毫秒级选拔裁判”。
五、 认知升维:未来的 AI 不是全能天才,而是流水线军团
在过去几年的生成式 AI 狂潮中,行业存在一种普遍的“单体模型迷信(Monolithic Fallacy)”——人们习惯性地期盼一个无所不知、无所不能的超级模型,既能帮我们构思长篇小说,又能帮我们检查网页拼写,还能替我们每秒点三次鼠标。
然而,计算机工程发展的客观规律一次次证明:分层解耦与专用化,才是通往工业级可靠性的唯一物理定律。
flowchart TD
    subgraph FuturePipeline["未来 AI 生产流水线架构"]
        direction TB
        Genius["👑 规划大脑 (System 2: 旗舰 LLM / 慢思考)<br/>负责分解宏观目标、多步骤推演、复杂异常裁决"]

        subgraph Reflex["⚡ 极速反射中枢 (System 1: Jev / 非自回归)"]
            J1["状态分类"]
            J2["工具路由"]
            J3["置信度过滤"]
        end

        subgraph Protocol["🔌 标准交互基建 (WebMCP / MCP / OS Accessibility)"]
            P1["结构化工具暴露"]
            P2["业务状态抽象"]
        end

        subgraph Hands["🦾 物理执行机 (Native Driver / Playwright / Stagehand)"]
            H1["本地键鼠触发"]
            H2["API 数据上报"]
        end

        Genius -->|制定宏观路线图| Reflex
        Reflex -->|毫秒级高频选拔| Protocol
        Protocol -->|无歧义指令交付| Hands
        Hands -.->|遇到未知环境异常/置信度熔断| Genius
    end
未来的智能体协作网络,绝不会由一个高高在上的通用单体模型包打天下,而是会分化为一支各司其职的精密工兵连:
- 战略大脑 (System 2):旗舰自回归大模型负责定义业务目标、分解宏观战略、在发生非预期灾难时重新规划;
- 反射神经 (System 1):像 Jev 这样的非自回归决策引擎,在 90 毫秒内不知疲倦地完成成千上万次高频微决断;
- 参数填补员 (System 2 Lite):超高速轻量模型以极高吞吐负责局部字符串拼接;
- 标准界面 (WebMCP / MCP):数字世界的基础设施主动拥抱标准化,消除多模态像素感知的一切冗余与偶然。
六、 总结与工程师行动建议
当我们在谈论 Computer Use 时,很多人以为核心是“教会大模型看懂屏幕上的像素”。
但 Jev 和 WebMCP 用最硬核的基准数据给出了另一种截然不同的答案:最优雅的自动化,是彻底消灭那些本就不必要的像素等待。
如果你正在构建或优化自己的智能体应用,不妨尝试落地以下三条重构原则:
- 剥离所有微决策:审查你的 Agent 循环,把所有分支判断、分类筛选、工具路由从千亿大模型中剥离出来,交给像 Jev 这样具备置信度校准的专用模型;
- 不要让大模型做无谓的填空:把“该做什么”与“输入什么”解耦,绝不在动作选择阶段强加长文本生成的负担;
- 拥抱结构化工具协议:在开发网页或应用时,主动支持 WebMCP 或 MCP 规范,让你的服务成为 AI 时代原生可即时调用的“官方菜单”。
有时候,一个“只会做单选题”的螺丝钉,比一个“什么都会一点”的昂贵天才,更能真正撬动现实世界的生产力革命。