
打破 KV Cache 的暴政:TypeSafe Jev 工程学与 Coding Agent 原生 Harness 架构重构
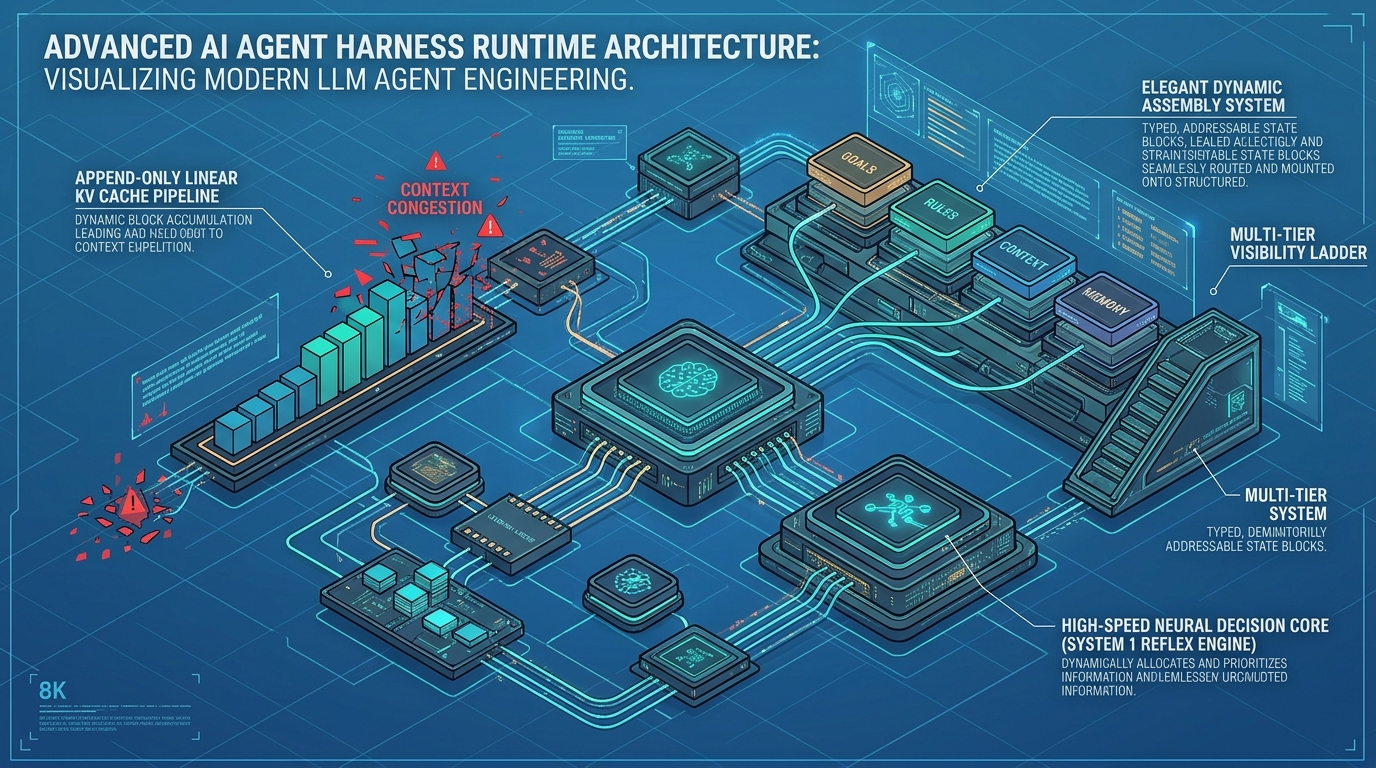
在当今的大模型与编程智能体(Coding Agent)浪潮中,存在着一个极其讽刺的现实悖论:底层基座模型的参数量、多模态能力与推理时算力(Test-time Compute)日新月异,而上层负责承载模型运行的 Agent 运行时(Harness),本质上却依旧停留在一段极其原始的 while 循环里——一个模型,搭配一份只追加(Append-only)的对话记录和几个固定的文件读写工具。
由 TypeSafe 创始人 Diogo Almeida 提出、近期由开发者社区译介并引发系统架构圈激烈讨论的开源项目 《Jev 工程学:为 coding agent 而作》(yibie/jev-engineering-zh),以极高的工程洞察力直击这一技术痛点。它抛出了一个震撼软件工程界的反直觉设问:“如果语言模型完全没有 KV Cache,你会如何重新设计一个 Coding Agent?” 这份工程蓝图不仅深刻揭示了线性追加对话对现代 Agent 体系的六大严重绑架,更从第一性原理出发,系统推演了一套基于显式带类型状态、毫秒级离散裁决与动态上下文组装的原生 Harness 架构体系。
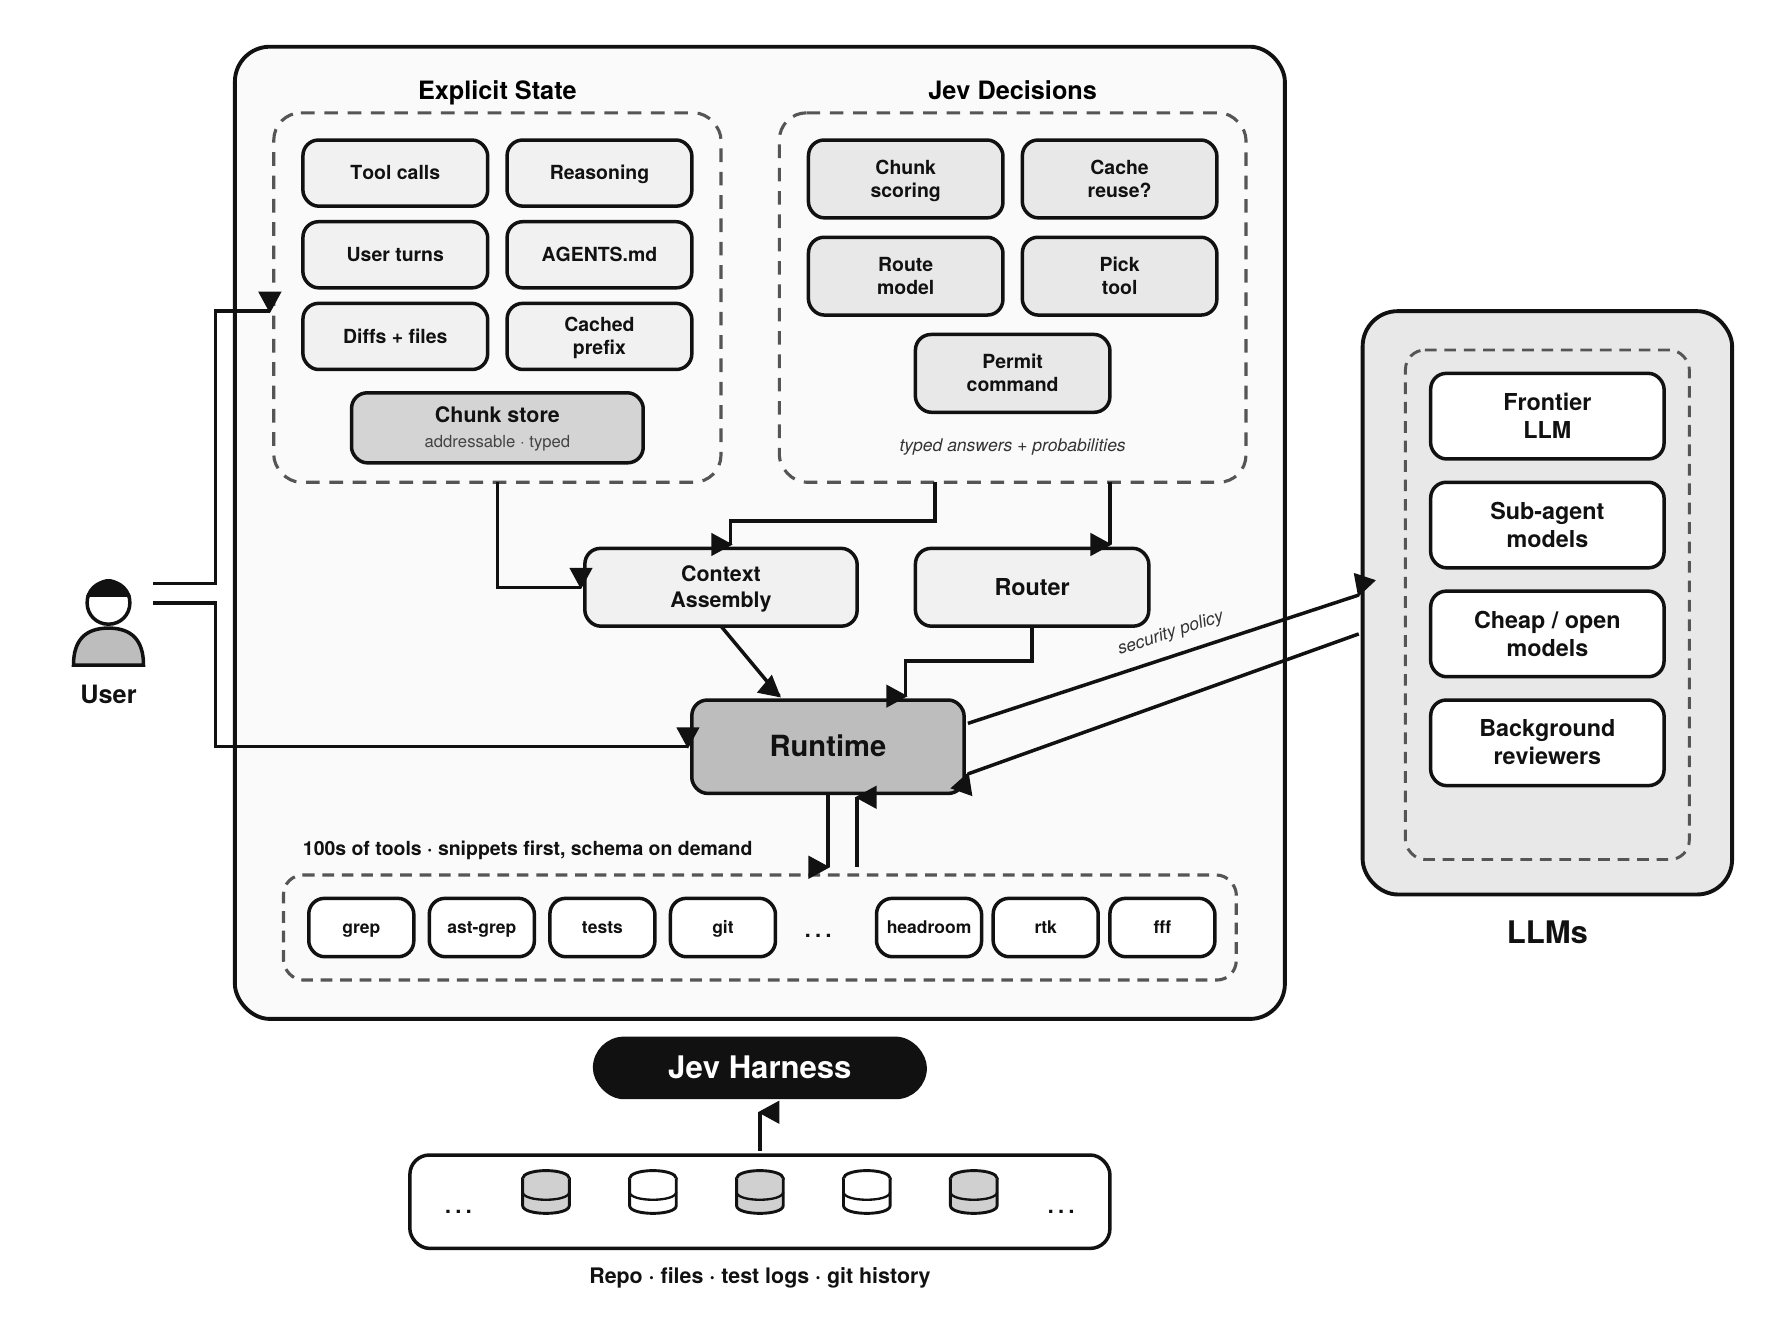
图 1. Jev Harness 整体架构概览。显式状态以可寻址、带类型的块存储;Jev 在每一轮高频回答微决策;上下文组装层与路由器驱动运行时,以“片段优先”的方式分级披露工具并执行策略路由。
一、 核心追问:如果大模型没有 KV Cache,你会怎么做?
在计算机体系结构的历史中,存储介质的物理经济学往往决定了操作系统的软件范式。现代 Coding Agent 之所以被普遍构建为“一个不断往后追加消息的无底洞列表”,其本质推手并非认知逻辑的最佳实践,而是大模型服务商的商业计费与加速硬件现实:KV Cache(键值缓存)。
在主流 LLM 推理架构中,复用已缓存的前缀(Prefix Cache)极其廉价;而一旦改动了对话上下文早期的任何一个字符,就会直接击穿 KV Cache,迫使 GPU 集群对改动点之后的所有上下文 Token 进行昂贵的全量重新处理(Reprocessing)。这一单一的经济现实,像无形枷锁一样塑造了当前 Agent 的几乎每一个设计决策——作者将其精准定义为“KV Cache 的暴政(The Tyranny of KV Cache)”。
flowchart TD
    subgraph TraditionalAgent ["传统线性追加 Agent (受制于 KV Cache 经济学)"]
        direction TB
        C1["固定系统提示词 + 全量工具 Schema (常驻)"] --> C2["对话轮次 1: 读入数百行文件"]
        C2 --> C3["对话轮次 2: 庞大的 grep 搜索噪声"]
        C3 --> C4["对话轮次 3: 爆炸的终端错误日志"]
        C4 --> C5["不断膨胀的静态上下文列表 (只能 Append,不敢修改历史)"]
        C5 --> C6["最终恶果: 目标漂移 / 上下文污染 / 盲目 Compaction 丢细节"]
    end

    subgraph JevHarness ["Jev 显式状态 Harness (动态组装范式)"]
        direction TB
        S1["可寻址的离散状态块池 (Goals / Rules / Context / Memory)"]
        JevCore["Jev 毫秒级微决策层 (Choice / Score / Noul)"]
        Assembly["按当前查询动态组装最小必要上下文"]
        Ladder["可见性阶梯: 隐藏 / 极简摘要 / 深度摘要 / 完整展开"]

        S1 --> JevCore
        JevCore --> Assembly
        Assembly --> Ladder
        Ladder --> Exec["前沿大模型 / 专用子 Agent 精准执行 (零上下文冗余)"]
    end

    style TraditionalAgent fill:#fff3e0,stroke:#f57c00,stroke-width:2px
    style JevHarness fill:#e8f5e9,stroke:#2e7d32,stroke-width:2px
如果我们将 KV Cache 的经济假定暂时剥离,就会立刻发现当前行业广泛采用的“线性对话记录”是多么简陋。Agent 真正的核心杠杆,从来不在那个平庸的 while 循环代码里,而在每一轮循环开始前,Harness 究竟把哪些上下文端到了模型面前。
二、 深度病理诊断:KV Cache 绑架下的六大工程症状
为了维系 KV Cache 前缀命中的经济假象,当下的 Coding Agent 架构不得不吞下六个代价惨重的技术妥协:
| 妥协症状 | 表面存在的原因 | 隐藏的真实工程代价与后果 |
|---|---|---|
| 1. 路由失效 (Broken Routing) |
试图交还给大模型时必须重新处理所有历史上下文 | 成本倒挂:混合路由(大模型规划 -> 便宜模型执行 -> 大模型审查)比纯前沿模型更昂贵! |
| 2. 工具挤占窗口 (Tool Crowding) |
工具 Schema 必须常驻系统消息以保住缓存前缀 | 宝贵 Token 浪费在无关工具定义上,高基数导致工具匹配率雪崩 |
| 3. 盲目压缩 (Lossy Compaction) |
假设未来所有轮次都共享同一份全局上下文状态 | 在知道未来问题前压缩,导致后续排障急需的关键线索被无损摘要掉 |
| 4. 子 Agent 稀少 (Rare Subagents) |
很难决定传什么上下文进去、以及如何将结果合并回主线 | 开发者与模型主动回避子 Agent,导致无法实现真正的任务并发 |
| 5. 暴力重启 (Destructive Reset) |
有状态的线性对话流随轮次增加不可逆地腐化变质 | 用户被迫使用 /reset 重新开局,好上下文与脏上下文被同归于尽 |
| 6. 电池之争 (Batteries Dilemma) |
每个内置能力或辅助工具都会永久性地消耗每轮 Token | 开发者被逼在“开箱即用(易用)”与“保持智商(强大)”之间零和博弈 |
1. 路由成本倒挂的数学实证
业界普遍存在一种直觉假设:“让贵的大模型做规划,把琐碎的代码执行交给便宜模型,最后再让大模型审查,一定能大幅降低 Token 账单。”
Diogo Almeida 在笔记中给出了严谨的算术推导。以业界主流标价(Opus:5 美元输入 / 25 美元输出每百万 Token;Sonnet:3 美元输入 / 15 美元输出每百万 Token)为例,设 X 为基础上下文 Token 数,Y 为模型生成输出 Token 数,Z 为任务执行中读入的额外 Token 数(如文件内容与命令输出):
路径 1: 纯 Opus 独立闭环
  生成成本 = 25 · Y
  读取成本 = 5 · Z
  合计 = 25Y + 5Z

路径 2: 混合路由 (Opus 规划 -> Sonnet 执行 -> Opus 终审)
  Sonnet 首次载入全量上下文 = 3 · X
  Sonnet 生成代码 = 15 · Y
  Sonnet 读取上下文 = 3 · Z
  Opus 重新加载所有发生变化的部分 = 5 · (Y + Z)
  合计 = 3X + 20Y + 8Z
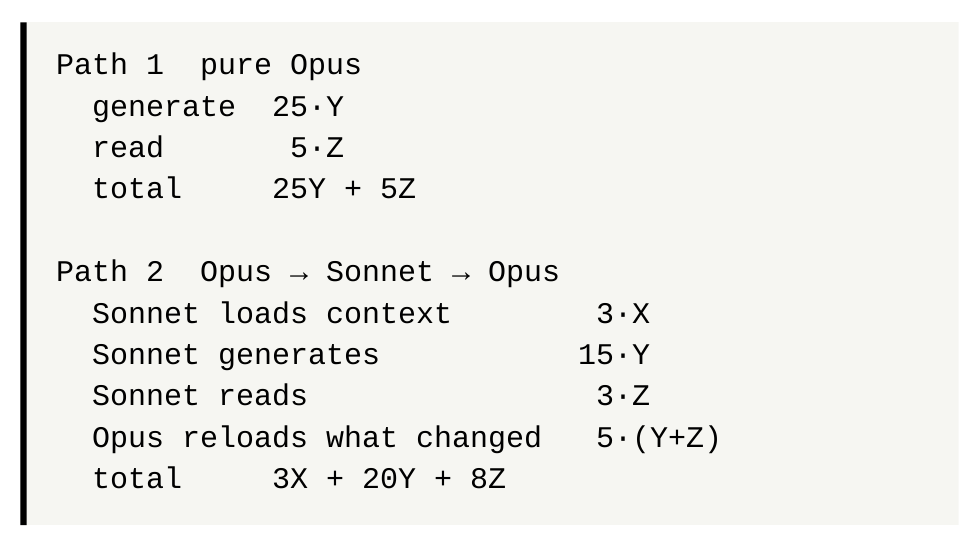
图 2. 路由陷阱。把执行委派给便宜模型,会在下行时增加一次全量上下文载入、在回程时增加一次重新处理,二者之和往往直接击穿了每 Token 的折扣。
代入真实工程中常见的参数(以百万 Token 归一化:X = 0.65,Y = 0.12,Z = 0.23):
- 路径 1(纯 Opus):
25 × 0.12 + 5 × 0.23 = 3.0 + 1.15 =4.15 美元 - 路径 2(混合路由):
3 × 0.65 + 20 × 0.12 + 8 × 0.23 = 1.95 + 2.40 + 1.84 =6.19 美元
结论令人震撼:原本为了省钱而设计的混合路由,实际账单比全程使用顶尖模型贵了整整 50%!
因为便宜模型必须先重新“吞下”那份沉重的历史前缀 X,而回程时顶尖模型又必须重新处理便宜模型产出的脏上下文。这证明了一个深刻的架构真理:脱离了上下文动态重建的静态路由,纯粹是数学幻觉。
三、 Token 真实账单解密:编写代码只是冰山一角
在重新构建下一代 Harness 之前,我们必须看清 Coding Agent 会话中 Token 消耗的真实分布。许多工程师以为 Agent 的主力消耗在写代码或架构推演,但工业界的一手实测数据完全颠覆了这一常识:
| 会话子任务分类 | 占总处理 Token 比例 | 工业现状与说明 |
|---|---|---|
| 读取代码与文件内容 | 30% ~ 40% | 最大支出项;文件被作为上下文反复全量塞入 |
| 搜索代码库(grep / glob / 列表) | 10% ~ 18% | 产生大量无效的长文本搜索噪音 |
| 命令执行与终端输出 | 10% ~ 20% | 编译失败时的大段堆栈追踪与调试日志 |
| 系统提示词 / Schema / AGENTS.md | 5% ~ 12% | 每一轮对话无论是否相关都要支付的固定底噪 |
| 对话重放放大倍数 | — | 以上所有输入在每一轮线性追加中被成倍重复计费 |
| 模型规划与逻辑推理 | 5% ~ 15% | 遇到深层 Bug 时有所上升 |
| 实际编写与修改代码 | 4% ~ 10% | 极度紧凑;由于使用 diff 或字符串替换,输出极短 |
| 向用户解释与自然语言输出 | 2% ~ 5% | 终端命令行 Agent 默认极其简炼 |
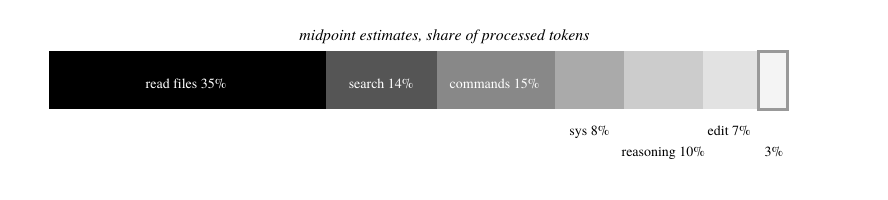
图 3. 真实 Agent 会话中的 Token 分布。读取文件、代码库搜索与终端命令输出合计占据了处理 Token 的三分之二以上;而写代码本身甚至不足十分之一。
微软研究院针对 GPT-5.4 智能体轨迹(fastcontext 项目)的独立评测也彻底佐证了这一规律:在真实 Coding 任务中,读取和搜索占到了所有工具调用轮次的 56.2%、占据了主 Agent 处理总 Token 的 46.5%。
这意味着:优化 Coding Agent 经济性与智商上限的最大胜负手,根本不是更换更聪明的模型,也不是改进 git diff 的输出格式,而是彻底重构底层的上下文检索与组装系统!
四、 Jev Harness 范式:从“线性累积”到“动态组装”
针对传统 Agent 的系统性痼疾,TypeSafe 给出的破局方案是一个围绕显式、可寻址、带类型的状态块构建的 Jev Harness 运行时。
1. 显式状态机与 Jev 微决策分工
在此架构中,LLM 不再是一个背着沉重背包的“苦行僧”,而是被 Harness 严密保护的“计算核心”:
- 状态解耦:目标(Goals)、全局规则(Rules)、环境快照(Context)、持久记忆(Memory)不再被揉捏成一段长文本,而是作为独立的不可变对象存储在 Harness 的状态池中;
- Jev 高频微决策:TypeSafe 开发的 Jev 并不是用来写业务代码的模型,而是专职负责离散裁决的 System 1“反射中枢”。每一轮会话中,Harness 可能会向 Jev 发起几十上百次微秒级查询:
- Choice(离散选择):当前应激活哪个工具?路由给哪个模型?
- Noul(布尔断言):这条终端命令是否安全可执行?是否应当销毁现有缓存重新组装?
- Score(有序评分):该段检索日志对解答当前问题的重要性是几级?
sequenceDiagram
    autonumber
    actor User as 开发者
    participant Harness as Jev Harness 控制器
    participant Jev as Jev 决策核心 (System 1)
    participant State as 显式状态块池 (Addressable Chunks)
    participant FrontierLLM as 前沿大模型 (System 2: Opus / Sonnet)

    User->>Harness: 输入复杂重构需求
    Harness->>State: 提取任务目标与上下文候选项
    Harness->>Jev: 微决策: 当前是否复用前缀缓存?
    Jev-->>Harness: Noul: False (检测到环境剧变,重建上下文更优)
    Harness->>Jev: 对候选项在可见性阶梯上打分
    Jev-->>Harness: 给出按查询裁剪的结构化切片
    Harness->>FrontierLLM: 派发极度纯净的动态组装上下文 (无噪音)
    FrontierLLM-->>Harness: 意图执行: 需检索某个模块定义
    Harness->>Jev: 工具路由匹配 (三级分级披露)
    Jev-->>Harness: 动态下发 ast-grep 精准工具 Schema
    Harness-->>User: 毫秒级反馈与精准代码变更
五、 五大核心解耦支柱:重构 Agent 的工程现实
1. 可见性阶梯(Visibility Ladder):按查询感知的动态压缩
传统的 Compaction(会话压缩)之所以灾难性地丢失细节,是因为它试图做与具体问题无关的通用压缩。当 Agent 还没看到下一轮的用户指令时,它根本不知道一段 2000 行的日志里哪一行会成为救命稻草。
Jev 提出了可见性阶梯机制,同一个状态块在不同的查询语境下,可以由 Harness 动态降级或升级为四种形态:
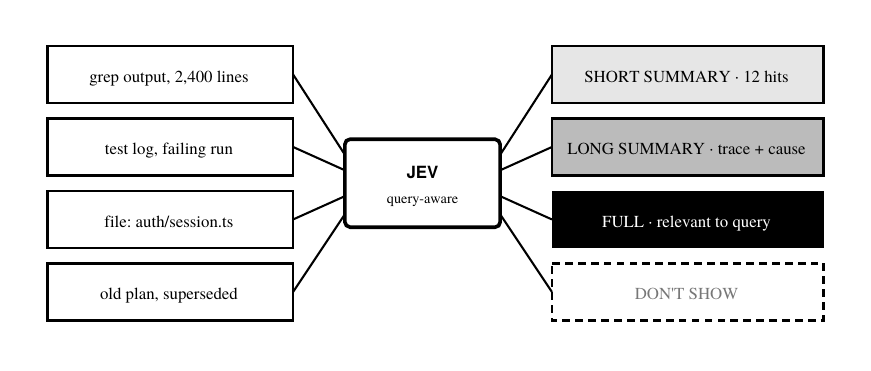
图 4. 可见性阶梯机制。同一数据块在面对不同查询时,可以被完全隐藏、呈现为 1 句话摘要、呈现为结构化细节摘要,或展开为原始文本。
- Hidden(隐藏):与当前子目标完全无关,Token 开销为零,但随时保留在物理存储中供后续重新索引;
- Brief Summary(极简摘要):一句话说明存在性(例如:“已执行单元测试,45 个测试用例全部通过”);
- Detailed Summary(深度摘要):保留关键接口签名、失败原因与环境关键变量;
- Full Content(完整展开):当且仅当当前轮次需要逐行分析某段崩溃堆栈或核心算法时,才全量载入。
这使得长文本检索结果永远不会被不可逆地摧毁,却能以极低的 Token 预算呈现在模型面前。
2. 工具的三级分级披露(Progressive Disclosure)
传统 Agent 的工具定义像是一个随身携带数百种工具的笨重工具箱,模型每次思考都要把所有螺丝刀、扳手的完整说明书(JSON Schema)读一遍。
Jev Harness 将工具调用解耦为三级按需披露管道:
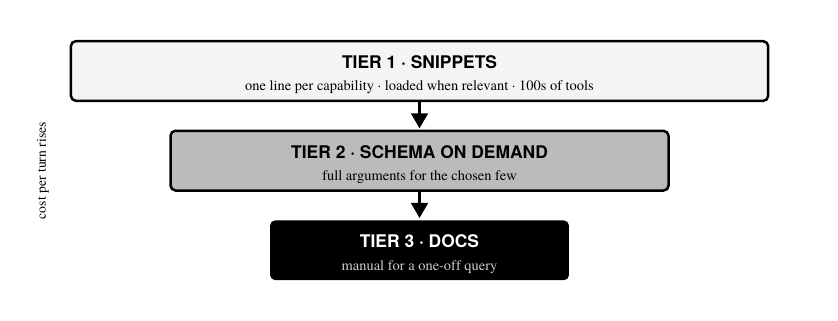
图 5. 三级披露管道。模型首先看到极度便宜的全局功能地图,仅在命中意图时按需展开参数细节,动作完成后立即卸载释放上下文。
- 一级(全局地图索引):在系统提示词中仅保留极短的动作别名与一句话意图描述;
- 二级(动态短片段加载):当模型的自然语言表达命中某个意图时,动态激活对应的操作指导(Skill Snippet);
- 三级(完整 Schema 注入与即时卸载):当且仅当模型决定下发调用时,临时挂载其强类型参数约束;调用执行完毕后,参数定义立刻从上下文中剥离。
这种设计彻底终结了“电池之争”:Agent 可以在本地预装上百个专业运维工具与数千页文档,而在没有被调用时,其边际 Token 消耗几乎为零。
3. 条件化指令(Conditional Instructions)与压缩免疫
在当前的工程实践中,项目往往在根目录放置一个巨大的 AGENTS.md。无论是在修 CSS 还是在写 SQL,这篇长文都会无差别地消耗上下文,并且极易在长会话后期被 Compaction 粗暴丢弃。
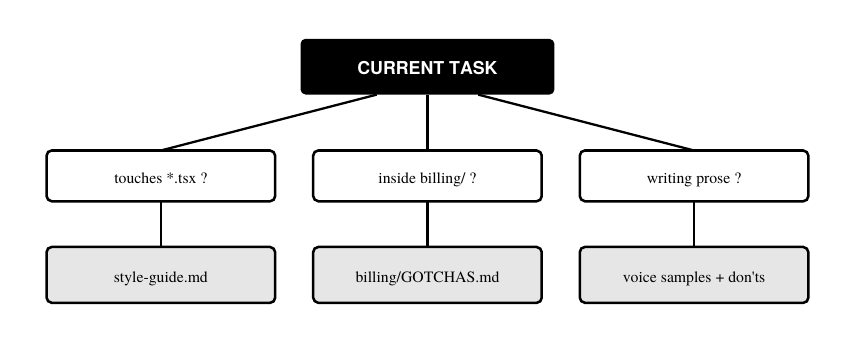
图 6. 条件化 AGENTS.md 机制。规则不再全局绑定在会话中,而是与物理目录、触发条件紧密挂钩,且具备强烈的压缩免疫力。
Jev Harness 提倡条件化指令系统:
- 目录级别隔离:进入
frontend/目录时自动加载前端设计风格指南,切换到db/时自动加载分表与安全约束; - 压缩免疫属性(Compaction-Immune):条件指令不是一次性的会话历史,而是被 Harness “钉住(Pinned)”的执行策略。即便会话经历再多轮次,只要触发条件成立,该规则就会以最高优先级注入。
4. 安全感知路由(Security-Aware Routing)
以往的模型路由仅仅权衡“任务难度”与“每 Token 单价”,而 Diogo 在工程蓝图中引入了至关重要的第三维度:信任与敏感度(Trust & Sensitivity)。
flowchart LR
    Task[待执行子任务] --> Inspector{Harness 文件触碰预检}
    Inspector -->|公共文档 / 第三方开源代码| Route1["公共低价模型 (DeepSeek / 开源端点)"]
    Inspector -->|核心业务代码| Route2["标准审查模型 (Sonnet / GPT-4o)"]
    Inspector -->|涉及 .env / 私钥 / 基础设施配置| Route3["严格受限的前沿本地或隔离端点"]
    Inspector -->|专有核心机密研究| Route4["第一方隔离前沿模型 (Opus / 企业私有云)"]

    style Route1 fill:#e0f2f1,stroke:#00897b,stroke-width:1px
    style Route3 fill:#ffebee,stroke:#e53935,stroke-width:2px
    style Route4 fill:#ede7f6,stroke:#5e35b1,stroke-width:2px
通过对任务将要触碰的文件路径进行前置安全分类,路由策略被固化为确定性的工程规则,杜绝了敏感配置或核心知识产权向非受信 API 泄露的巨大合规风险。
5. 显式状态上的后台并发(Read-only Background Pipeline)
在长程研发任务中,用户往往希望 Agent 在写代码的同时,能够并行产出实时看板、生成阶段性 Eval 评测或执行跨模型交叉审校。传统 Agent 如果并行启动多个子任务,每个子任务都会机械地重复读取一遍仓库上下文,导致 API 账单指数级爆炸。
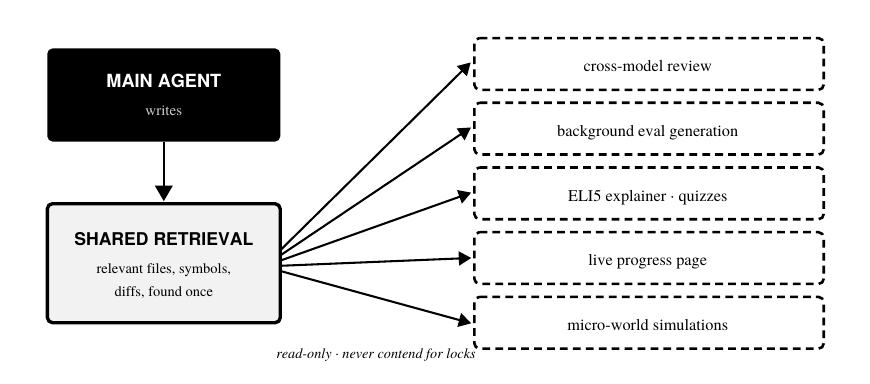
图 7. 显式状态下的后台并发架构。耗时且昂贵的代码检索过程只执行一次,多个只读后台任务共享这一份结构化检索结果。
Jev Harness 通过明确区分读操作与写操作,使得多个只读任务(如实时进度看板更新、ELI5 架构草图绘制、安全合规检查)可以零成本共享主任务的检索缓存,消除了数据争用与锁冲突,让极高密度的自主并发在经济上首次具备了可行性。
六、 架构师视角:AI Native 时代的软件工程定力
细读 yibie/jev-engineering-zh 翻译的这份厚重设计笔记,在我看来,它给当下所有在 Coding Agent 与大模型基建领域摸索的架构师敲响了一记震耳欲聋的警钟:
- 警惕“只要基座模型升级,系统就会自动变好”的唯模型论偷懒:
模型的上下文窗口从 8K 狂飙到 2M,并不意味着我们可以肆无忌惮地把未过滤的脏数据塞进 Prompt。垃圾进,垃圾出;上下文越冗长,模型的注意力弥散与逻辑脆弱度就会呈指数级恶化。 - 重拾对“确定性状态机与系统工程”的敬畏:
大模型擅长的是创造性推演、模糊意图理解与自然语言综合;而状态的持久化、权限的强制校验、工具参数的类型约束以及上下文的精准组装,必须由冷酷、高效且百分之百确定性的原生 Harness 严防死守。 - 从“聊天机器人外挂”走向真正的“操作系统进程”:
未来的 Coding Agent 绝不会是一个简单的问答插件。它将拥有独立的虚拟内存(组装式上下文)、分级的系统调用(分级披露的工具)、细粒度的访问控制策略(可编程权限)以及高效的进程间通信。唯有挣脱 KV Cache 的直觉绑架,重塑动态组装的心智图谱,我们才能真正锻造出经得起工业生产环境拷打的下一代工程智能体。
相关链接与参考资料:
- 官方中文翻译仓库:yibie/jev-engineering-zh
- 原文设计笔记作者:Diogo Almeida (TypeSafe 创始人)
- 原作完整设计文档:assets/original.pdf
- 微软快速上下文探索研究:fastcontext: Fast Context Exploration for Coding Agents