
重塑 iOS 指令流的九种兵刃:从 dyld 链式修复、Inline Trampoline 到硬件 PAC 绕过全景实录
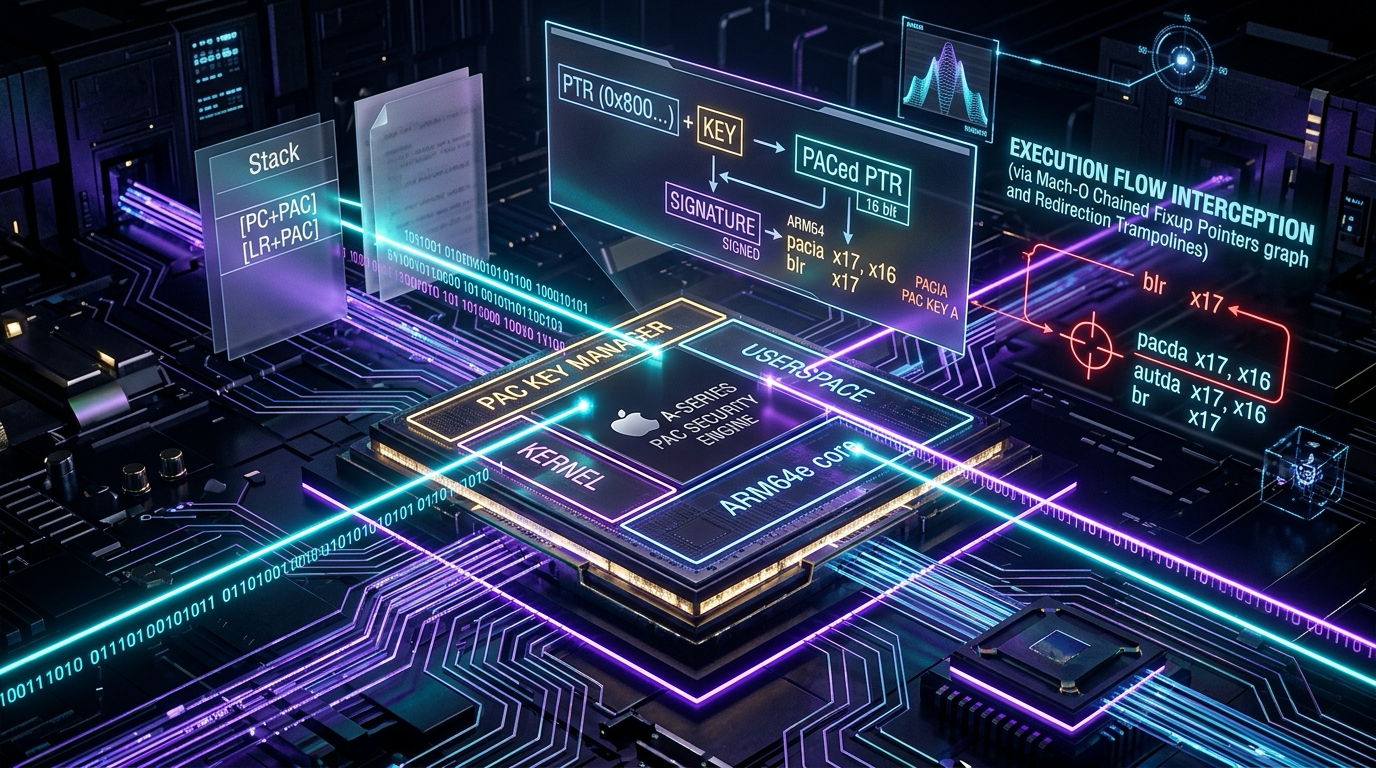
在 iOS 逆向工程与底层安全攻防的世界中,Hook 的本质从来不是“修改代码”,而是在不破坏原始编译二进制结构的前提下,通过重定向控制流打破预设的指令执行因果律。从最浅层的 Objective-C 动态方法派发,到 Mach-O 动态链接期的符号绑定表热修补,再到深入 ARM64 指令级的跳转覆盖与硬件级寄存器拦截,iOS 系统的拦截技术已经演化出一套层次分明、攻防对抗极强的工程体系。
面对现代化 iOS 运行时愈发严密的防御机制——包括 W^X 内存写执行互斥、代码段签名哈希校验、iOS 15 引入的 Chained Fixups 链式绑定,以及 Apple Silicon 独有的硬件级指针认证(PAC),任何试图“一招鲜吃遍天”的思路都会在实战中迅速遭遇崩溃。在这篇手记中,我将结合自身在复杂对抗环境下的实操经历,系统拆解九种主流与高阶 Hook 机制的底层机理、边界条件与关键踩坑细节,还原从指令序言外科手术到硬件级防御突围的完整技术全景。
1. 为什么“一个方案搞定一切”是不可能的?
在很多初涉 iOS 逆向的开发者印象里,Hook 往往始于一行简单的运行时方法交换:
// 一行代码,整个进程内所有对 [NSDate date] 的调用全部重定向
Method original = class_getClassMethod([NSDate class], @selector(date));
Method fake     = class_getClassMethod([NSDate class], @selector(fakeDate));
method_exchangeImplementations(original, fake);
这段代码直观优雅,但在工业级对抗中,它的局限性几乎是致命的:
- 如果目标函数是纯 C 编写的系统调用(如
open、ptrace、sysctl),Objective-C 运行时对其根本一无所知; - 如果我换用 fishhook 去篡改 Mach-O 的全局偏移表(GOT),却发现目标 App 内部的静态函数(
static void internal_check())压根不走 GOT,其跳转地址在编译期就已经由bl #offset硬编码写死; - 如果我进一步动用 Inline Hook(如 Dobby)强行覆写目标函数头部的机器码,又会瞬间撞上 ARM64e 的硬件指针认证(PAC)导致进程直接抛出
PAC/AUTH exception猝死,或者触发目标 App 的代码段完整性哈希校验。
iOS 运行时的多语言混编特性,决定了其底层代码天然分布在不同的绑定抽象层上:
| 语言与执行层 | 符号绑定方式 | 典型拦截目标 | 代表性 Hook 方案 |
|---|---|---|---|
| Objective-C | 动态运行时派发,SEL -> IMP 哈希查表 |
[UIApplication openURL:]、业务 Controller 方法 |
Method Swizzling、ISA Swizzling |
| C / C++(外部动态库) | 动态链接绑定,GOT / PLT 间接寻址 | open()、malloc()、sysctl() |
fishhook、GOT Rebinding |
| C / C++(内部私有/无符号) | 编译期相对偏移绑定或虚表派发 | 静态函数、脱壳后 Strip 符号的私有逻辑、虚函数 | Inline Hook(Dobby、ElleKit)、VTable Hook |
| 寄存器与指令执行级 | CPU 硬件上下文、异常调度向量 | 反调试汇编 svc #0x80、完整性自检函数 |
硬件断点(hwbphook)、Mach 异常端口 Hook |
这四个层级构成了现代 iOS 逆向攻防的“四层能力栈”。每一层工具的诞生,都不是为了取代前一层,而是为了覆盖上一层兵刃无法触达的全新攻击面。
flowchart TD
    Start["发起 Hook 拦截需求"] --> Q1{"目标是否为 ObjC 实例/类方法?"}
    Q1 -- 是 --> A1["Method Swizzling 或 ISA Swizzling"]
    Q1 -- 否 --> Q2{"目标是否为外部动态链接 C 符号?"}
    Q2 -- 是 --> A2["fishhook (GOT / Chained Fixups 重绑定)"]
    Q2 -- 否 --> Q3{"目标代码段是否受强哈希校验?"}
    Q3 -- 是 --> Q4{"受监控断点数量是否小于等于 6 个?"}
    Q4 -- 是 --> A3["硬件断点 Hook (hwbphook,零内存修改)"]
    Q4 -- 否 --> A4["Mach 异常端口劫持 (task_set_exception_ports)"]
    Q3 -- 否 --> Q5{"目标设备是否开启 ARM64e PAC?"}
    Q5 -- 是 --> A5["ElleKit / PAC-Aware Inline Hook"]
    Q5 -- 否 --> A6["标准 Inline Hook (Dobby / litehook)"]
2. 符号生命周期的分水岭:从 dyld3 到 dyld4 Chained Fixups
要理解符号级 Hook,必须先看清 Mach-O 符号在内存中的装载演进。
2.1 传统 Mach-O 间接符号解析(iOS 14 及之前)
在 iOS 14 及以前的系统中,fishhook 之所以能够大杀四方,完全建立在 Mach-O 二进制的动态符号重绑定特性之上:
- 可执行文件在调用动态库函数(如
printf)时,编译期无法获知动态库的物理装载基址; - 链接器会在
__DATA段中开辟懒加载指针表(__la_symbol_ptr)或非懒加载指针表(__got/__nl_symbol_ptr); - 初始时,
__la_symbol_ptr中的指针指向__TEXT段中的一段 dyld 桩代码(stub helper); - 首次调用发生时,桩代码调用 dyld 完成符号解析,并将解析出的真实函数地址写回
__DATA段对应的槽位; - fishhook 通过解析
LC_DYSYMTAB(间接符号表)与LC_SYMTAB(符号表和字符串表),在内存中反查出符号名称与指针槽位的映射关系,随后直接将该槽位中的函数指针覆盖为自定义的 Hook 函数指针。
2.2 iOS 15 的变革:LC_DYLD_CHAINED_FIXUPS 链式修复
从 iOS 15 开始,Apple 推出了全新重构的 dyld4,彻底弃用了由 LC_DYLD_INFO_ONLY 驱动的传统 rebase / bind 机制,全面转向 Chained Fixups(链式修复)。
[!IMPORTANT]
Chained Fixups 的本质机制:不再为每一个外部符号在符号表中维护固定的线性数组,而是直接把需要重定位(Rebase)和绑定(Bind)的内存位置,就地编码成一个分布在数据段内存页内的自引用单向链表。
每个待修复的指针槽位本身就存储着下一个槽位的相对偏移(next),dyld 在加载镜像时,只需沿着链表逐节点修复。这种设计极大压缩了 Mach-O 二进制体积与冷启动寻道开销,但却让只支持传统 LC_DYLD_INFO 的旧版 fishhook 瞬间瘫痪。
在现代 dyld4 环境下,要实现合规的 GOT 重绑定,必须实现双路径适配逻辑:
// 伪代码:兼容传统与现代 dyld4 Chained Fixups 的 GOT 重绑定引擎
int rebind_symbols_modern(struct rebinding rebindings[], size_t rebindings_nel) {
    uint32_t image_count = _dyld_image_count();

    for (uint32_t i = 0; i < image_count; i++) {
        const struct mach_header_64 *header = (const struct mach_header_64 *)_dyld_get_image_header(i);
        intptr_t slide = _dyld_get_image_vmaddr_slide(i);

        // 检查 Mach-O Load Commands 中是否包含 LC_DYLD_CHAINED_FIXUPS
        struct linkedit_data_command *chained_fixups = find_load_command(header, LC_DYLD_CHAINED_FIXUPS);
        if (chained_fixups) {
            // iOS 15+ 现代路径:解析 Chained Fixups 链表
            rebind_symbols_chained_pipeline(header, slide, chained_fixups, rebindings, rebindings_nel);
        } else {
            // iOS 14 传统路径:遍历 LC_DYSYMTAB 间接符号表
            rebind_symbols_legacy_pipeline(header, slide, rebindings, rebindings_nel);
        }
    }
    return 0;
}
现代遍历 Chained Fixups 的核心,在于从 __LINKEDIT 段准确定位导入表(Imports Table)与符号池基址:
void rebind_symbols_chained_pipeline(const struct mach_header_64 *header, intptr_t slide,
                                    struct linkedit_data_command *fixups_cmd,
                                    struct rebinding rebindings[], size_t rebindings_nel) {
    struct segment_command_64 *linkedit = find_segment(header, "__LINKEDIT");
    // 关键计算:__LINKEDIT 的真实虚拟内存基址
    uintptr_t linkedit_base = (uintptr_t)linkedit->vmaddr - linkedit->fileoff + slide;

    struct dyld_chained_fixups_header *fixup_hdr =
        (struct dyld_chained_fixups_header *)(linkedit_base + fixups_cmd->dataoff);

    // 导入符号池基地址
    const char *symbols_pool = (const char *)(linkedit_base + fixups_cmd->dataoff + fixup_hdr->symbols_offset);
    struct dyld_chained_import *imports =
        (struct dyld_chained_import *)(linkedit_base + fixups_cmd->dataoff + fixup_hdr->imports_offset);

    // 遍历每一个 Segment 中的 Chained Starts
    struct dyld_chained_starts_in_image *starts_in_image =
        (struct dyld_chained_starts_in_image *)((uintptr_t)fixup_hdr + fixup_hdr->starts_offset);

    for (uint32_t seg_idx = 0; seg_idx < starts_in_image->seg_count; seg_idx++) {
        uint32_t seg_offset = starts_in_image->seg_info_offset[seg_idx];
        if (seg_offset == 0) continue;

        struct dyld_chained_starts_in_segment *seg_starts =
            (struct dyld_chained_starts_in_segment *)((uintptr_t)starts_in_image + seg_offset);

        // 沿单向链表遍历页面内所有需要绑定的指针位置
        for (uint16_t page_idx = 0; page_idx < seg_starts->page_count; page_idx++) {
            uint16_t chain_start = seg_starts->page_start[page_idx];
            if (chain_start == DYLD_CHAINED_PTR_START_NONE) continue;

            uintptr_t current_ptr_loc = calculate_page_address(seg_idx, page_idx, chain_start, header, slide);
            while (current_ptr_loc != 0) {
                uint64_t raw_val = *(uint64_t *)current_ptr_loc;
                // 解析当前指针是否为 bind 节点
                if (is_chained_bind_ptr(raw_val, seg_starts->pointer_format)) {
                    uint32_t bind_ordinal = extract_bind_ordinal(raw_val, seg_starts->pointer_format);
                    const char *sym_name = symbols_pool + imports[bind_ordinal].name_offset;

                    for (size_t k = 0; k < rebindings_nel; k++) {
                        if (strcmp(sym_name, rebindings[k].name) == 0) {
                            // 匹配成功,保存原地址并覆写 GOT 指针槽位
                            if (rebindings[k].replaced) {
                                *rebindings[k].replaced = *(void **)current_ptr_loc;
                            }
                            *(void **)current_ptr_loc = rebindings[k].replacement;
                        }
                    }
                }
                current_ptr_loc = get_next_chain_ptr_loc(current_ptr_loc, raw_val, seg_starts->pointer_format);
            }
        }
    }
}
3. 指令级外科手术:Inline Hook 与 Trampoline 架构
当拦截目标变成 C++ 内部函数、非导出私有逻辑或经过 Strip 剥离符号的地址时,符号表完全失效。此时唯一可行的手段就是 Inline Hook(行内劫持)。
3.1 ARM64 函数序言与跳转指令设计
在 AArch64 架构下,所有指令严格固定为 32 位(4 字节)。一个标准的 ARM64 函数序言通常如下:
sub    sp, sp, #0x30            ; 分配 48 字节栈帧
stp    x29, x30, [sp, #0x20]    ; 保存 Frame Pointer 与 Link Register (LR)
stp    x20, x19, [sp, #0x10]    ; 保存被调用者保护寄存器
Inline Hook 的核心工作,就是在被 Hook 函数的入口,强行把第一条(或多条)指令替换为无条件跳转指令,将 CPU 的流水线强行导流到自定义的 Hook 函数中。
跳转指令的选择取决于目标函数与替换函数之间的相对地址距离:
- 直接相对跳转(Near Branch,
b #imm26):- 编码体积:仅需 4 字节;
- 寻址范围:PC 相对寻址 ;
- 优势:只覆盖 1 条指令,极大降低破坏原函数紧随其后的跳转目标的风险,且天然对 ARM64e PAC 校验透明。
- 间接长跳转(Far Branch,
adrp + add + br):- 编码体积:需 12 字节(3 条指令);
- 寻址范围:全局 64 位虚拟地址空间;
- 代价:必须覆盖连续 3 条指令,且需要暂借一个临时寄存器(通常使用通用寄存器
x16或x17,它们在 AAPCS64 调用约定中被指定为 Intra-Procedure-call 暂存器)。
3.2 跳板(Trampoline)生命周期管理
为了让被 Hook 的原函数依然能够正常执行完整流程,Hook 引擎不能简单地将原指令丢弃,必须构建一块动态的可执行跳板(Trampoline)。
flowchart LR
    Caller["调用方调用 TargetFunc"] --> HookedEntry["TargetFunc 入口 (被覆盖)"]
    HookedEntry -->|"b #MyHookFunc"| MyHook["自定义 Hook 函数"]
    MyHook -->|"执行自定义预处理"| Process["拦截/篡改参数"]
    Process -->|"调用原函数 origin_call"| Trampoline["Trampoline (跳板内存页)"]

    subgraph TrampolineBox ["Trampoline 内存结构"]
        Backup["被窃取的原始前 N 条指令 (修复 PC 相对寻址)"]
        BackJump["跳回原函数未被覆盖处: TargetFunc + N"]
    end

    Trampoline --> Backup
    Backup --> BackJump
    BackJump --> Remaining["TargetFunc 剩余原生指令"]
在构造 Trampoline 时,有三个极为关键的硬核工程约束:
- PC 相对寻址指令修复(Instruction Relocation):
如果被覆盖的原始指令包含adr、adrp、b、bl、cbz、tbz等依赖当前 PC 值的相对跳转指令,直接复制到跳板页执行会导致计算出的物理地址彻底偏离!Hook 引擎(如 Dobby)必须内置一个反汇编引擎,识别此类指令并重新计算编码其相对偏移量。 - W^X(Write XOR Execute)安全策略突破:
iOS 系统的 Mach 内核严格执行 W^X 策略:同一块物理内存页绝不允许同时拥有可写(W)与可执行(X)权限。在非越狱或严格签名环境下,直接调用mprotect(PROT_READ | PROT_WRITE | PROT_EXEC)会直接抛出KERN_PROTECTION_FAILURE。标准处理必须分步交替进行:// 1. 暂时移除执行权限,授予写权限 mprotect(target_page, PAGE_SIZE, PROT_READ | PROT_WRITE); // 2. 写入跳转指令 memcpy(target_address, branch_instructions, branch_len); // 3. 恢复执行权限,撤销写权限 mprotect(target_page, PAGE_SIZE, PROT_READ | PROT_EXEC); - CPU 指令缓存同步(Instruction Cache Flush):
现代 ARM 处理器拥有相互独立的数据缓存(D-Cache)和指令缓存(I-Cache)。内存写入操作通过 D-Cache 刷入主存,但此时 I-Cache 中可能依然保留着旧有的机器码缓存。若不显式刷新,CPU 流水线将继续拾取旧指令,导致 Hook 间歇性失效或发生未定义行为:sys_icache_invalidate(target_address, branch_len);
4. 终极硬件屏障:ARM64e PAC 原理与突围
从 Apple A12 仿生芯片(iPhone XS / XR)起,Apple 全面开启了 ARMv8.3-A 架构的 PAC(Pointer Authentication Code,指针认证码) 硬件防御。
4.1 PAC 的底层硬件运行机理
PAC 的核心目标是彻底摧毁内存攻击中的面向返回编程(ROP)与跳表劫持(JOP)。它的工作机制如下:
[!NOTE]
每一个受保护的指针在存入内存前,CPU 利用硬件内置的加密算法(如 QARMA 或 Apple 自研密码原语)结合一个 128 位硬件密钥和一个上下文微扰值(Context Discriminator),对指针的有效地址位进行加密哈希计算,将生成的签名(通常占用高 16 到 24 位高位地址空间)内嵌到指针自身之中。
64 位 PAC 指针结构示意:
+----------------------------+-----------------------------+
|   Top Byte / PAC 认证签名位  |     真实虚拟有效地址位         |
+----------------------------+-----------------------------+
 63                        47 46                          0
Apple 在硬件中共定义了 5 个专用密钥:
IA Key/IB Key:专门用于指令指针(Instruction Pointers)认证;DA Key/DB Key:专门用于数据指针(Data Pointers)认证;GA Key:通用散列密钥。
在 ARM64e 模式下,函数间接跳转必须使用带有认证后缀的专用指令:
BRAA  x0, x16      ; 跳转到 x0,用 x16 寄存器作为 Context 校验 IA Key 签名
BLRAA x0, x16      ; 调用 x0,校验签名,并将当前 LR 加密签名后保存
RETAA              ; 从 LR 返回,硬件自动验证 LR 的 IA Key 签名是否合法
一旦指针高位的 PAC 签名与当前硬件寄存器运算出的签名不一致,CPU 硬件将立刻把指针的高位篡改为不可访问的无效地址(如 0x00000040xxxxxxxx),在随后的寻址指令中直接引发不可捕获的段错误崩溃。
4.2 为什么 PC-relative b 指令天然对 PAC 免疫?
很多开发者面对 ARM64e 时感到束手无策,误以为所有跳转都会受到 PAC 拦截。然而,深入微架构后就会发现一个关键突破口:
[!TIP]
PAC 保护的是“存储在寄存器或内存中的指针变量”,而不是“硬编码在机器指令内部的操作码”。
对比两条跳转指令的汇编执行:
; 指令 A: 直接相对跳转
B    _my_replacement_func
; 目标地址 = PC + (imm26 << 2)
; 偏移量直接内嵌在指令编码自身中,完全不经过任何寄存器,不存在"指针",PAC 根本无法介入!

; 指令 B: 间接寄存器跳转
BRAA x16, x17
; 目标地址来自 x16 寄存器,属于指针,必须经过 CPU 密码引擎校验
这一微架构特性为 Inline Hook 在 ARM64e 下的生存提供了坚实基础:
- 近程 Hook( 内):只要 Hook 函数与目标函数在虚拟地址空间的相对距离不超过 128MB,直接使用 4 字节的
b指令进行覆写,天然不受 PAC 任何拦截; - 现代越狱框架(ElleKit)的 PAC 适配:ElleKit 在 Dopamine 和 palera1n 中大放异彩的核心原因之一,就是其内置的高性能 JIT 分配器。它在申请 Trampoline 跳板内存页时,会极力在目标函数的 邻域范围内寻找虚拟内存空洞,从而全部采用纯
b指令构建跳板,彻底绕开 PAC 校验!
4.3 __AUTH_CONST.__auth_got 节的重签名技巧
如果必须在 ARM64e 下对 GOT 符号或虚表指针做热修补(如 hook __auth_got 节中的系统导出函数),由于该节存储的是已签名的函数指针,直接填入裸指针会在执行 BRAA 时暴毙。此时必须参照 dyld 内部逻辑,调用标准内核头文件中的 PAC 编译器内置函数进行重新签名:
#include <ptrauth.h>

void patch_auth_got_entry(void **got_slot, void *new_func_target) {
    // 1. 读取原槽位中的带 PAC 签名指针
    void *original_signed_ptr = *got_slot;

    // 2. 剥离旧指针签名(获取无签名的真实裸地址)
    void *raw_target = ptrauth_strip(new_func_target, ptrauth_key_asia);

    // 3. 计算 Discriminator(上下文分流器,通常基于地址自身计算或类型哈希)
    ptrauth_extra_data_t extra_discriminator = ptrauth_blend_discriminator(
        got_slot,
        ptrauth_string_discriminator("func_signature_discriminator")
    );

    // 4. 使用 IA Key 重新对新目标函数计算 PAC 签名
    void *new_signed_ptr = ptrauth_sign_unauthenticated(
        raw_target,
        ptrauth_key_asia,
        extra_discriminator
    );

    // 5. 将合法签名的指针安全回写到 __auth_got
    *got_slot = new_signed_ptr;
}
5. 无痕拦截的三大高阶杀器
当目标 App 配备了高强度的代码段完整性自检(定时比对 __TEXT 段的内存 Hash),任何修改哪怕一个字节机器码的 Inline Hook 都会瞬间暴露。在此类极端对抗场景下,我通常会转向另外三种隐蔽性极高、完全不修改代码段的无痕拦截方案。
5.1 硬件断点 Hook(hwbphook):零内存修改的降维打击
硬件断点 Hook 利用的是 ARM64 处理器内部的调试架构(Debug Architecture)。
ARM 芯片内部配备了一组专门的硬件断点寄存器:
DBGBVR<n>_EL1:断点值寄存器(Breakpoint Value Register),用于存放目标虚拟内存地址;DBGBCR<n>_EL1:断点控制寄存器(Breakpoint Control Register),用于配置断点匹配模式、执行特权级(EL0 / EL1)与使能开关。
sequenceDiagram
    participant MainThread as 目标主线程
    participant CPUCore as ARM64 CPU Core
    participant DebugReg as DBGBVR/DBGBCR 寄存器
    participant ExcHandler as 异常监听线程 (hwbphook)

    ExcHandler->>DebugReg: 配置 DBGBVR0 = TargetFunc 地址, DBGBCR0 使能
    MainThread->>CPUCore: PC 执行到 TargetFunc 入口
    CPUCore->>DebugReg: 硬件地址比对命中!
    CPUCore-->>MainThread: 挂起线程,抛出 EXC_BREAKPOINT 硬件调试事件
    CPUCore->>ExcHandler: 递交 arm_debug_state64_t 状态
    ExcHandler->>ExcHandler: 劫持 arm_thread_state64_t.__pc = MyHookFunc
    ExcHandler->>CPUCore: 回复 Mach 消息,恢复目标线程
    MainThread->>MainThread: 从 MyHookFunc 继续无缝执行
攻防特权分析:
- 零内存修改:代码段内存页的 Hash 与原始磁盘签名 100% 一致,代码段哈希校验彻底失效;
- PAC 免疫:执行流劫持是在硬件调试向量中直接修改上下文寄存器完成的,完全不经过代码分支指针运算;
- 物理硬件瓶颈:受限于 Apple Silicon 芯片内部的硬件资源,BRP(断点寄存器)数量通常仅有 6 个。因此,硬件断点 Hook 是名副其实的“狙击步枪”,只适合用于狙杀最核心的关键校验函数,无法用于大规模全量业务打点。
5.2 Mach 异常端口劫持:把断点包装成异常恢复
在越狱或具有 task_set_exception_ports 权限的环境下,利用 XNU 的 Mach 消息总线同样能实现极度隐蔽的拦截。
实战落地三步走:
- 注入断点陷阱:在目标函数首部写入一条仅占 4 字节的非法断点指令
brk #1(指令编码0xD4200020); - 注册异常接收端口:
mach_port_t exc_port; mach_port_allocate(mach_task_self(), MACH_PORT_RIGHT_RECEIVE, &exc_port); // 声明仅接管断点类异常 task_set_exception_ports( mach_task_self(), EXC_MASK_BREAKPOINT, exc_port, EXCEPTION_DEFAULT | MACH_EXCEPTION_CODES, ARM_THREAD_STATE64 ); - 独立监听线程接管上下文:
通过mach_msg()循环接收内核抛出的异常报文,直接修改线程寄存器快照中的程序计数器__pc与参数寄存器__x[0] ~ __x[7],随后构造合法的 Mach 回复报文。内核收到回复后,会自动唤醒被挂起的目标线程,使其无缝跳转到自定义函数执行。
这种方案的优势在于它避免了复杂的跳板构造,并且天然可以被混淆伪装成常规的 Crash 处理机制;其劣势则是每次拦截均涉及一次用户态与内核态的双向 IPC 调度,性能损耗较高,不适用于高频调用的循环逻辑。
5.3 C++ 虚函数表(VTable)拦截:击穿游戏引擎的防御死角
在面对 Unity(IL2CPP 转译)或 Unreal Engine 等大量采用 C++ 构建的 App 时,OC Swizzling 完全无用武之地。然而,C++ 的动态多态特性为我们留下了虚函数表(VTable)这一天然的劫持位面。
在 Itanium C++ ABI 标准规范下,包含虚函数的类实例,其对象首 8 字节是一个指向虚函数表的指针 vptr。但千万不要以为虚表只包含函数指针!
[!WARNING]
虚表内存的负偏移陷阱:虚表指针vptr指向的地址是第一个虚函数的入口(vptr[0]),但在vptr之前,还严格存在两个关键的元数据槽位:
vptr[-1]:指向该类 RTTI(运行时类型信息) 的指针;vptr[-2]:offset_to_top(多重继承下的基类偏移量)。
如果我伪造虚表时仅仅复制了正向的函数指针数组,一旦目标代码执行 dynamic_cast、typeid 或抛出 C++ 异常,运行时访问 fake_vtable[-1] 就会读取到越界垃圾数据,瞬间引发难以排查的野指针崩溃!
// 伪代码:严格遵循 Itanium C++ ABI 的实例级虚表劫持
void hook_cpp_vtable_instance(void *cpp_obj, int method_idx, void *my_replacement) {
    // 1. 读取原始对象的虚表指针 vptr
    void **orig_vptr = *(void ***)cpp_obj;

    // 2. 获取该虚表中的函数数量
    size_t count = get_vtable_methods_count(orig_vptr);

    // 3. 核心:必须为元数据预留 2 个槽位,整体向前偏移 2 个指针宽度
    void **allocated_buffer = (void **)malloc((count + 2) * sizeof(void *));

    // 从 orig_vptr - 2 开始完整拷贝(包含 offset_to_top 与 RTTI 指针)
    memcpy(allocated_buffer, orig_vptr - 2, (count + 2) * sizeof(void *));

    // 4. 计算出伪造虚表的新入口指针 (指向新分配内存的索引 2 处)
    void **fake_vptr = allocated_buffer + 2;

    // 5. 覆写目标槽位上的虚函数指针
    fake_vptr[method_idx] = my_replacement;

    // 6. 将实例对象的 vptr 重定向到伪造虚表入口(仅影响当前实例,类似 ISA Swizzling)
    *(void ***)cpp_obj = fake_vptr;
}
这种实例级虚表篡改只修改堆内存中对象的首 8 字节,完全不碰只读的数据段与代码段,隐蔽性极强。
6. 三个让我彻夜排查的 Hook 崩溃实录
6.1 +load 竞态引发的死循环栈溢出
- 案发现场:设备同时加载了 Tweak A 与 Tweak B,两者均对
-[UIApplication openURL:]进行了 Method Swizzling。单独开启任意一个均稳定运行,但二者共存时,App 在启动阶段必现无限递归死锁,最终抛出EXC_BAD_ACCESS (KERN_PROTECTION_FAILURE)栈溢出崩溃。 - 根因溯源:Tweak A 在交换方法后,将其原始实现保存在自身的静态变量中;而 Tweak B 随后执行交换。部分开发者在 Hook 实现内部,为了防止原指针丢失,错误地调用了
class_getMethodImplementation(cls, @selector(openURL:))去动态查询所谓“原函数”。然而,在经过两次交换后,该 API 返回的恰恰是当前已经被劫持的 Hook 函数自身!再次调用该函数直接陷入自调用死循环。 - 铁律与避坑:
严禁在 Hook 函数体内动态查询当前被 Hook 的方法实现。必须在 Hook 初始化时(
+load或__attribute__((constructor))),通过全局静态变量固定保存原函数指针,或者完全依赖现代化框架(如 ElleKit / Substrate)提供的闭包 Trampoline 自动解决多重调用链传递。
6.2 fishhook 拦截 ptrace 彻底失效的真相
- 案发现场:尝试使用 fishhook 拦截
ptrace防止 App 退出,rebind_symbols调用返回成功且返回值校验正常,但 App 在检测到逆向工具后依然毫无阻碍地执行PT_DENY_ATTACH退出。 - 根因溯源:
很多安全自研人员误以为这属于“动态库加载时序”问题,但反编译后发现,目标 App 的防护模块压根没有通过libsystem_kernel.dylib导出符号发起调用,而是直接内嵌了原生的 ARM64 汇编指令发起内核软中断:mov x0, #31 ; PT_DENY_ATTACH 标志位 mov x1, #0 mov x2, #0 mov x3, #0 mov x16, #26 ; 26 号系统调用号: SYS_ptrace svc #0x80 ; 发起 Supervisor Call,直穿 XNU 内核svc #0x80是完全自包含的机器码,指令流直接从用户态切换至内核态 EL1,根本不经过 Mach-O 的动态链接器与 GOT 表,fishhook 自然连目标指令的一根毫毛都碰不到! - 铁律与避坑:
对付直接内联系统调用的防护代码,符号重绑定彻底作废。此时只能使用硬件断点拦截该svc指令所在的物理地址,或者使用 Inline Hook 强行 patch 目标模块中包含该段内联汇编的外部包装函数。
6.3 页边界地址碰撞引发的内存保护死锁
- 案发现场:使用 Dobby 对某加固 App 的内部核心函数进行 Inline Hook 时,偶现随机崩溃。崩溃点发生于
mprotect调用内部。 - 根因溯源:
ARM64 设备的物理与虚拟内存页大小通常为 16 KB(0x4000)(注意:部分环境或早期系统存在 4 KB 页,绝不能写死,必须通过系统变量vm_page_size动态获取)。
目标函数的入口地址恰好位于代码段某内存页的尾部,距离页面边界仅剩 8 字节(例如0x100013FF8)。为了写入 12 字节的间接长跳转指令(adrp + add + br),写入操作跨越了两个内存页:- 前半部分位于
0x100010000 - 0x100013FFF(属于__TEXT代码段); - 后半部分落在了
0x100014000 - 0x100017FFF(属于紧邻的__DATA段)。
如果 Hook 引擎的页对齐算法仅仅对目标首地址执行掩码计算(target & ~(PAGE_SIZE - 1)),它只会解锁第一个页面的写权限,当向跨越边界的第二个页面写入第 3 条指令时,立即触发写保护硬件异常!
- 前半部分位于
- 铁律与避坑:
在实现自定义内存 Patch 或使用轻量级 Hook 库时,必须进行双页面重叠校验:uintptr_t start_page = target_addr & ~(PAGE_SIZE - 1); uintptr_t end_page = (target_addr + patch_size - 1) & ~(PAGE_SIZE - 1); // 若跨越了不同内存页,必须将涉及的两个页面权限一并修改 mprotect((void *)start_page, PAGE_SIZE, PROT_READ | PROT_WRITE); if (start_page != end_page) { mprotect((void *)end_page, PAGE_SIZE, PROT_READ | PROT_WRITE); }
7. 终极决策全景:主流开源 Hook 工具能力矩阵
经过多年社区演进,从早期的 Cydia Substrate 到最新的 ElleKit,iOS 工具链已经历了四代迭代。在实际项目选型时,我通常参照以下维度进行权衡:
| 框架 / 工具名称 | 核心拦截机理 | 支持目标层级 | ARM64e PAC 兼容策略 | 依赖环境与最佳适用场景 |
|---|---|---|---|---|
| Method Swizzling | ObjC Runtime SEL -> IMP |
仅 Objective-C | 完全免疫(纯运行时) | 业务层无侵入插桩、APM 打点 |
| fishhook | Mach-O GOT / Chained Fixups | 动态链接 C 符号 | 需适配 __auth_got 重签名 |
非越狱注入、MonkeyDev、通用 API 审计 |
| Dobby | ARM64 Inline 机器码重写 | 任意虚拟内存地址 | 近程 b 支持,远程受限 |
逆向分析、脱壳研究、私有函数 Patch |
| ElleKit | 动态 JIT 跳板 + 近邻内存探测 | 全层级统一封装 | 原生深度适配(Dopamine 标配) | Rootless 越狱生态、现代 Tweak 核心基板 |
| litehook | 轻量级分支跳转 + GOT 结合 | C 符号与地址层 | 有限支持 | 极小体积嵌入、不引入大依赖的专用项目 |
| hwbphook | ARM64 硬件调试断点寄存器 | 全层级(指令粒度) | 完全免疫(硬件上下文拦截) | 突破强内存哈希检测、反反调试攻坚 |
8. 总结与未来趋势展望
纵观 iOS 平台过去十五年的对抗历史,Hook 技术的演进轨迹实质上就是 Apple 底层安全架构逐步下沉的缩影:
- iOS 6 时代:聚焦在语言运行时,Method Swizzling 几乎无所不能;
- iOS 12 时代:指针级安全下沉至芯片物理层,PAC 的引入终结了无脑内存覆盖的粗暴时代;
- iOS 15 时代:链接器重构,dyld4 的 Chained Fixups 将原本离散的符号表转化为内存紧凑的链表拓扑;
- iOS 17 ~ iOS 18 时代:Exclave 独立安全飞地、SPTM(安全页面表监控)与纯 Swift 静态分发的普及,正在将可被劫持的攻击面进一步压缩进极小范围。
在现代逆向工程中,已经不存在放之四海皆准的银弹。唯有穿透编译链接、Mach-O 规范、AArch64 汇编以及芯片硬件特性的层层迷雾,看清目标指令在 CPU 流水线上的真实运转轨迹,才能在日益复杂的安全防线面前游刃有余。
原文链接与参考资料
- 原文讨论:iOS Hook 终极兵器库:九种拦截机制到硬件级 PAC 绕过的硬核指南 - 看雪安全社区
- fishhook 官方源码:facebook/fishhook - GitHub
- Dobby 跨平台 Hook 框架:jmpews/Dobby - GitHub
- ElleKit 现代 ARM64e Hook 引擎:tealbathingsuit/ElleKit - GitHub
- litehook 轻量级拦截库:opa334/litehook - GitHub
- Apple 开源系统内核源码:apple-oss-distributions/xnu - GitHub
- ARM 体系结构参考手册:ARM Architecture Reference Manual ARMv8, for ARMv8-A architecture profile - ARM Ltd.