
单任务狂吞 19 万 Token 的代价:从 Artificial Analysis 实测看 Claude Sonnet 5.5 的推理膨胀与 Agentic 成本陷阱
在 Anthropic 刚刚推送的 Claude 5.5 系列模型迭代中,Claude Sonnet 5.5 无疑成为了全行业瞩目的焦点。在官方给出的纸面规格与定价清单中,Sonnet 5.5 的输入与输出价格分别为每百万 Token 2 美元与 10 美元,不仅与 GPT-6 Sol 完全持平,更仅为老大哥 Opus 5.5 的一半;与此同时,官方宣称其推理速度提升了 30%,端到端运行成本降低 30%。更令开发者社群震动的是,在 Terminal-Bench 等权威 Agentic Coding(智能体编程)基准测试中,Sonnet 5.5 的综合得分甚至比 Opus 5.5 还要高出整整 4 分,“中杯越级斩杀超大杯”的讨论瞬间席卷了技术圈。
然而,当独立权威评测机构 Artificial Analysis 披露了其 Intelligence Index 的全维度测试数据后,隐藏在“便宜高分”背后的残酷真相终于浮出水面:Sonnet 5.5 之所以在高难度任务中实现逆袭,在很大程度上依赖了极其激进的 Test-Time Compute(测试期计算扩展)。在最高努力档位(max effort)下,Sonnet 5.5 单个任务平均狂吞高达 19.3 万 Token,其中内部思维链推理(Reasoning)占据了惊人的 14.2 万 Token!如果盲目开启 max 档位,表面上每 Token 便宜一半的 Sonnet 5.5,其实际单任务账单不仅追平了 Opus 5.5,更在相同智能水平的帕累托效率上严重倒挂。
一、纸面参数与实际消耗的巨大鸿沟
在评估大语言模型的性价比时,大多数开发团队和架构师往往容易陷入“单价思维”的惯性陷阱:只要输入/输出的标价便宜,该模型在生产环境中的总账单就必然更低。
以下是 Anthropic 官方给出的公开定价与特性对照:
| 模型规格 | 每百万输入 Token 单价 | 每百万输出 Token 单价 | 相对 Sonnet 5 速度 | 上下文窗口与最大输出 |
|---|---|---|---|---|
| Claude Sonnet 5.5 | 2 美元 | 10 美元 | 提升约 30% | 1M 上下文 / 128k 输出 |
| Claude Opus 5.5 | 4 美元 | 20 美元 | 基准基线 | 1M 上下文 / 128k 输出 |
| GPT-6 Sol | 2 美元 | 10 美元 | - | 1M 上下文 / 128k 输出 |
| GPT-6 Astra | 3 美元 | 15 美元 | - | 1M 上下文 / 128k 输出 |
从表面上看,Sonnet 5.5 的单价恰好是 Opus 5.5 的 50%,如果两者的能力相仿甚至 Sonnet 在编程场景中略微领先,那么全量切换到 Sonnet 5.5 似乎是板上钉钉的理智抉择。
然而,大模型由“单轮问答”走向“深层思维链 + 智能体自主循环(Agentic Loop)”之后,总成本的决定因子已经从单一的 “Token 单价” 彻底转变为 “Token 单价 × 实际输出 Token 消耗量”。
二、Artificial Analysis 实测:狂暴的 Token 膨胀
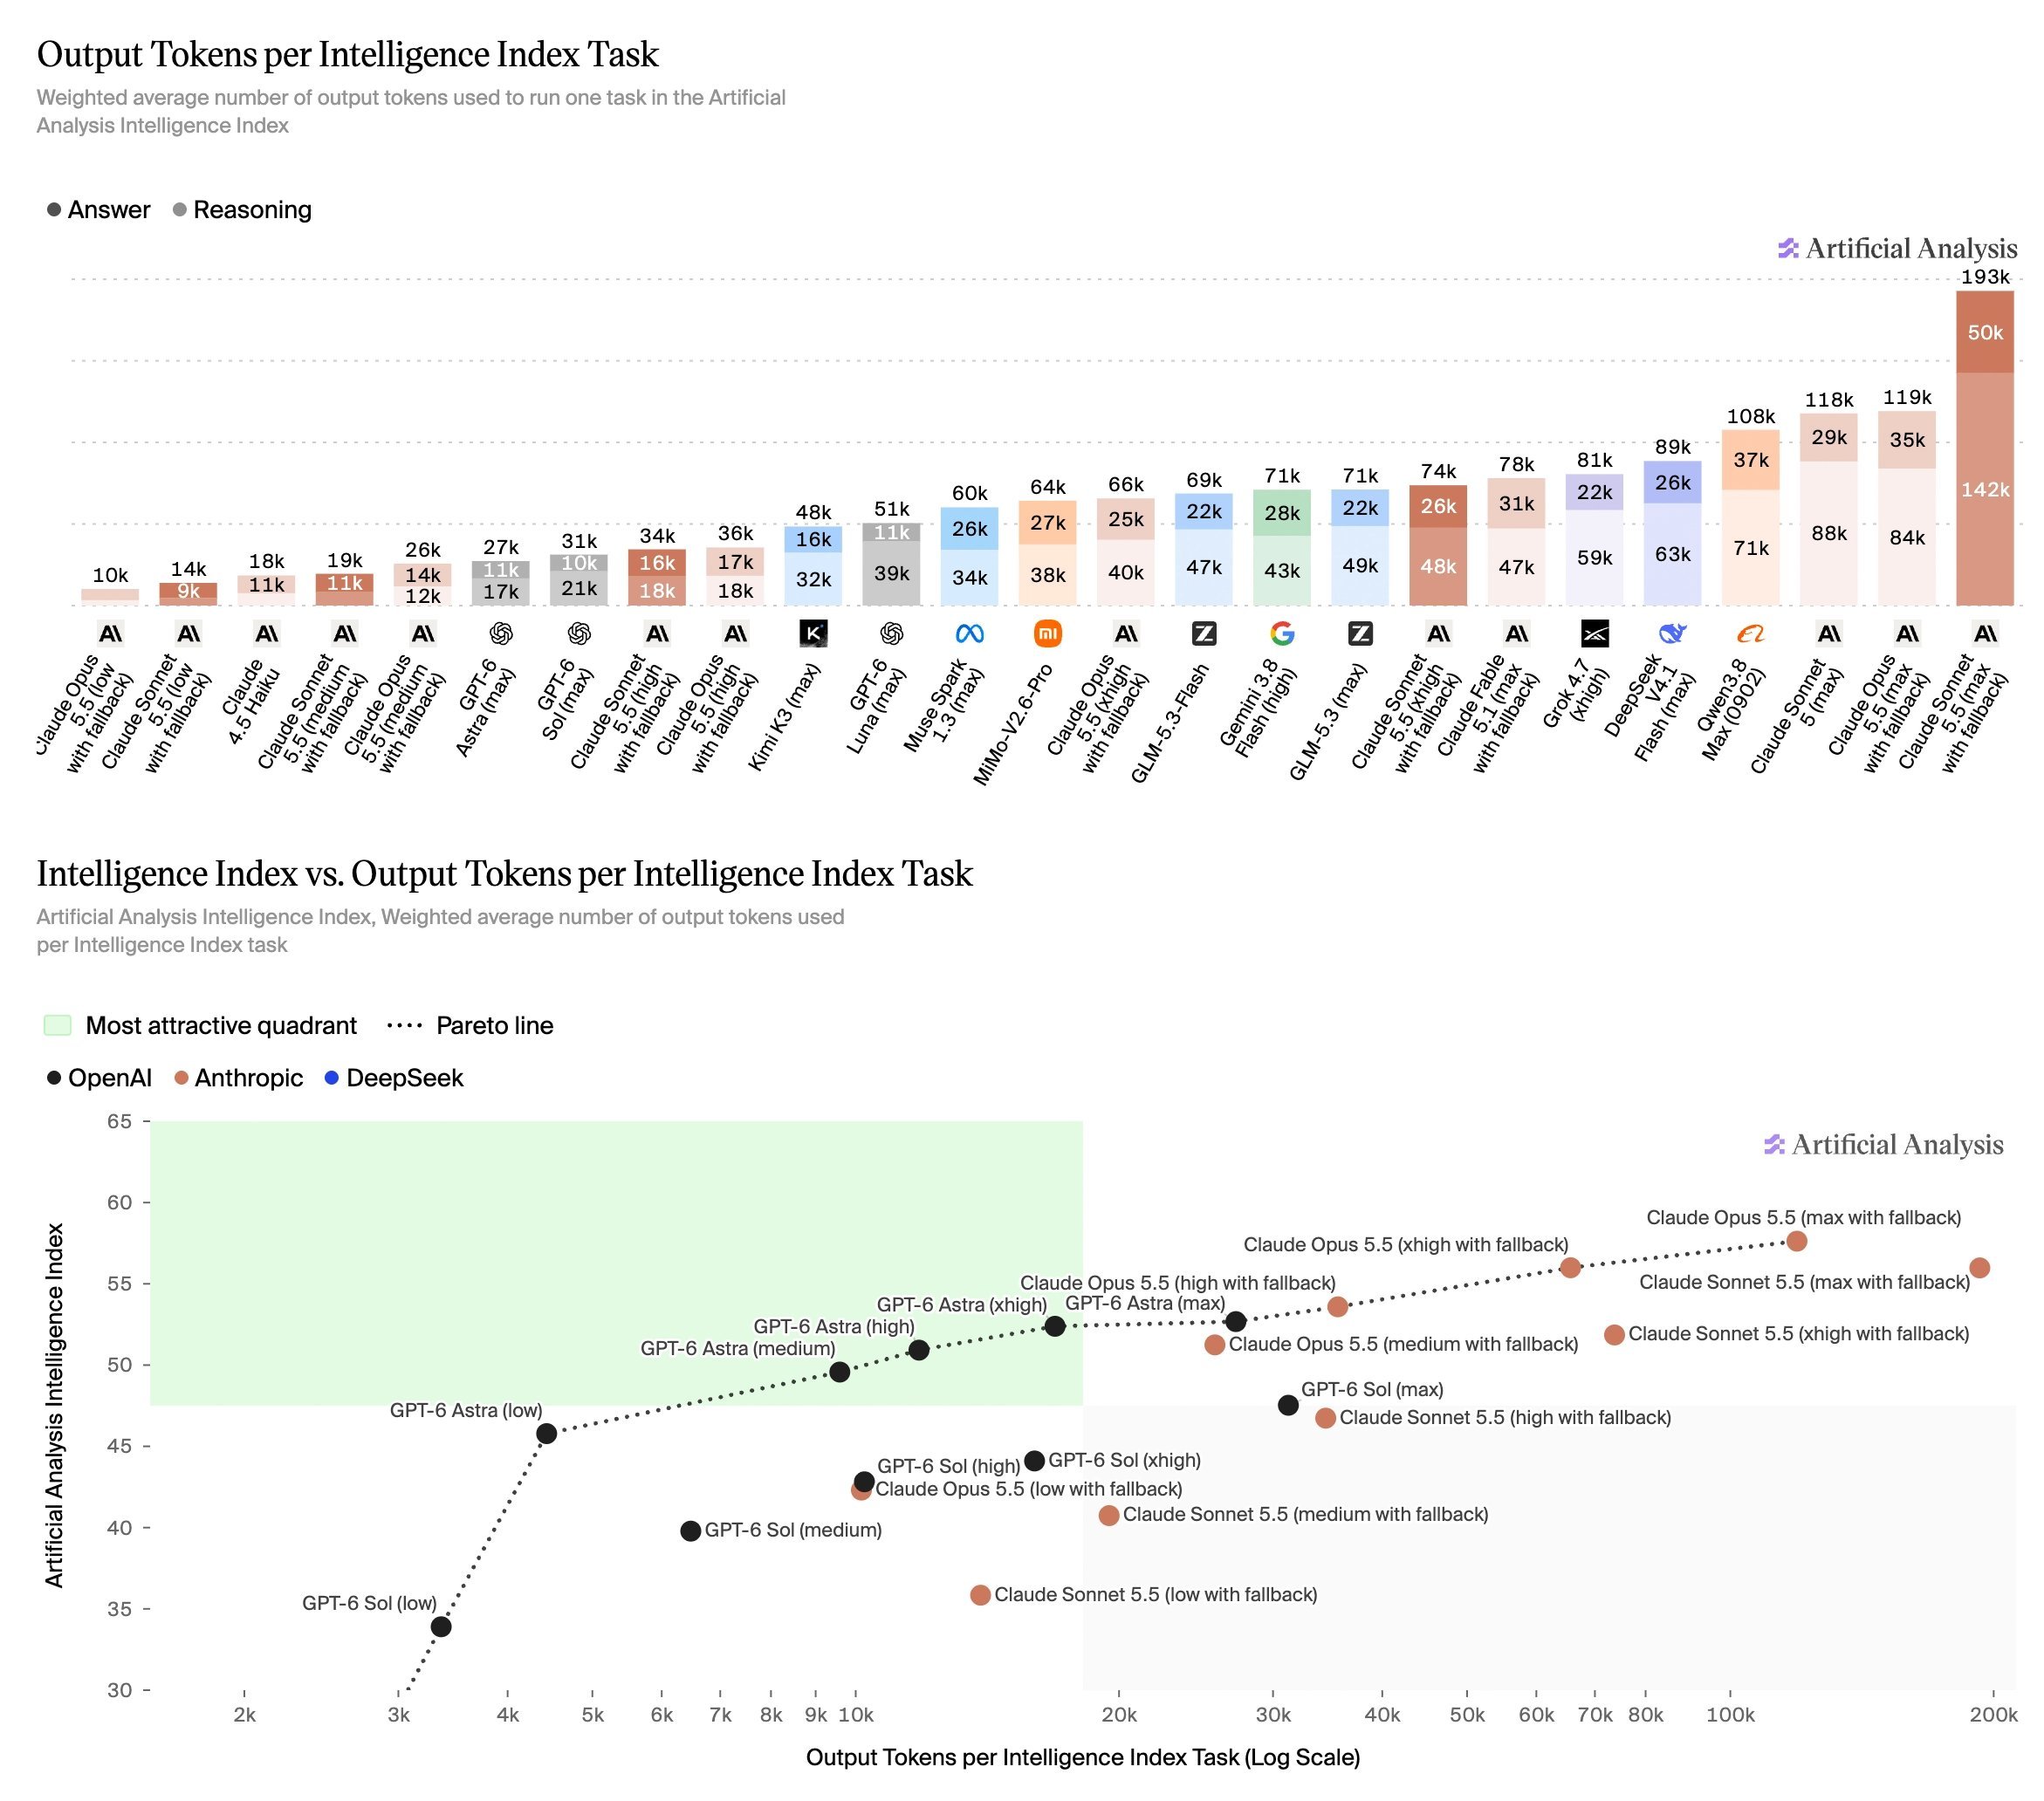
在 Artificial Analysis 公布的“Output Tokens per Intelligence Index Task”加权平均测试图表中,各家旗舰模型在不同 Effort Level(努力档位)下的 Token 真实消耗被完整拆解为两部分:最终回答(Answer)与 深层思考(Reasoning)。
我们可以清晰地看到 Sonnet 5.5 与 Opus 5.5 在不同档位下的对比曲线:
flowchart LR
    subgraph Sonnet["Claude Sonnet 5.5 消耗跃迁"]
        S_Low["Low: 14k Token<br/>(11k 思考 / 3k 回答)"] --> S_Med["Medium: 19k Token<br/>(11k 思考 / 8k 回答)"]
        S_Med --> S_High["High: 34k Token<br/>(18k 思考 / 16k 回答)"]
        S_High --> S_XHigh["xhigh: 74k Token<br/>(48k 思考 / 26k 回答)"]
        S_XHigh --> S_Max["max: 193k Token<br/>(142k 思考 / 50k 回答) 🔥"]
    end

    subgraph Opus["Claude Opus 5.5 消耗梯度"]
        O_Low["Low: 10k Token<br/>(9k 思考 / 1k 回答)"] --> O_Med["Medium: 26k Token<br/>(12k 思考 / 14k 回答)"]
        O_Med --> O_High["High: 36k Token<br/>(18k 思考 / 17k 回答)"]
        O_High --> O_XHigh["xhigh: 66k Token<br/>(40k 思考 / 25k 回答)"]
        O_XHigh --> O_Max["max: 119k Token<br/>(84k 思考 / 35k 回答)"]
    end
1. 令人窒息的 19.3 万 Token 峰值
在低到中等档位(Low、Medium、High)时,Sonnet 5.5 与 Opus 5.5 的输出规模基本相仿,均维持在 10k 至 36k Token 的合理区间内。
但一旦进入 xhigh 与 max 极限深思档位:
- Claude Opus 5.5(max):总输出为 11.9 万 Token(3.5 万回答 + 8.4 万思考);
- Claude Sonnet 5.5(max):总输出直接飙升到 19.3 万 Token(5.0 万回答 + 14.2 万思考)!
Sonnet 5.5 在 max 档位下的 Token 生成总量是其前代 Sonnet 5 的近 1.6 倍,更比同档位的 Opus 5.5 多消耗了 7.4 万个 Token(超出了 62% 的计算体量)。横向对比其他厂商旗舰,DeepSeek V4.1 Flash 在 max 下消耗为 89k,GLM-5.3(max)为 71k,GPT-6 Astra(max)仅为 27k。Sonnet 5.5(max)毫无悬念地登顶了全行业实测中最长、最臃肿的 Token 生成冠军。
2. 算力经济学账本算账:单价便宜,总账单反而翻车
我们根据两者的实际输出 Token 消耗与官方单价,计算单个 Intelligence Index 基准任务的实际输出费用:
| 模型档位配置 | 输出 Token 数量 | 官方输出单价 (每百万) | 单任务纯输出实际花费 |
|---|---|---|---|
| Claude Sonnet 5.5 (max) | 193,000 | 10 美元 | 1.93 美元 |
| Claude Opus 5.5 (max) | 119,000 | 20 美元 | 2.38 美元 |
| Claude Opus 5.5 (xhigh) | 66,000 | 20 美元 | 1.32 美元 |
| GPT-6 Astra (max) | 27,000 | 15 美元 | 0.405 美元 |
表面上看,Sonnet 5.5(max)花费 1.93 美元,略微低于 Opus 5.5(max)的 2.38 美元(节省了不到 19% 的费用,远未达到纸面上的 50% 优惠)。
但关键在于 智商产出比与帕累托前沿(Pareto Efficiency):
- 在 Artificial Analysis 的综合智能指数(Intelligence Index)坐标系中,Claude Sonnet 5.5(max)最终拿到了 56 分;
- 而 Claude Opus 5.5 在
xhigh档位下,同样拿到了 56 分!
这意味在交付完全同等智能水准的场景下:
- 使用 Sonnet 5.5 (max) 需要付出 1.93 美元 的输出成本;
- 使用 Opus 5.5 (xhigh) 仅仅需要 1.32 美元!
Sonnet 5.5(max)不仅没有帮你省钱,反而比 Opus 5.5(xhigh)贵出了整整 46%!
这就是典型的帕累托无效陷阱(Pareto-suboptimal):低单价的中型模型在被逼入极限推理区间时,不得不靠极端冗余的话痨式思考与试错来弥补单步抽象能力的短板,最终导致总算力账单的全面失控。
三、深层机理:为什么 Sonnet 5.5 在编程评测中能靠“堆 Token”逆袭?
为什么在 Agentic Coding(如 Terminal-Bench 4.0)中,Sonnet 5.5 能反超 Opus 5.5 获得更高的测评胜率?这背后的机制值得每一位 AI 架构师深思。
1. 智能体评测基准对“多试几轮”的天然偏好
Agentic Coding 的测试环境与传统的一次性生成代码(One-pass Generation)完全不同。在 Terminal-Bench 或 SWE-bench Verified 中,智能体拥有完整的 Bash 终端、文件读写权限与测试反馈通道。
智能体在遇到 Bug 时的解决路径通常呈现出树状探索特征:
sequenceDiagram
    autonumber
    participant Agent as Sonnet 5.5 (Max)
    participant Shell as 交互环境 (Bash / Test)
    participant Disk as 本地代码库

    Agent->>Disk: 读取跨模块调用栈
    Agent->>Agent: 深度思考:穷举假设 A / B / C(消耗 30k Token)
    Agent->>Shell: 执行单测 pytest -k test_core
    Shell-->>Agent: 报错:ImportError & TypeMismatch
    Agent->>Agent: 自纠错循环:重写 AST 补丁并反思(消耗 45k Token)
    Agent->>Disk: 写入第三轮修复代码
    Agent->>Shell: 重新运行单测
    Shell-->>Agent: 绿灯通过 (All Tests Passed)
    Agent->>Agent: 总结归档并提交 Patch(消耗 20k Token)
在 max effort 状态下,Sonnet 5.5 拥有极度充沛的 Token 预算。哪怕第一次猜想错误,它凭借 14.2 万 Token 的深思空间,会不断展开自我质疑、构建沙盒临时用例、输出详尽的代码推导过程,在环境中“反复撞墙而后自愈”。
在基准评测的标准下,过程消耗了多少 Token 并不扣分,只要最终单测跑通即算作成功。这造就了 Sonnet 5.5 在测试榜单上的“超常发挥”。
2. 知识压缩密度(Capacity Density)的本质差异
Opus 与 Sonnet 在模型体量和参数规模上存在先天的阶梯差异:
- Opus 5.5(高阶超大模型):具有极高密度的先验知识与抽象推理能力。其在单步逻辑推导中的“跳跃能力”和“直觉准确度”极高,常常能在 1~2 轮思考内精准命中核心根因,因此以较短的 Token 输出(8.4 万)即可完成收敛;
- Sonnet 5.5(中量级敏捷模型):基座参数的压缩抽象能力稍弱。为了达到同等的推导严密性,它必须采用极度详尽的白话自言自语(Step-by-step CoT)来弥补单步跳跃能力的不足。当设置了 max 努力程度时,系统 prompt 和推理机制逼迫其全力思考,模型便会陷入反复自我辩解、生成大量冗余中间推演代码的“思维反刍”状态。
著名 AI 博主歸藏(@op7418)在推文中直言:“Sonnet 5.5 在 max 努力程度下,同样任务的花费金额比 Opus 5.5 还要高得多,快要持平甚至反超了,这可能就是它得分高的原因。所以大家在用 Opus 5.5 或者 Sonnet 5.5 的时候千万别开 max:在一些复杂任务上,它有可能跑出非常贵的价格,几乎赶上 Claude Fable 5.1 了。”
四、工程落地最佳实践:如何精准驾驭 Effort 档位?
面对 Sonnet 5.5 与 Opus 5.5 的全新特性,开发团队绝不能再采用“一把梭默认全开”的粗放配置策略。针对 Agentic Coding 与企业级 LLM 架构,建议落地以下三项工程化约束:
1. 严格封禁全局 Max 努力档位,将 Medium/High 作为默认生产基线
在绝大多数日常工程场景(代码审查、单文件重构、单元测试生成、API 接口编写)中,Sonnet 5.5 在 medium 档位下仅消耗约 19k Token,在 high 档位下消耗约 34k Token,能够以极低成本和 30% 的速度优势快速交卷。
只有当特定任务进入“高危紧急修复”或“自动化失败二次重试”阶段,才允许通过自适应策略临时提升到 xhigh。将 max 努力档位从生产环境的常规选项中移除,避免因异常代码死循环导致账单雪崩。
2. 构建“双引擎分层协作架构”(Orchestrator-Worker Architecture)
避免单一模型统包整套复杂开发工作流,采用大小模型分工互补的策略:
flowchart TD
    Task[复杂跨仓库重构任务] --> Planner[L1 架构规划与决策: Opus 5.5<br/>档位: High<br/>特点: 单步压缩率高, 洞察深, 杜绝试错方向偏航]
    Planner --> SubTask1[模块 A 接口改造]
    Planner --> SubTask2[模块 B 单测编写]
    Planner --> SubTask3[模块 C 依赖升级]

    SubTask1 --> Worker1[L2 确定性执行: Sonnet 5.5<br/>档位: Medium<br/>特点: 极速, 10 美元单价, 严格受限步数]
    SubTask2 --> Worker2[L2 确定性执行: Sonnet 5.5<br/>档位: Medium]
    SubTask3 --> Worker3[L2 确定性执行: Sonnet 5.5<br/>档位: Medium]

    Worker1 --> Merge[汇聚校验]
    Worker2 --> Merge
    Worker3 --> Merge
    Merge --> Final[合并交付]
- L1 架构规划层(Orchestrator):使用 Claude Opus 5.5(配置为
medium或high档位)。让参数底蕴更强的大模型完成系统设计、根因排查与子任务拆解,用最小的 Token 冗余换取 100% 准确的技术路线; - L2 执行交付层(Worker):使用 Claude Sonnet 5.5(配置为
medium档位)。在明确的上下文和范围约束下,让高吞吐、低单价的 Sonnet 快速生成代码、运行测试。
3. 在 Agent 调度层接入“Token 熔断与边际衰减监控”
在基于 Anthropic API 开发自主智能体(如 Coding Agent、CLI Tool)时,必须在客户端 SDK 层面实现动态熔断机制:
# Agent Token 消耗熔断器伪代码示例
class AgenticExecutionBudget:
    def __init__(self, max_reasoning_tokens=50_000, max_cost_usd=1.0):
        self.max_reasoning_tokens = max_reasoning_tokens
        self.max_cost_usd = max_cost_usd
        self.accumulated_cost = 0.0

    def check_pre_flight(self, step_count: int, accumulated_reasoning: int):
        if accumulated_reasoning > self.max_reasoning_tokens:
            # 强行截断当前过载的思维链,要求模型输出当前最佳折中方案并请求工程师介入
            return "FORCE_SYNTHESIS_AND_HALT"
        if self.accumulated_cost >= self.max_cost_usd:
            raise BudgetExceededException("单任务花费触及熔断红线,已自动保护")
当模型内部推理 Token 超过特定阈值(如 5 万 Token)且仍未触发工具调用时,及时介入中断或调整 prompt,防止模型在死胡同内无休止地通过“话痨推理”吞噬企业预算。
五、总结
Claude Sonnet 5.5 的发布无疑代表了中型模型在速度、工程适配与上下文窗口上的又一次重大飞跃;但 Artificial Analysis 的实测数据也给整个业界敲响了一记警钟:千万不要让 “单价幻觉” 掩盖了 “消耗真相”。
在复杂长程推理时代,评测基准上的高分很可能只是模型“用算力狂刷尝试”的副产物。在真实的生产研发流水线中,合理选型、审慎配置 Effort 档位、建立健全的算力经济学监控体系,远比盲目迷信单一排行榜分数更有决定性价值。
原文链接与参考资料
- 原文出处(X / 歸藏 @op7418):歸藏关于 Sonnet 5.5 与 Opus 5.5 性能、定价及 Token 消耗评测的推文分析
- 数据评测机构:Artificial Analysis - Claude Sonnet 5.5 Benchmarks & Intelligence Index
- Anthropic 官方文档:Claude Models & Pricing Documentation