
把长文沉淀为可复用视觉资产:解构 cc2image 的认知锚点拆图、49套风格矩阵与交互选型门禁
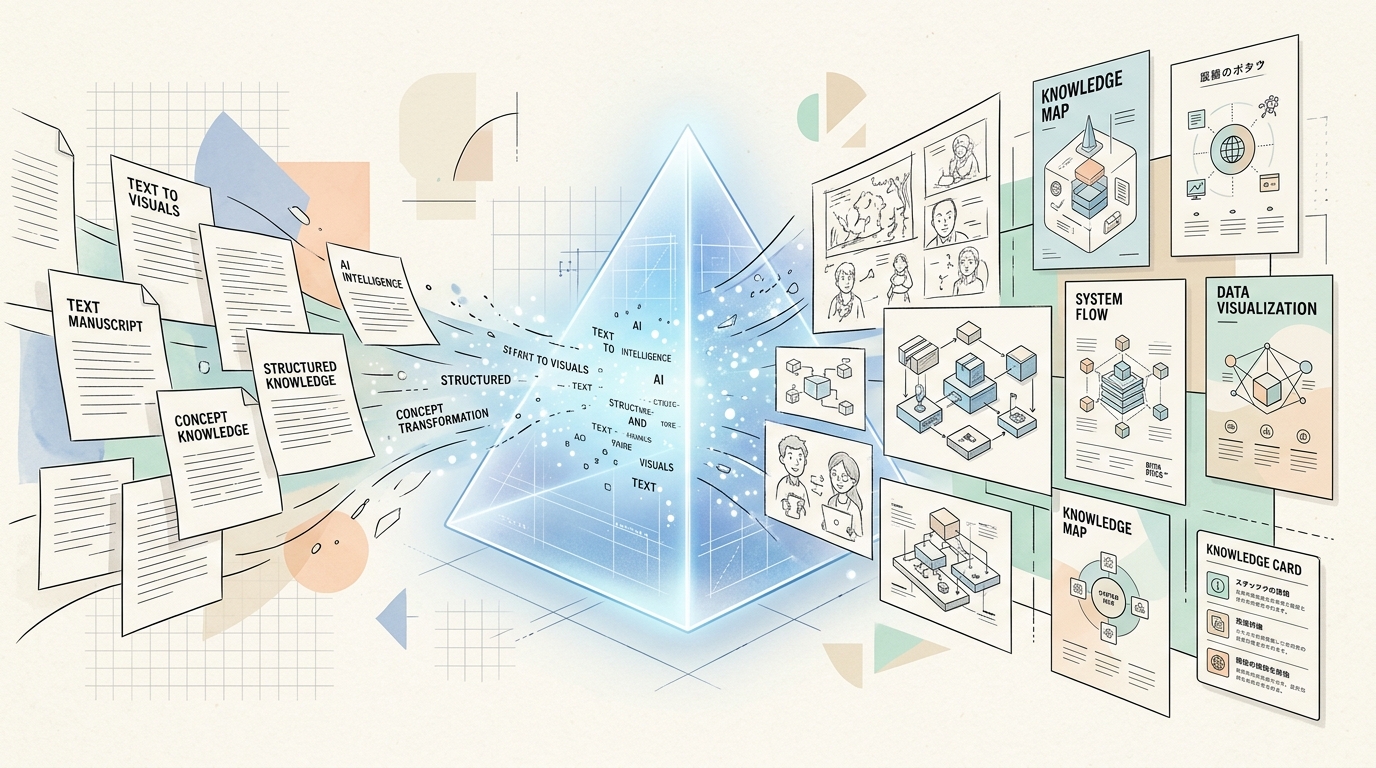
许多内容创作者和技术博主在尝试用大模型或 AI Agent 配图时,几乎都会陷入一种“审美混沌”:把一整篇几千字的长文直接扔给模型,得到的结果要么是每隔几百字机械塞入一张图文无关的泛滥二次元插图;要么是充斥着大面积荧光蓝紫、假大空宇航员和漂浮晶体的企业宣传画;更有甚者,Agent 会在后台自作主张消耗宝贵的出图配额,连环生成毫无逻辑关联的低质图片,最终只能全盘废弃。
开源项目 cc2image(GitHub: izscc/cc2image)给出了一个截然不同的解题思路:它不做单一、死板的“生图提示词套模板”,而是构建了一套面向专业中文内容生产的交互式视觉操作系统。它将长文阅读理解、认知锚点(Cognitive Anchors)拆解、基于 Web 插件的可视化交互选型门禁、49 套专业内容视觉语言与 8 套图标系统深度耦合,彻底将不可控的“盲盒生图”转变为流程确定、层级清晰、具备长期复用价值的内容视觉工程。
一、传统 AI 配图的“盲盒困境”与认知断层
在通用 Agent 介入内容创作的今天,为什么绝大多数自动化配图方案依然无法直接用于严肃的内容出版或深度博客?核心在于传统工作流中存在四个致命断层:
flowchart TD
    subgraph TraditionalChaos ["传统 AI 配图的失控现状"]
        C1["机械的段落平均主义<br/>(每 N 个段落硬塞一张图,忽视逻辑重点)"]
        C2["美学风格严重漂移<br/>(封面是二次元,正文变 3D 渲染,插图变低质 PPT)"]
        C3["黑盒自治与配额滥用<br/>(未经用户确认即开始批量出图,无法撤回)"]
        C4["孤立单图缺乏资产感<br/>(单次生成无法沉淀为成套品牌视觉系统)"]
    end

    subgraph CC2ImageParadigm ["cc2image 视觉工程范式"]
        S1["认知锚点拆图模型<br/>(抓核心判断、认知断点、输入输出闭环与分流)"]
        S2["49+8 套标准化风格矩阵<br/>(从手绘知识风到时间微缩,统一视觉语义)"]
        S3["可视化交互选型门禁<br/>(强制弹窗确认,回传结构化配置才准出图)"]
        S4["Kashika 可视化方法论<br/>(5 级解释度、7 轴质量审计、长期复用资产)"]
    end

    C1 ==> S1
    C2 ==> S2
    C3 ==> S3
    C4 ==> S4

    style TraditionalChaos fill:#ffebee,stroke:#c62828,stroke-width:2px;
    style CC2ImageParadigm fill:#e8f5e9,stroke:#2e7d32,stroke-width:2px;
- 机械的段落平均主义:常规 Agent 的提示词往往指示“阅读全文并为每个章节生成配图”。然而,并不是所有文字都需要视觉化,平铺直叙的背景铺垫配图只会增加读者的视觉疲劳;真正需要配图的,往往是那些反直觉的核心判断、算法内部的数据流转、复杂决策树的分支以及容易踩坑的边界条件;
- 美学风格的无序漂移:没有严格受控的视觉风格字典,模型会在“写实摄影”、“粘土 3D”、“扁平矢量”和“日系水彩”之间随机跳跃。整篇文章拼凑下来,毫无排版呼吸感和品牌一致性;
- 过度自治引发的决策失控:很多基于 Tool Call 的 Agent 在理解文章后,直接一次性并发向生图 API 发出十几个出图请求。用户未曾过目风格,甚至连出图比例和张数都未确认,整个会话就被海量生成的不可逆图片刷屏;
- 缺乏长期资产意识:配图不只是当下的装饰,更是创作者或企业视觉资产的延伸。缺乏角色连续性、版面规范与信息密度梯度的散图,无法二次复用或形成系列感。
为了彻底破解这些顽疾,cc2image 将视觉设计学中的成熟经验编码为可执行的 Agent 规范。
二、拆图的本质是信息提纯:认知锚点(Cognitive Anchors)工程学
cc2image 的核心第一步不是生成 Prompt,而是“拆图”。它在规范中明确提出:绝不平均按段落配图,而是优先抓取文章的核心认知锚点。
flowchart LR
    subgraph InputText ["原始长文输入"]
        RAW["万字技术分析 / 架构长文"]
    end

    subgraph Extraction ["Step 1: 认知锚点提取"]
        A1["核心判断 (Core Judgment)"]
        A2["认知断点 (Cognitive Break)"]
        A3["输入输出闭环 (I/O Loop)"]
        A4["分流判断 (Branching)"]
        A5["前后对比 (Before/After)"]
        A6["承接路径 (Handoff Path)"]
        A7["常见坑点 (Common Pitfalls)"]
        A8["角色状态演化 (State Transition)"]
    end

    subgraph VisualMapping ["Step 2: 视觉结构映射"]
        M0["封面:总览隐喻与判断句"]
        M1["正文:闭环机制图"]
        M2["正文:横向流程 / 泳道图"]
        M3["正文:分类树 / 分层架构图"]
        M4["正文:左右对比 / 避坑图"]
        M5["正文:物理结构类比图"]
    end

    InputText --> Extraction
    A1 --> M0
    A2 & A7 --> M4
    A3 --> M1
    A4 & A6 --> M2
    A5 --> M4
    A8 --> M5

    classDef in fill:#f3e5f5,stroke:#7b1fa2,stroke-width:2px;
    classDef ext fill:#e3f2fd,stroke:#1565c0,stroke-width:2px;
    classDef vis fill:#e8f5e9,stroke:#2e7d32,stroke-width:2px;

    class InputText,RAW in;
    class Extraction,A1,A2,A3,A4,A5,A6,A7,A8 ext;
    class VisualMapping,M0,M1,M2,M3,M4,M5 vis;
1. 8 类核心认知锚点定义
在 cc2image 的工作流中,分析引擎会过滤掉所有不适合画图、更适合纯文字描述的琐碎段落,只在以下 8 种高价值认知交界面上落笔:
| 认知锚点 | 核心心理预期 | 典型视觉表达形式 |
|---|---|---|
| 核心判断 | 一句能颠覆或重构读者现有认知的关键结论 | 21:9 宽屏封面、醒目大字、左文右图强隐喻 |
| 认知断点 | 传统做法为何突然失效?旧范式与新范式的交界处 | 左右分栏对比、断裂桥梁、破损齿轮隐喻 |
| 输入输出闭环 | 数据、资产或指令如何经过流水线并最终闭环 | 环形闭环图、传送带循环、自我反哺机制图 |
| 分流判断 | 面对不同边界条件,系统如何做出分流决策 | 树状分流、多路道岔、条件漏斗 |
| 前后对比 | 从手动到全自动、从混乱失控到规范有序 | 强对比双栏图、双色调红绿对照 |
| 承接路径 | 异常情况或中间产物如何被下游平稳接住 | 承接漏斗、弹簧安全网、分级缓冲区 |
| 常见坑点 | 开发者实操中最容易忽略的隐藏暗礁 | 带有警告标识的断崖、危险分支红线标注 |
| 角色状态演化 | 操作者/用户从迷茫到精通的心智模型转变 | 阶段递进台阶、人物状态变化小漫画分镜 |
2. 精确到 Shot List 的策略预构
每一张正文图在渲染提示词前,必须先在内部生成一份结构严密的策略清单(Shot List):
- 放置位置:位于“架构分层”章节后
- 题图名称:从请求路由到证据链固化的生命周期
- 核心意思:解释 Agent 如何在 Scope 守卫拦截下完成只读探测与合规提权
- 认知锚点:输入输出闭环 + 分流判断
- 结构类型:横向泳道与分级门禁机制
- 视觉隐喻:安检通道与带有机械卡槽的密码箱
- 主体动作:小黑操作员手持放大镜对数据包执行哈希比对
- 画面元素:待验数据流、Scope 闸机、合规认证印章、不可变证据库
- 中文短标注:[入口流量] [Scope 校验] [SHA-256 固化] [合规归档]
- 为什么需要这张图:消除读者对“未授权发包”这一黑盒环节的安全疑虑
这种“先结构化策略,后拼装提示词”的机制,从源头上杜绝了模型随意天马行空造成的画面跑题。
三、强制风格门禁:让 AI 停止自作主张的“交互选型协议”
在大部分智能体框架中,Agent 倾向于“单向盲跑到底”。但在专业设计领域,没有人能够仅凭一句话就 100% 猜中客户心中满意的视觉调性。
cc2image 设立了整套系统中最严苛的防线:强制风格门禁(Mandatory Style Gatekeeper)。
sequenceDiagram
    autonumber
    actor User as 用户 / 内容创作者
    participant Agent as AI Coding Agent (Codex / Claude)
    participant Builder as build_selector.py 确定性构建器
    participant UI as Visualize 内联交互选择器
    participant ImageGen as 图像生成核 (image_gen)

    User->>Agent: "帮我把这篇万字系统架构文章配一套图"
    Note over Agent: 触发门禁检查:用户未指定有效 style_id!

    rect rgb(255, 243, 224)
        Note over Agent, Builder: 阶段一:极速首显(毫秒级构建)
        Agent->>Agent: 分析文章,计算 TOP 3 推荐风格与正文推荐张数
        Agent->>Builder: 管道传入 JSON 配置 (无需启动浏览器或子代理)
        Builder-->>Agent: 输出预校验的轻量 HTML Fragment (包含 Base64 真实缩略图)
        Agent-->>User: 渲染 ::codex-inline-vis{file="selector.html"} 并立即结束当前轮!
        Note over Agent: 本轮严禁调用 image_gen,严禁直接出图!
    end

    rect rgb(232, 245, 233)
        Note over User, UI: 阶段二:用户可视化决策
        User->>UI: 点击切换风格、微调封面比例 (21:9)、滑动正文数量 (5张)
        User->>UI: 点击“使用此配置继续”
        UI-->>Agent: window.openai.sendFollowUpMessage(CC2IMAGE_SELECTION_V1)
    end

    rect rgb(240, 248, 255)
        Note over Agent, ImageGen: 阶段三:受控批量出图
        Agent->>Agent: 解析并校验 CC2IMAGE_SELECTION_V1 配置块
        Agent->>ImageGen: 逐张按稳定提示词模板调用生图 API
        ImageGen-->>User: 交付高质量、成套风格统一的视觉资产
    end
1. 为什么“帮我选/直接生成”都不能跳过门禁?
在 SKILL.md 中,门禁规则被赋予了高于一切的优先级:
- 即使用户说“用合适的风格”、“帮我选”、“随机风格”、“直接生成”、“用默认值”、“不用问我”,也绝不算明确指定风格,必须无条件触发选择器;
- 只有且仅有两类情况允许放行:
- 用户在最初的指令中明确写出了风格库里的有效中文风格名(如“用典籍山水风做封面”)或合法的
style_id; - 消息体中已包含由前端界面回传的
CC2IMAGE_SELECTION_V1结构化配置块。
- 用户在最初的指令中明确写出了风格库里的有效中文风格名(如“用典籍山水风做封面”)或合法的
2. 首显性能预算:拒绝动态编写 HTML 的陷阱
很多尝试过让 Agent 渲染 Web UI 的开发者都会遇到一个痛点:Agent 每次都要现场写几百行 HTML/CSS,启动 Playwright 截图,甚至唤醒子代理进行审美评估,耗时 30 秒以上,极易崩溃。
cc2image 采用了极度克制的 首显快速路径(First-paint Performance Budget):
- 禁止现场写代码:运行时直接以管道方式执行预校验好的确定性脚本
scripts/build_selector.py; - 动态内容隔离:Agent 只向脚本的
stdin发送一行极简 JSON:{"recommend":["monochrome_system_editorial","handdrawn_knowledge_card","isometric_timeline_miniature"],"body_count":5,"cover_enabled":true,"icon_mode":false} - 内联嵌入真实资产:脚本从
references/style_example_assets.json索引中提取真实 16:9 缩略图,转换并内联为 Base64,严格确保 fragment 体积小于 2 MB,绝不用抽象的 SVG 或 Emoji 色块充数; - 零子代理开销:首显前严禁启动子代理,把宝贵的并行推理算力留给用户完成选择后的批量出图环节。
四、风格矩阵:49 套视觉语言与 8 套 Logo 模式的设计哲学
cc2image 的核心底蕴在于其沉淀的视觉风格库。它打破了单一模板的局限,建立了横跨 8 大维度的风格矩阵:
mindmap
  root((cc2image 风格库))
    A. 知识图解类
      handdrawn_knowledge_card(手绘知识风 - 默认图解王牌)
      study_note_card(学习笔记风)
      pastel_learning_pyramid(粉彩金字塔风)
      childlike_cultural_infographic(童趣科普风)
    B. 东方与人文情绪
      oriental_editorial_illustration(典籍山水风 - 高端文化封面)
      zen_ink_philosophy_poster(禅意水墨风)
      frosted_glass_editorial(磨砂情绪风)
      black_void_glowing_hands(黑场肢体风)
    C. 极简设计与材质
      white_mono_texture_editorial(白色肌理风)
      minimal_architecture_portfolio(建筑线稿风)
      retro_minimal_poster_illustration(复古海报风)
      torn_paper_note_minimal(撕纸便签风)
    D. 语义材质与大字
      semantic_material_typography(语义字体风 - 依据词义造材质)
      giant_chinese_concept_poster(大字海报风)
      glyph_object_imagery(字物意象风)
    E. 拼贴与手工质感
      embroidered_patch_brand(刺绣徽章风)
      fabric_micro_scene_ad(布料微缩风)
    F. 微缩场景与商业
      isometric_timeline_miniature(时间微缩风 - 技术演化史)
      miniature_map_life_scene(微缩地图风)
      premium_product_ad_poster(产品海报风)
    G. 空间系统与角色
      isometric_modular_system(轴测模块系统风)
      monochrome_system_editorial(黑白系统风 - SOP/工作流手册)
      quirky_doodle_character_flow(怪诞小人风 - 小黑操作员)
      scribble_furball_character_family(毛球角色家族风 - 乱线团小黄围巾)
    H. 8套专业Logo模式
      cute_3d_plastic_icon(3D 新拟物图标)
      candy_glass_3d_icon(糖果玻璃图标)
      frosted_glass_ui_icon(磨砂玻璃 UI)
      circular_2_5d_vector_icon(圆形轻拟物矢量)
1. 语义字体风(Semantic Material Typography):字即其物
在以往的生图实践中,文字与背景材质通常是割裂的。cc2image 提出了“依词造质”的语义映射法则:
flowchart LR
    Word["分析输入词汇的语义属性"]

    Word -->|"稳固 / 底座 / 基础"| M1["木纹、花岗岩、清水混凝土、铸铁钉"]
    Word -->|"增长 / 孵化 / 复利"| M2["活体苔藓、胚芽种子、藤蔓脉络、湿润土壤"]
    Word -->|"脆弱 / 虚妄 / 泡沫"| M3["烟雾、流沙微粒、碎裂薄玻璃、浮尘"]
    Word -->|"系统 / 自动化 / 架构"| M4["精密机械齿轮、黄铜连杆、印刷电路板"]
    Word -->|"情感 / 信任 / 羁绊"| M5["手工棉麻、粗线刺绣、真皮压纹、传统火漆"]

    classDef word fill:#ede7f6,stroke:#512da8,stroke-width:2px;
    classDef mat fill:#e0f2f1,stroke:#00796b,stroke-width:2px;

    class Word word;
    class M1,M2,M3,M4,M5 mat;
这种设计使得封面上的每一个汉字都自带强烈的物理隐喻,让技术概念直接以实体质感直击读者感官。
2. IP 级连续性硬约束:以“怪诞小人”与“毛球家族”为例
在多张正文图解中,读者需要一个连续的角色来建立代入感。然而,普通生图工具每次都会生成完全不同的人物。cc2image 通过对提示词的极端收敛,确保了跨多张配图的角色一致性:
- 怪诞小人风(
quirky_doodle_character_flow):- 固定主角名为“小黑”;
- 外形特征严格收敛为:纯黑色实心不规则躯干、双白点眼睛、极细单线四肢、空洞漠然但专注的冷幽默表情,形如一个尽职尽责的低调底层系统操作员;
- 核心动作法则:小黑必须处于“拉、扛、塞、捞、压、拧、守、修”等具体的劳动状态中,绝不能无所事事地站在角落当花瓶;如果一张图把小黑移除后隐喻依然不受影响,该 Prompt 会被判定为不合格并强制重写;
- 毛球角色家族风(
scribble_furball_character_family):- 身体必须是中等密度的乱线团(中心密外缘松、白底微透);
- 面部固定为两只紧密贴合的纵向巨大椭圆白眼与黑瞳孔;
- 标志性配饰硬性绑定:每一个角色都必须佩戴同款横向包裹下半身的明黄色长围巾,且右侧垂下一条流苏尾。状态变体只允许更改动作与瞳孔方向,绝不允许变更 IP 原型。
五、可视化研究所(Kashika Method)与工业化提示词中枢
cc2image 借鉴了日本可视化研究所(Kashika Institute)的高级设计哲学:先把文字变成可被理解的结构,再把结构变成有温度、低认知负担的视觉语言。
flowchart TD
    subgraph KashikaPipeline ["可视化研究所的四阶递进"]
        P1["1. 语言整理<br/>(从原文中抽取要约,重写给目标读者)"]
        P2["2. 信息密度控制<br/>(判定 Explanation Level 1~5)"]
        P3["3. 空间与角色转译<br/>(轴测三面分工 + 隐喻物理化)"]
        P4["4. 7 轴质量评估<br/>(审计品牌调性与复用性)"]
    end

    subgraph PromptEngine ["scripts/prompt_schema.py 工业化装配"]
        A1["Style Anchor (风格基石锚点)"]
        A2["Composition Template (构图版式模板)"]
        A3["Negative Restraints (负向硬性隔离)"]
    end

    P1 --> P2 --> P3 --> P4
    P4 ==> PromptEngine
    PromptEngine --> FinalPrompt["终道高抗扰提示词"]

    style KashikaPipeline fill:#f9fbe7,stroke:#827717,stroke-width:2px;
    style PromptEngine fill:#e1f5fe,stroke:#0288d1,stroke-width:2px;
1. 5 级解释度(Explanation Level)动态调节
复杂的配图在生成前,系统会根据读者层级自动评估解释度责任:
Level 5: 图解型(严谨手册、技术规范,要求极低变形度与最高事实精度)
Level 4: 夸张型(核心博客封面,放大关键特征与核心隐喻,增强视觉吸引力)
Level 3: 场景型(案例推演,补充前后情境,适合故事板与服务链路图)
Level 2: 隐喻型(轻量随笔,弱化具体参数,强化直觉共鸣)
Level 1: 世界观型(品牌概念海报与书封,解释责任降至最低,追求留白与氛围余韵)
2. 轴测系统风的三面分工模型
当遇到复杂的微服务架构、SaaS 数据管线或系统演化图时,cc2image 启用 isometric_modular_system(轴测模块系统风),严格遵循三面信息分工:
- 顶面(Top Plane):承载水平方向的业务流转、地图路线与平面连接拓扑;
- 侧面(Side Planes):承载模块的层级深度、性能厚度、运行状态与存储容量;
- 正向文字(Frontal Labels):所有标题、数据指标与中文标注必须以正视平面的形式贴合,坚决避免文字跟随斜轴产生不可读的扭曲透视。
3. 工具隔离与负向提示词的“防伪造工程”
在工程安全性上,cc2image 建立了清晰的红线隔离:
- 只认
image_gen:直接生图只能调用受信的image_gen工具。若当前环境未配置出图工具,Agent 会严谨输出结构化 JSON 或 Markdown 提示词清单,绝对禁止使用本地 Python Pillow 脚本画几根丑陋的折线图、或调用 Headless Chrome 截取 Canvas 画面来冒充生成结果; - 强力负向过滤墙:在风格锚点中强行注入隔离词:
严禁做成低质商务 PPT、严禁课程软件画风、严禁 3D 浮夸塑料风、严禁高饱和霓虹光效、严禁英文乱码与水印。
六、实战拆解:一篇高并发系统文章的拆图全貌
为了直观体会 cc2image 的工业化拆图能力,我们以一篇探讨“分布式缓存一致性与穿透防护”的技术长文为例,展示其生成的 Shot List 与最终交付结构。
1. 生成的 Markdown 拆图策略规划
文章核心主题:分布式缓存与数据库的双写一致性保障及穿透防御
目标读者:资深后端架构师与系统研发工程师
系列视觉定位:黑白高对比系统风(monochrome_system_editorial)
建议图片数量:1 张 21:9 封面图 + 3 张 16:9 正文配图

---
图 1|封面图
主题:高并发下的缓存一致性困局
副标题:从旁路缓存到分布式事务的确定性演化
核心隐喻:高速飞驰的机械双轨与精密齿轮离合器
画面元素:左侧超大版式中文标题;右侧极简黑色机械双轨,小黑操作员手持信号扳手正在扳动轨道道岔
小人动作:正在精准卡位关键道岔,避免轨道脱轨
小人气泡:“双写不是并发,时序才是核心。”
底部判断句:一致性的代价永远是延迟,架构师的职责是在妥协中锁定确定性。

---
图 2|正文配图(认知断点:Cache-Aside 的并发时序死锁)
题图:读写交错下的脏数据回写陷阱
结构:左右对比与时序分流图
核心模块:[应用线程 A/B] [Redis 内存池] [MySQL 存储引擎] [版本号时间戳校验]
必要注释:写线程先删缓存、读线程并发查库、旧数据反向覆盖缓存
小人动作:小黑试图推走一个即将被错误写入的陈旧数据箱
小人气泡:“旧版本即将覆盖新数据!”
底部判断句:不加分布式锁或延迟双删的 Cache-Aside 在万级 QPS 下必定发生状态坍塌。

---
图 3|正文配图(闭环机制:基于 Binlog 异步订阅的最终一致性)
题图:基于 Canal/Kafka 的解耦补偿闭环
结构:单向环形闭环与缓冲池
核心模块:[Binlog 监听器] [消息队列削峰] [幂等消费重试] [缓存强制驱逐]
必要注释:业务线程无需感知缓存、消费失败自动进入死信重试、最终收敛
小人动作:小黑手持记事本坐在消息管道出口,盖上“已同步”印章
小人气泡:“把业务从双写的泥潭中解放出来。”
底部判断句:解耦双写链路,让底层存储的物理日志成为唯一的系统事实源。
2. 导出的程序化批量 JSON 清单
当需要将拆图任务下发给无交互后台流水线时,系统可直接输出符合工业标准的批量定义:
{
  "series_title": "分布式缓存架构深度实践",
  "visual_style": "monochrome_system_editorial",
  "global_style_prompt": "整体风格为黑白系统风:纯白或极浅冷灰底色,极细黑色技术线稿,极简高对比,充满工程严谨感。大量留白,瑞士平面排版,克制精致。不要 PPT 质感,不要 3D 浮夸塑料,不要高饱和,不要杂乱乱码。",
  "images": [
    {
      "id": "cover_01",
      "type": "cover",
      "aspect_ratio": "21:9",
      "style_id": "monochrome_system_editorial",
      "title": "高并发下的缓存一致性困局",
      "subtitle": "从旁路缓存到分布式事务的确定性演化",
      "prompt": "monochrome_system_editorial style, 21:9 ultra-wide editorial composition, pure white textured paper background, technical fine black ink line art, bold typography on the left saying '高并发下的缓存一致性困局', on the right is a minimalist mechanical dual-track railway with precise interlocking gear clutches, a minimalist quirky small black silhouette worker holding a lever switch, crisp negative space, Swiss editorial layout, professional engineering asset, no 3D, no color gradients, high-end technical publication cover."
    },
    {
      "id": "body_01",
      "type": "body",
      "aspect_ratio": "16:9",
      "style_id": "monochrome_system_editorial",
      "title": "读写交错下的脏数据回写陷阱",
      "structure": "side_by_side_comparison",
      "prompt": "monochrome_system_editorial style, 16:9 technical infographic, pure white paper background, fine line technical diagram illustrating concurrency clash between cache and database, side-by-side workflow panels, small black silhouette operator catching a retrogressive data block, clear Chinese annotations, minimalist annotations, clean aesthetic, no clutter, no gradient."
    }
  ]
}
七、架构启示:Agentic 时代的“领域专用视觉操作系统”
从单纯的“大模型调用 API 出图”,到 cc2image 所展现的完整视觉体系,我们可以提炼出三条对未来 AI 工具研发极具启发性的架构哲学:
| 维度 | 传统 Prompt 工具包 | cc2image 的系统化解法 | 生产力启示 |
|---|---|---|---|
| 工作流控制 | 相信模型的自发输出,任由 Agent 盲目出图 | 最高优先级门禁(Gatekeeper) + 确定性配置选型 | 关键交互必须收敛为确定性状态机,不把决定权全部甩给模型 |
| 交互性能 | 现场让大模型编写复杂 HTML 代码与无头调试 | 预编译脚本管道 + 结构化标准协议 | 核心首显路径不依赖大模型临场发挥,保障毫秒级交互体验 |
| 知识沉淀 | 单纯罗列“画质高清、大师杰作”等空洞修饰词 | 引入成熟设计学(Kashika 5 级解释度与 7 轴评估) | 真正能产生商业价值的 AI 系统,必然是深刻吸收了人类专业领域 Know-how 的系统 |
在生成式 AI 正在快速重塑内容生产的今天,粗糙的通用提示词早已无法满足专业创作者对品质的苛求。通过严密的信息拆解架构、确定性的交互门禁以及体系化的视觉语言资产库,把玄学式的模型抽卡转变为可复现、可预期、工业级的生产力流水线——这正是 cc2image 为整个中文内容生态带来的最大价值。