
让普通监控看懂顾客的眼睛:BrandPose 的多模型视线反推、空间标定与 3D 第一视角复原
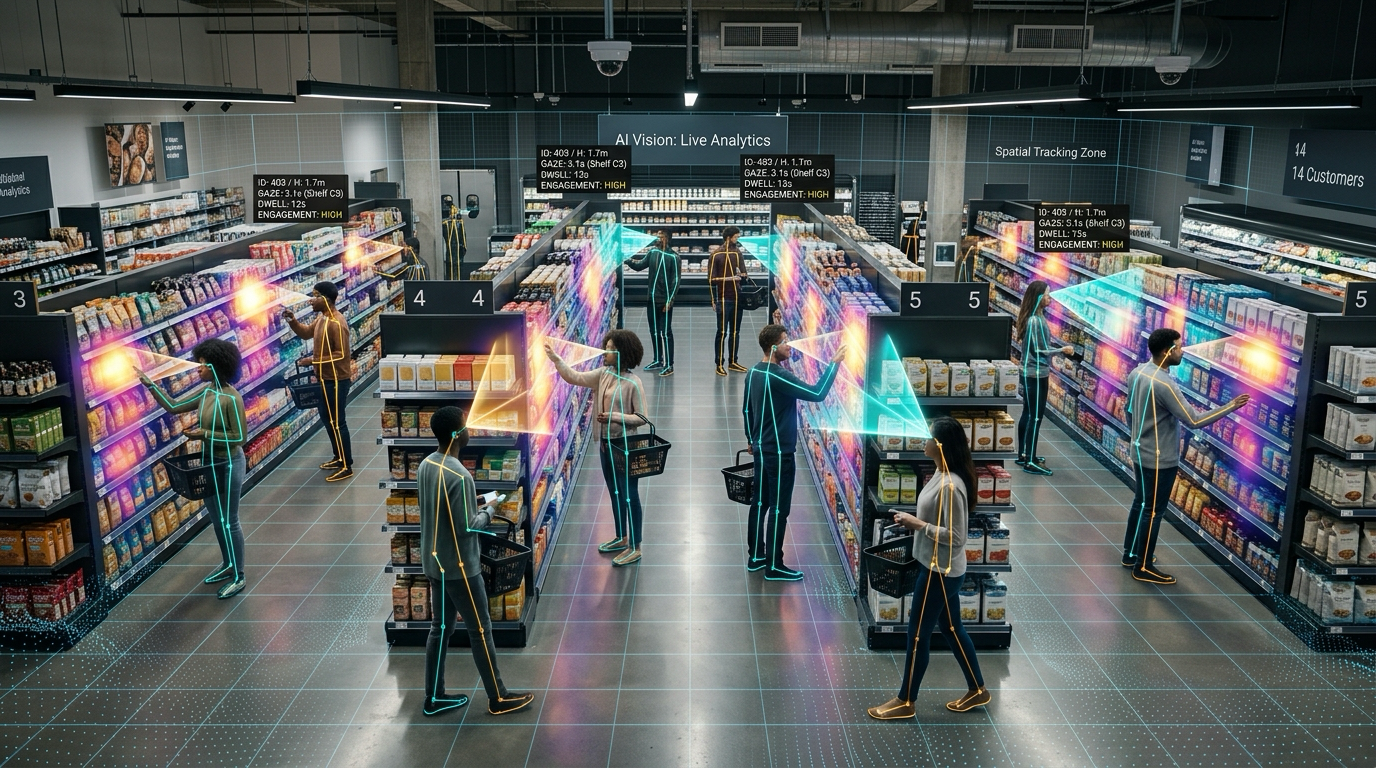
在传统智慧零售与商超数字化改造中,若想量化评估某款商品陈列或货架海报对顾客的真实视觉吸引力,行业往往依赖两套代价高昂的方案:要么为受试消费者佩戴笨重的眼动追踪眼镜(Eye-tracking Glasses),要么在特定货架加装高精度的红外深度相机与毫米波雷达阵列。这种侵入式或重资产的方案注定无法在成百上千家真实线下便利店进行低成本规模化复制。
前段时间,空间智能公司 CactusXR(Auki)在社交网络发布了一段惊艳的演示视频,展示了利用零售店铺既有安防监控摄像头直接在 3D 货架表面实时投射顾客视觉注意力热力图的能力。开发者 Claudio Escudero 萌生了一个纯粹的技术好奇:如果完全不增加任何外部传感器,仅凭便利店天花板上一颗普通的固定安防监控摄像头与开源 AI 基础设施,能否从零复刻出一套高精度的顾客货架注视追踪系统? 他开源的 BrandPose 项目给出了极具工业参考价值的答案。我深入研读了它的全部源码、标定数学推导与实验踩坑手记,本文将从多模型协同、工程避坑过滤规则、空间几何联合标定以及 Blender 第一视角复原这四大维度展开全景解析。
1. 整体架构与全景数据管线
在深入代码细节前,我先梳理出 BrandPose 完整数据流向的全局认知。整个系统的核心输入仅为一段时长 60 秒、分辨率 1080p 的真实商超便利店安防监控录像(基于 ACTi E43A 固定半球摄像头公开 Demo),输出则涵盖了二维标注视频、时序注意力审计报表、3D 点云渲染以及顾客第一视角的 Blender 电影级动态复原。

整个管线分为四个紧密耦合的阶段:
- 静态背景重构(Clean Plate):通过对原始视频进行低帧率时域中值滤波,将穿行顾客在像素级别完全“抹除”,生成无人的绝对干净店铺背景;
- 多模型感知推断:由 YOLO11-pose、YOLO11-seg 与 Gaze-LLE 组成多路视觉处理管线,提取骨骼、人体掩膜与视线热图;
- 启发式注意力规则清洗:通过空间碰撞与边界保护规则,剔除 50% 以上由模型伪影造成的虚假注意力;
- 空间标定与 3D 渲染:将二维视线投射至空间三维多面体货架,并在 Blender Cycles 中重构指定顾客的第一人称主观视角。
2. 视觉感知层的三大关键设计决策
在大模型与深度学习感知层,很多开发者往往习惯将整帧图像无脑喂入模型,随后抱怨模型“精度极差”。BrandPose 在第一版(v1)实机测试时同样遭遇了严重滑铁卢。作者通过严谨的对比实验,总结出三项决定性的工程优化:

1. 拒绝整帧挤压:自适应头部正方形动态裁剪(Per-Person Crop)
Gaze-LLE 默认的输入分辨率固定为 448 × 448 像素。在首版实现中,若直接把 1920 × 1080 的监控画面直接 Resize 至 448 × 448:
- 画面发生极其严重的非等比横向挤压;
- 在高耸天花板俯视广角镜头下,远端顾客头部中位尺寸仅约 58 像素,压缩后投射至网络输入层仅剩 13 × 23 像素!眼球、鼻尖与面部朝向特征被双线性插值彻底磨平,模型直接退化为“瞎猜”。
在 scripts/gaze_sim_v2.py 中,作者引入了自适应窗口裁剪算法:
def crop_window(hb, W, H, scale, min_side):
    """
    围绕人头动态生成正方形裁剪区。
    由于商超安防摄像头装在天花板俯视,顾客视线目标几乎总是落在头部下方,
    因此将头部强行锚定在正方形裁剪区域的上部 1/3 处。
    """
    x1, y1, x2, y2 = hb
    hw = max(x2 - x1, y2 - y1)
    side = int(np.clip(hw * scale, min_side, min(W, H)))
    cx, cy = (x1 + x2) / 2, (y1 + y2) / 2 + 0.2 * side
    left = int(np.clip(cx - side / 2, 0, W - side))
    top = int(np.clip(cy - side / 2, 0, H - side))
    return left, top, side
通过以头部宽度为基准动态扩展 10 倍边长、并保证人头位于裁剪正方形上方 20% 偏置处的策略,进入 Gaze-LLE 的人头分辨率被硬生生放大了 3.5 倍以上,且保持了 1:1 的无畸变几何比例,视线估算精度发生了质的飞跃。
2. 追踪频率与推理频率解耦:全帧追踪(Track Every Frame)
早期的另一个直觉是:既然模型推理很重(每秒只采样 3 次视线),那么人体检测与追踪是否也可以降频到每秒 3 帧以节省算力?
实测表明,降频追踪是灾难性的。在 t = 24 秒时,画面中明明有 4 名顾客在快速走动,但由于每跳过 10 帧才运行一次关联匹配,ByteTrack 的卡尔曼滤波与匈牙利算法无法处理大步长位移,4 个人里有 2 个人被直接丢弃;当他们下一秒重新被检出时,系统为其分配了全新的 Track ID,导致时序平滑缓冲区被彻底打碎。
解决方案是将管线解耦:
- 人体检测与跟踪器(YOLO11m-pose + ByteTrack)以 30fps 原生全帧率运行,保证行人运动轨迹连续无断层;
- Gaze-LLE 视线热图推断 按每 3 帧一次(10fps)执行,在计算资源开销与时间精度之间取得了绝佳平衡。
3. 多模型时空对齐基准实测
在 Apple M2 Pro(16GB 统一内存,PyTorch MPS 后端)环境下,作者记录了各版本迭代的实测基准数据:
| 模型方案配置 | 处理 60s 视频时长 | 视线估算总量 | 跟踪有效 ID 数 | 视线落入自身头部率 | 视线震颤中位数 (px) |
|---|---|---|---|---|---|
| v1(整帧压缩, ViT-B) | 42 秒 | 588 次 | 20 个 | 7.1% | 34.5 |
| v2-B(动态裁剪, ViT-B) | 60 秒 | 430 次 | 20 个 | 1.6% | 25.3 |
| v2-C(动态裁剪, ViT-L) | 180 秒 | 430 次 | 20 个 | 0.0% | 25.3 |
| v2-D(C + 时域平滑 + 自头抑制) | 121 秒 | 430 次 | 20 个 | 0.0% | 11.3 |
| v2-E(D + 30fps 全帧追踪) | 206 秒 | 493 次 | 21 个 | 0.0% | 11.3 |
从数据可见,换用大容量 Backbone(ViT-L)结合动态裁剪后,视线错误锁死自身头部的概率直接被压低到了 0%;而时序指数平滑算法将相邻帧注视点晃动幅度降低了 67%(从 34.5px 骤降至 11.3px)。
3. 决定成败的注意力清洗规则库
在学术论文的 Benchmark 测试集上,指标往往只关注 Gaze Direction 与 Ground Truth 的夹角误差。然而,一旦把视线模型直接部署到真实便利店监控中,原始热力图会产生大量令人啼笑皆非的“虚假繁荣”。如果不做规则清洗,报表中“太阳眼镜与饰品区”会被统计出高达 77 秒、占比 36% 的第一注意力——而这完全是一个彻头彻尾的统计幻象。
BrandPose 在 scripts/promo/render_promo.py 中构筑了五道极其老练的工程防护栏:

规则一:视线出画边界黏滞效应(Edge Sticking Phenomenon)
当顾客把头转向门口、天花板或画面边缘以外的走廊时,Gaze-LLE 的注意力热图并不会返回平坦分布,而是会强制将热力图的最大概率波峰牢牢“吸附”在图像四周的最外层边缘!
- 数据显示:在原始未过滤的检测峰值中,竟然有 34% 的视线峰值距离图像边界不足 24 像素;
- 恰巧该便利店的“太阳镜展架”安装在监控画面的最左侧边缘,大量看向店外马路的目光被无脑算进了太阳镜的注视时间;
- 防御对策:硬性划定 32px 的边缘死区。凡最大峰值坐标落在距四边边界小于 32px 范围内的,强制将
inout置信度清零,判定为“望向画外”。
规则二:人际注视碰撞剔除(People Silhouette Collision)
顾客在购物时并非只看货架,他们会观察收银员、同行的伴侣、或者路过打量其他顾客。
- 实测统计表明:全片中有 25% 的视线落点直接击中了其他顾客的身体;
- 若仅靠矩形货架区域求交,这 25% 的视线会直接被当成背后货架的曝光量;
- 防御对策:引入
YOLO11m-seg生成每帧所有行人的像素级语义分割掩膜(person_masks_packed.npy)。在判定货架归属前,优先在半径 4 像素窗口内与人体掩膜做碰撞测试。若视线击中他人轮廓,视线有效但货架归属记为-1。
规则三:自头抑制与亚像素质心微调
在 _gaze_tracks 算法中,作者对连续 3 帧热图按权重 [0.25, 0.5, 0.25] 实施滑动加权,并强制将自身头部中心放大 1.5 倍的矩形区域矩阵直接赋 0,随后在 3 × 3 邻域内计算一阶力矩,提取亚像素(Sub-pixel)注视中心:
# 提取 3x3 邻域利用质心公式计算亚像素微调坐标
y0, y1_, x0, x1_ = max(0, py - 1), min(hs, py + 2), max(0, px - 1), min(ws, px + 2)
win = acc[y0:y1_, x0:x1_]
gy, gx = np.mgrid[y0:y1_, x0:x1_]
s = win.sum() + 1e-9
subpixel_x = ((gx * win).sum() / s + 0.5) * self.ds
subpixel_y = ((gy * win).sum() / s + 0.5) * self.ds
规则四:轨迹碎片重组与店员(Staff)脱敏
- 轨迹缝合(Re-ID Merge):对于短暂脱离视野(如弯腰系鞋带或被立柱遮挡)在 1.5 秒(45 帧)以内、且重新出现距离原终点小于 150 像素的新轨迹,自动继承前序父节点,将 20 段离散 Track 成功还原为 17 名真实顾客;
- 理货员剥离:画面上方始终有一位站在梯子上整理货架的店员,其长时间驻留在收银台后方。通过在静态配置文件中框定
staff_heads梯子头部区间,时域中位落在此框内的人体被标记为“STAFF”,其长达 60 秒的密集视线被一键屏蔽在零售分析之外。
4. 空间几何联合标定:当单目度量深度遭遇“空间萎缩”
为了将二维画面中平面注视点转换为 3D 货架交互,最直接的想法是调用顶尖的单目度量深度估计模型(如 Depth Anything V2 Metric Indoor)。然而,这也是整套系统中踩得最深的一个工程巨坑。
1. 单目深度模型的物理失真
当作者将 Depth Anything V2 预测的 Metric Depth 转化为三维点云后,发现了一个极其荒谬的物理现象:
- 模型预测出的监控相机安装高度仅为 2.04 米(而实际便利店天花板至少在 2.7 米以上);
- 更严重的是,商超标准高位中岛双面货架在点云中的物理高度竟然只有 0.7 至 1.0 米,整个店铺在 Z 轴方向被严重“压扁萎缩”!
单目深度模型在面对大倾角安防鱼眼/广角镜头时,严重缺乏绝对尺度的地面参考系约束。

2. 人体作为物理尺子:多未知数非线性联合求解
为了求解出无可辩驳的绝对几何尺度,作者在 scripts/blender/calib.py 中设计了一套极其巧妙的联合最小二乘法:
- 人工特征锚点:在无人的
clean_plate.png上,针对 13 组核心货架标注了 49 个特征像素点(40 个 3D 立方体角点 + 9 个边缘接触点); - 人体作为天然标尺:挑选 66 组身体舒展无遮挡的顾客姿态样本。在统计学上,成年人(平均身高约 1.70 米)的 鼻尖中心至脚踝垂直距离高度差极其恒定在 1.49 米;
- 相机内参与外参联合优化:构建包含相机高度 h、偏航角 yaw、俯仰角 pitch、翻滚角 roll、焦距 f 以及镜头一阶桶形径向畸变系数 k1 的状态向量;
- 调用
scipy.optimize.least_squares(采用对粗大误差鲁棒的 Soft L1 损失函数)执行梯度下降求解。
对比参数揭示了标定前后的巨大反差:
| 关键几何参数 | Depth Anything V2 预估值 | 人体标尺联合最优化解算值 | 物理验证结果 |
|---|---|---|---|
| 相机安装高度(h) | 2.04 米 | 2.68 米 | 完美贴合商超吊顶工程规范 |
| 水平视场角(HFov) | 60.0° | 57.0° (f = 1767 px) | 符合 ACTi 3.6mm 镜头物理参数 |
| 俯仰角(Pitch) | 18.0° | 19.3° | 匹配吊架倾角 |
| 镜头径向畸变(k1) | 0.0 (默认理想针孔) | -0.318 (强桶形畸变) | 直线边缘重合度误差从 37px 降至 3px |
| 糖果货架实际高度 | 0.82 米 | 1.45 米 | 真实商超 gondola 标准高度 |
5. 走入顾客双眼:Blender Cycles 第一视角电影级重构
BrandPose 最具工程震撼力的突破,在于它不仅仅止步于在平面监控画面上画箭头,而是利用前面解算出的三维轨迹与视线射线,在开源 3D 渲染器 Blender 中真正 走进了顾客的双眼,复原出那位身穿蓝色夹克的男青年在 17.3 秒进店后所经历的完整第一人称视角画面。

1. 从像素到地面的反投影链路
在单目相机下,给定一个二维像素 (u, v),若要计算其在真实世界三维地面的物理位置,必须逆向补偿镜头畸变。在 calib.py 的 unproject 函数中,通过牛顿迭代法精确反演桶形畸变:
def unproject(cam, u, v, z):
    """
    像素坐标 (u, v) -> 世界坐标系中高度为 z 的三维点。
    采用数值迭代反解一阶径向畸变公式:xn' = xn * (1 + k1 * r^2)
    """
    xd, yd = (u - W / 2) / cam["f"], (v - H / 2) / cam["f"]
    xn, yn = xd, yd
    for _ in range(5):  # 5次迭代收敛到 1e-6 精度
        r2 = xn * xn + yn * yn
        k = 1 + cam["k1"] * r2
        xn, yn = xd / k, yd / k
    # 结合旋转矩阵 M 与世界高度 Z 求解地表面射线交点
    # ...
在提取行人站立点时,算法构建了优雅的降级容错链条:
双脚踝 (Z=0.08m) -> 鼻尖 (Z=1.57m) -> 头部中心 -> 双肩 (Z=1.40m)。
实测对比表明:在全身可见的帧中,通过脚踝和通过鼻尖反推地面的距离误差中位数仅为 22 ~ 25 厘米,这为 3D 轨迹平滑提供了极为健壮的基石。
2. 虚拟主观相机的物理动力学约束
如果把 Gaze-LLE 计算出的瞬时视线直接绑在 Blender 虚拟摄像机上,镜头会因为高频噪声剧烈颤抖,导致画面无法直视。在 scripts/blender/pov.py 中,作者赋予了虚拟相机高度拟真的物理动力学特性:
- 视点位置(Eye Position):眼睛高度固定在 1.62 米,每行走 0.7 米步长叠加一个振幅为 1.5 厘米的垂直正弦谐波,真实模拟人类行走的重心起伏;
- 货架物理防穿模(Collision Buffer):由于轨迹存在 25 厘米的系统误差,早期版本镜头经常直接“穿墙穿货架”。脚本引入了硬性势场包络,强制摄像机与所有货架表面保持至少 0.5 米的物理缓冲距离;
- 双重注意力混合寻向(Dual-Cue Direction):镜头朝向采用高斯核回归(σ = 7 帧),由当前 3D 视线射线焦点(权重 1.0)与行走前进方向向量(权重 0.35,前倾下潜 10°)进行矢量加权合成;
- 俯仰角物理约束:强制将俯仰角夹在 [-30°, +15°] 之间,避免因近身俯视视角产生不自然的垂直翻滚。
3. Cycles 渲染工业流水线
全片 532 帧(对应顾客在店内漫游的 17.3s 至 35.0s)在 Blender 5.2 中通过无头命令行模式(blender -b --python pov.py)由 Cycles 引擎以 32 采样率结合 GPU Metal 降噪器完成光线追踪渲染。在 M2 Pro 上平均单帧渲染耗时约 8 秒,整片仅耗时 71 分钟即完成了这组极具科技美学的影视级重构。
6. 无音频采样依赖:纯数学公式合成电影级原声
在项目构建宣发视频(Promo Video)时,不少开发者往往会图省事去网上扒背景音乐,导致版权风险与音画错位。而 BrandPose 在 scripts/promo/audio.py 中展现了一种令人叹为观止的极客浪漫:全片 44.3 秒的音轨没有使用哪怕一个现成的 MP3 采样,所有乐器、底鼓与音效全部由 Python 的 NumPy 与 SciPy 纯数学计算生成!

在数学实现上:
- 808 风格底鼓:通过频率从 150Hz 沿时间轴极速指数下沉至 40Hz 的正弦波积分相位合成,带来极具冲击力的沉闷低频;
- 金属闭镲与扫频 Riser:通过高通 Butterworth 滤波后的伪随机噪声叠加线性包络;
- 环境和弦 Pad:通过多个带有微弱拍频失谐的正弦波合成多声部和弦,再经过 SciPy 的卷积混响(Convolution Reverb)拉出空灵的立体声声场;
- 侧链抽吸效应(Sidechain Ducking):当底鼓踩下的瞬间,环境音量被自动压低,形成现代电子音乐标准的节奏律动感。
这种“代码即音乐”的做法使得声音波形能够与视频画面中的扫描线、时间冻结(Bullet Time)以及 3D 摄像机飞行动作保持毫秒级严格锁相对齐。
7. 真实便利店 60 秒视线注视审计报表
在经历了严格的边缘剔除、人体掩膜碰撞检测、理货员剥离与轨迹缝合后,BrandPose 在这段 60 秒的真实便利店监控录像中,交出了一份极具说服力的零售注意力审计成绩单:

详细审计汇总表如下:
| 店铺货架区域分类 | 累计有效关注时长 | 综合注意力占比 | 驻留注视独立人数 | 核心陈列特征解读 |
|---|---|---|---|---|
| 糖果与巧克力(DOCES) | 16.1 秒 | 32.0% | 8 人 | 位于中央双面矮中岛,高度适中且直面进店主流线 |
| 太阳镜与配饰(ÓCULOS) | 15.8 秒 | 31.4% | 10 人 | 入门左侧落地展示架,进门首个视觉驻留焦点 |
| 背墙膨化小吃(SNACKS) | 7.2 秒 | 14.3% | 7 人 | 靠近收银台后方主干道,结账排队期间的高频注视点 |
| 现磨咖啡与果汁(CAFÉ) | 2.8 秒 | 5.6% | 6 人 | 服务柜台台面,点单与取餐期间的短暂停留 |
| 端头陈列架(PONTA DE GÔNDOLA) | 2.5 秒 | 5.0% | 2 人 | 促销黄金堆头,停留人数虽少但单人注视浓度较高 |
| 杂货粮油日常品(MERCEARIA) | 1.4 秒 | 2.8% | 4 人 | 右侧深处长货架,目的性购买区域 |
| 饮料长冷柜(GELADEIRAS) | 0.9 秒 | 1.8% | 3 人 | 店铺最深处透明冷柜,受距离与小尺度遮挡影响 |
| 精品红酒柜(VINHOS) | 0.5 秒 | 1.0% | 2 人 | 右侧角落,人流低频区域 |
| 精酿啤酒柜(CERVEJAS) | 0.3 秒 | 0.6% | 1 人 | 右下角深处 |
全片共捕获并分析了 797 个有效注视样本,锁定了 17 名真实顾客。原本虚高的杂音数据被彻底洗净,呈现出一条完美的实体便利店顾客动线与视觉漏斗模型。
8. 总结与空间智能的工程启示
通盘复盘 BrandPose 的代码实现与调试手记,我认为它给当下的计算机视觉开发者和 AI 空间计算从业者带来了四点不可多得的工程启示:
- 多模型不是堆砌,而是各取所长、相互制衡:
单凭 YOLO 无法感知视线,单凭 Gaze-LLE 无法过滤行人自身与遮挡,单凭 Depth Anything 又会导致空间畸变。将 YOLO-pose(骨骼)、YOLO-seg(轮廓掩膜)、Gaze-LLE(视线概率场)与传统几何算法有机组合,才构筑出可信的商业洞察; - 负向规则(Negative Constraints)往往比模型算法本身更重要:
在真实应用场景中,34% 的画幅边缘吸附伪影与 25% 的他人身体遮挡,是摧毁统计可信度的“罪魁祸首”。优秀的工程落地必须敢于制定坚决的清洗逻辑,果断扔掉不可信的脏数据; - 真实世界标定离不开物理世界的常识先验:
当神经网络给出的深度图与物理直觉冲突时,不要盲信深度学习的绝对度量输出。利用人类身高的统计学常识(鼻尖至脚踝 1.49 米)作为物理世界的尺子,配合经典最小二乘优化,往往比纯深度学习端到端更精准、更稳健; - 单目安防监控的 3D 觉醒正在到来:
全世界各大城市与商铺中沉睡着数以亿计的普通安防摄像头。BrandPose 证明了:不需要昂贵的新硬件,只要赋予其现代计算机视觉与空间几何的反投影能力,哪怕是一颗普通的监控摄像头,也能成为读懂空间行为与人类意图的智能数字孪生之眼。
原文链接与参考资料
- GitHub 源码仓库:escudero/brandpose
- 作者个人主页:Claudio Escudero on LinkedIn
- YouTube 官方演示视频 (42s):BrandPose: where shoppers look, from an ordinary security camera
- YouTube 第一人称视角复原视频 (18s):Through a shopper's eyes in 3D (Blender Cycles)
- Gaze-LLE 论文与开源项目 (CVPR 2025):fkryan/gazelle · arXiv:2412.09586
- Ultralytics YOLO11 开源仓库:ultralytics/ultralytics
- Depth Anything V2 论文与模型:DepthAnything/Depth-Anything-V2
- 灵感来源项目 (CactusXR / Auki):Auki Posemesh Spatial AI