
封堵内存标记绕过死角:Apple arm64e.x1 校验指针算术(CPA2)底层机制、addpt 硬件投毒与 Xcode 27 落地全景
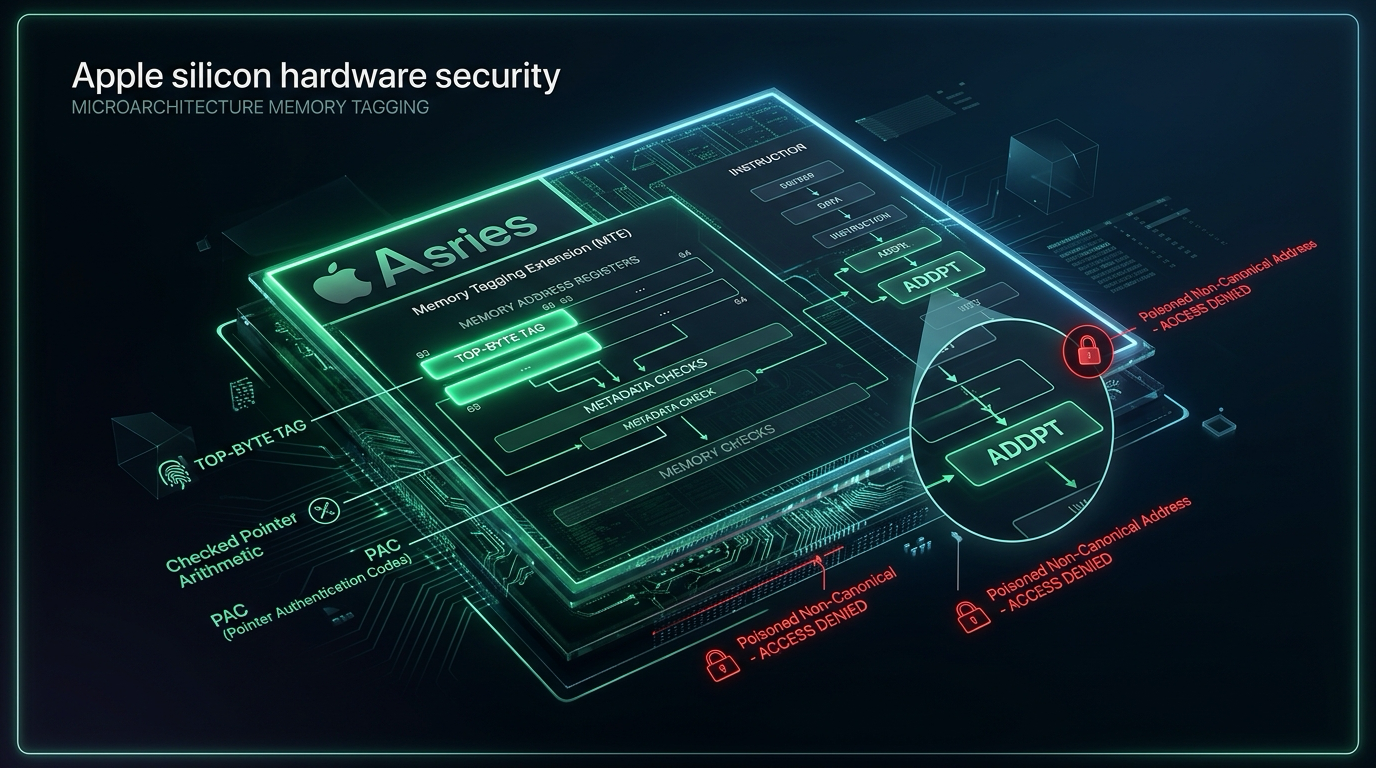
随着 iOS 27、macOS 27 与 watchOS 27 RC 版本发布,Apple 在“硬件安全”发行说明中悄然引入了一个全新 Mach-O 切片与硬件防护机制:arm64e.x1 与校验指针算术(Checked Pointer Arithmetic,CPA2)。这一举措不仅定义了全新的 Mach-O CPU 子类型(Subtype 12),更为 A20 Pro、M6 及 S11 芯片构筑起针对内存完整性执行(MIE)的坚实闭环。
在现代系统安全防御体系中,硬件级内存标记扩展(MTE)曾被寄予厚望,但指针算术溢出始终是悬在内存安全头顶的阿喀琉斯之踵。本文将从微架构攻防原理、Armv9.5-A 指令集演进、Clang 代码生成、Xcode 27 四级门禁配置到工程实战排雷,全景拆解 arm64e.x1 与 CPA2 的底层运行机理。
1. 微架构攻防痛点:MTE 内存标记的“算术溢出死角”
在探讨 arm64e.x1 之前,必须先理解 Apple 在内存安全防线上构建的上一块核心拼图——内存完整性执行(Memory Integrity Enforcement, MIE)。
在 2025 年推出的 A19 架构(iPhone 17 系列)中,Apple 与 Arm 联合研发了增强型内存标记扩展(Enhanced Memory Tagging Extension, EMTE)。其核心思想是在 64 位指针的虚位中榨取防护价值:
+------------------+----------+------------------------------------------------+
| Bits 63 .. 60    | 59 .. 56 | Bits 55 .. 0                                   |
+------------------+----------+------------------------------------------------+
| Top-Byte Ignore  | 4-bit Tag| 48/52-bit Canonical Virtual Address Space      |
+------------------+----------+------------------------------------------------+
- 指针染色:虚拟地址空间启用顶部字节忽略(Top-Byte Ignore, TBI),指针的最高字节
Bits [63:56]被保留。其中Bits [59:56]写入一个 4 位的内存标签(Tag,取值范围0x0 ~ 0xF); - 物理颗粒打标:内存分配器(如
malloc)将对应的物理内存颗粒(Granule,通常为 16 字节对齐的内存块)在芯片专用元数据存储中同步打上相同的 4 位标签; - 访存瞬时校验:当 CPU 执行载入(
ldr)或存储(str)时,加载单元硬件会并行比对指针内的 Tag 与目标内存颗粒的物理 Tag。若不匹配,硬件立刻触发精准异常。
flowchart TD
    subgraph MTE_Normal ["常规 MTE 空间防御(跨越相邻对象)"]
        P1["Pointer (Tag = A)"] --> A1["Allocation 1 (Tag = A)"]
        P1 -. "越界越入相邻堆块" .-> A2["Allocation 2 (Tag = B)"]
        A2 --> TRAP1["硬件 Tag 不匹配 -> 立即拦截异常"]
    end

    subgraph MTE_Bypass ["算术溢出绕过漏洞(Tag Overflow Bypass)"]
        P2["Pointer (Tag = A)"] --> CALC["恶意超大偏移运算: add x0, x0, offset"]
        CALC --> OVERFLOW["地址低位向高位连续进位 -> 污染 Bits [63:56]"]
        OVERFLOW --> FORGED["指针 Tag 被篡改重塑为 Tag = C"]
        FORGED --> A3["远端 Allocation 3 (Tag = C)"]
        A3 --> BYPASS["硬件 Tag 偶然匹配 -> MTE 防护彻底失效!"]
    end
致命的算术绕过后门
上述机制在防范紧邻对象的单字节溢出或野指针越界时极为有效。然而,ARM64 标准指令集中的基础算术指令(如 add x0, x0, x1, lsl #2)是无知觉的 64 位无符号加法。
当攻击者通过可控偏移量执行大跨度的指针算术时,如果加法进位突破了 48/52 位有效地址边界,就会直接溢出并篡改 Bits [63:56] 所在的顶字节!
这种溢出会产生极其危险的攻击后果:
- 标签伪造:攻击者能够通过精密的算术构造,将指针顶部的 Tag 强行翻转进位为另一个目标内存对象的 Tag;
- 防护瓦解:当该篡改指针跨越数个内存对象解引用时,硬件进行 MTE 比较时会赫然发现“指针标签与目标内存标签完全一致”,从而放行非法写入。
正如 Apple 内部安全技术文档中所言:
“在没有指针算术溢出校验的场景下,通过算术向高位非地址位溢出,是攻击者彻底瓦解内存标记体系的首要后门。”
2. 架构演进:从 FEAT_CPA 到 FEAT_CPA2
为从物理电路上根治这一绕过漏洞,Arm 在 Armv9.5-A 架构中正式规范了 校验指针算术(Checked Pointer Arithmetic)。该技术在标准中明确划分为两个层次:
| 特性标识 (Arm Feature) | 官方定义分类 | 核心职能与落地范围 |
|---|---|---|
FEAT_CPA |
Instruction-only Checked Pointer Arithmetic | 纯指令集规范:定义了标量指令 ADDPT、SUBPT、MADDPT、MSUBPT 及其向量指令(SVE/SVE2)的编码格式。编译器可发射对应汇编助记符。 |
FEAT_CPA2 |
Checked Pointer Arithmetic | 微架构硬件执行单元:在芯片执行流水线与加载存储单元(LSU)中,提供物理级别的顶字节动态比对、瞬时投毒与异常陷阱生成。 |
在 Apple 体系中,从 A12 时代引入的 arm64e(针对 PAC,即指针认证码)长期停留在 apple-a12 靶向。而此次为了承载 FEAT_CPA2,Apple 开辟了全新的 Mach-O 子架构——arm64e.x1。
在 Xcode 27 的 iOS SDK(usr/include/mach/machine.h)中,Mach-O 头文件常量的定义清晰揭示了这一分界:
#define CPU_SUBTYPE_ARM64E              ((cpu_subtype_t) 2)
/* The non-e x1 is defined in other tooling, but it's otherwise unused. */
#define CPU_SUBTYPE_ARM64_X1            ((cpu_subtype_t) 3)
#define CPU_SUBTYPE_ARM64E_X1           ((cpu_subtype_t) 12)
当使用 Apple Clang 21(clang-2100.3.34.2)指定 -arch arm64e.x1 编译时,驱动层报告的目标 CPU 为 apple-a20,其开启的微架构特性树为:
-target-cpu apple-a20:
  +cpa       (Checked Pointer Arithmetic 指令集)
  +mte       (Memory Tagging Extension 内存标记)
  +pauth     (Pointer Authentication 指针认证)
  +pauth-lr  (PAC 增强链接寄存器)
  +fpac      (Faulting PAC 硬件强制陷阱)
3. 微架构执行层:addpt 硬件投毒机制深度剖析
当一个普通的 C/C++ 指针算术函数被编译为 arm64e 与 arm64e.x1 时,汇编输出发生了决定性的变化:
int *offset_ptr(int *base, long index) {
    return base + index;
}
; === 编译目标: -arch arm64e -O2 ===
offset_ptr:
    add   x0, x0, x1, lsl #2
    ret

; === 编译目标: -arch arm64e.x1 -O2 ===
offset_ptr:
    addpt x0, x0, x1, lsl #2
    ret
编译器无需开发者配置任何特殊语法,只要编译切片为 arm64e.x1,指针算术加法便会自动替换为 addpt(Checked Add Pointer)。
sequenceDiagram
    autonumber
    participant App as 应用程序代码
    participant ALU as CPU 算术执行单元 (addpt)
    participant LSU as 加载存储单元 (Load/Store)
    participant MMU as 内存管理单元 (MMU)

    App->>ALU: 执行 addpt 算术: p + index
    Note over ALU: 比对 Result[63:56] 与 Base[63:56]<br/>检测是否越界污染高位 Tag
    alt 顶字节一致 (未溢出)
        ALU-->>App: 返回正常指针 (合法 Canonical 地址)
    else 顶字节不一致 (发生算术溢出)
        ALU-->>ALU: 硬件立即投毒! 置为非规范化地址 (Poisoned)
        ALU-->>App: 返回已被污染的残废指针
    end

    App->>LSU: 解引用访存: ldr x2, [x0]
    LSU->>MMU: 发起物理地址转换
    alt 指针已被投毒
        MMU-->>LSU: 触发 Level-0 Translation Fault!
        LSU-->>App: 派发 Mach 异常: EXC_ARM_CPA_FAIL (0x108)
    else 指针正常
        MMU-->>LSU: 转换成功,比对 MTE Tag 并读写物理数据
    end
1. 硬件比较判定点
addpt 指令在微架构执行流水线中,强制执行如下断言检查:
它将运算结果的最高字节(Bits [63:56])与基准操作数(Base Operand)的最高字节进行单周期严格比对。在启用了 MTE 的环境中,Bits [59:56] 承载着该内存分配的 4 位 Tag。只要计算导致了高位进位错乱、使得顶字节脱离了基地址的原生 Tag,该比较判定即告失败。
2. 指针即时投毒(Hardware Poisoning)
判定失败时,CPU 并不会在加法阶段立刻挂起触发同步异常,而是就地实施 “寄存器投毒” 。
硬件会将计算结果的高位强行写入特定的非规范化模式(Non-canonical Bit Pattern),将其彻底转变为一个物理上不可被任何页表翻译的非规范化指针。这一机制完美保证了超标量 CPU 乱序执行流水线(Out-of-Order Engine)的无阻吞吐,无需在指针算术时停顿等待异常响应。
3. 双层防护体系:隐式寻址检查
更关键的微架构杀手锏在于:防护不仅仅存在于显式加法中。
硬件在整个内存子系统设置了双层检查网:
- 显式指令校验:所有由编译器生成的
addpt、subpt指令对运算结果执行顶字节比较并投毒; - 访存寻址实时校验:CPU 的加载存储单元(LSU)在执行
ldr、str指令的基址变址寻址(如ldr x0, [x1, x2, lsl #3])时,硬件在内部执行地址加法的瞬间,同样会强行比对基地址与有效地址的顶字节。
重磅工程优势:这意味着,即使主程序加载了一个 完全未经
arm64e.x1重新编译、由纯旧版arm64e产出的动态库(dylib/framework) ,只要主进程开启了 CPA2 强制策略,该动态库内部的所有加载/存储寻址模式同样受到硬件级防溢出拦截!
4. 延迟引爆与精准故障码
一旦投毒指针在后续被程序解引用,MMU 在发起虚拟地址到物理地址翻译时,检测到非规范化高位,立即抛出 Level-0 Translation Fault。
Darwin 内核将其封装为 Mach 异常派发:
- 异常类型:
EXC_ARM_CPA_FAIL(异常代号为0x108); - ESR 异常症候寄存器(Exception Syndrome Register):
- 读越界引爆:
0x92000004; - 写越界引爆:
0x92000044。
- 读越界引爆:
4. 降级兜底:软件模拟序列及其代价
如果开发者在不支持 CPA2 的老设备(如 A18 及更早芯片)或未切到 arm64e.x1 的工程上,强行通过 Clang 参数开启 -fchecked-pointer-arithmetic,编译器会生成怎样的代码?
Clang 会被迫用昂贵的多指令软件模拟序列替代单个 addpt:
; === -arch arm64e 下使用 -fchecked-pointer-arithmetic 的软件模拟 ===
add   x2, x0, x1, lsl #2         ; 1. 执行常规加法
eor   x3, x0, x2                 ; 2. 异或基址与结果: 捕获发生翻转的位
and   x3, x3, #0xffc0000000000000 ; 3. 掩码提取顶层 10 位 [63:54]
cbnz  x3, L_poison               ; 4. 若有位差异,跳转至投毒分支
b     L_done
L_poison:
movk  x2, #0xc8a2, lsl #48       ; 5. 强行写入 0xc8a2 使指针非规范化 (投毒)
L_done:
mov   x0, x2
ret
对比一目了然:
- 硬件
addpt:单条指令,单周期执行延时,零流水线气泡,零代码体积膨胀; - 软件模拟序列:需要额外消耗 5~6 条指令、引入条件分支(
cbnz)与临时寄存器开销,导致严重的指令吞吐膨胀与分支预测器压力。
这也是 Apple 坚决不向全系架构默认开启软件模拟、而是专门为 A20+ 架构开辟独立 arm64e.x1 切片的根本原因。
5. Xcode 27 落地实践:四级联动门禁(The Quadruple Gate)
在 Apple 随 Xcode 27 内置的安全参考文档中,工程师给出了极其严厉的警告:
“Target 上必须同时配置四项设置。只要漏掉任意一项,硬件防护将完全不生效。”
flowchart TD
    G1["1. Build Setting:<br/>ENABLE_HARDWARE_CHECKED_POINTER_ARITHMETIC_SLICE = YES"]
    --> G2["2. Enhanced Security 基础沙箱能力:<br/>com.apple.security.hardened-process"]

    G2 --> G3["3. 硬件内存标记扩展 (MTE/EMTE):<br/>com.apple.security.hardened-process.checked-allocations"]

    G3 --> G4["4. CPA2 硬件故障强制执行:<br/>com.apple.security.hardened-process.checked-allocations.enforce-checked-pointer-arithmetic-overflow"]

    style G1 fill:#1e293b,stroke:#38bdf8,stroke-width:2px,color:#f8fafc
    style G2 fill:#1e293b,stroke:#818cf8,stroke-width:2px,color:#f8fafc
    style G3 fill:#1e293b,stroke:#a855f7,stroke-width:2px,color:#f8fafc
    style G4 fill:#1e293b,stroke:#ec4899,stroke-width:2px,color:#f8fafc
1. 四重门禁具体配置清单
- 切片生成(Build Setting):
在 Xcode 构建设置中搜索Enable Hardware-Checked Pointer Arithmetic Slice,设置为YES(底层键值ENABLE_HARDWARE_CHECKED_POINTER_ARITHMETIC_SLICE = YES)。它会将arm64e.x1自动追加进ARCHS_STANDARD; - 增强安全沙箱(Entitlement 根节点):
在 Signing & Capabilities 中添加 Enhanced Security,引入 Entitlement:com.apple.security.hardened-process = true;
注:若手动维护.entitlements文件,必须额外显式写入版本键:<key>com.apple.security.hardened-process.enhanced-security-version-string</key> <string>2</string> - 启用硬件内存标记(MTE 节点):
在 Memory Safety 选项中勾选 Hardware Memory Tagging,对应 Entitlement:com.apple.security.hardened-process.checked-allocations = true; - 开启算术溢出强制拦截(Enforcement 终极节点):
勾选子选项 Enforce Checking for Overflow of Pointer Arithmetic,对应 Entitlement:
com.apple.security.hardened-process.checked-allocations.enforce-checked-pointer-arithmetic-overflow = true。
2. 三切片胖二进制与 PAC 陷阱
许多架构师最容易忽视的是 ENABLE_POINTER_AUTHENTICATION 与切片组合的隐蔽陷阱。
下表摘自 Apple 内部量测的标准架构矩阵:
ENABLE_POINTER_AUTHENTICATION |
ENABLE_HARDWARE_CHECKED_POINTER_ARITHMETIC_SLICE |
最终解析生成的 ARCHS_STANDARD |
架构评价与推荐状态 |
|---|---|---|---|
NO |
NO |
arm64 |
基础发布形态 |
YES |
NO |
arm64 arm64e |
既有防 PAC 攻击形态 |
NO |
YES |
arm64 arm64e.x1 |
❌ 严重降级事故:缺失 arm64e,导致不支持 CPA2 的旧款机型因无切片直接跌落至 arm64,彻底丧失原有的 PAC 保护! |
YES |
YES |
arm64 arm64e arm64e.x1 |
官方强力推荐配置:构建三切片胖 Mach-O,新旧机型全方位享受最高防护。 |
打包完成后,可通过 Terminal 验证 Mach-O 二进制切片完整性:
lipo -archs MyApp.app/MyApp
# 终端应准确输出: arm64 arm64e arm64e.x1
3. 条件编译与模拟器兼容
针对需对 arm64e.x1 实施特殊处理的底层逻辑,Clang 预定义了专属宏:
#if defined(__arm64e_x1__)
    // 针对 arm64e.x1 的特异化汇编或内联逻辑
#endif
对于 iOS 模拟器环境,SDK 内部压根没有定义 arm64e.x1 架构。Xcode 的构建系统在编译 Simulator Target 时,会自动将其从有效架构列表中剔除(行为与 arm64e 完全一致),开发者无需担心本地模拟器联调发生构建失败。
6. 硬件兼容矩阵与排雷攻防手册
1. 硬件支持边界
并非所有标榜支持 MIE 的芯片都支持 arm64e.x1。以下是清晰的硬件执行分水岭:
graph LR
    subgraph A19 ["A19 / A19 Pro (iPhone 17 系列)"]
        direction TB
        MIE1[支持 MIE 内存完整性]
        EMTE1[支持 EMTE 内存标记]
        NOCPA[不支持 FEAT_CPA2 硬件执行单元]
    end

    subgraph A20 ["A20 Pro / M6 / S11 (新一代硬件)"]
        direction TB
        MIE2[支持 MIE 内存完整性]
        EMTE2[支持 EMTE 内存标记]
        CPA2[完整支持 FEAT_CPA2 硬件执行]
        SLICE[支持 arm64e.x1 原生加载执行]
    end

    style A19 fill:#1f2937,stroke:#9ca3af,stroke-width:1px,color:#f3f4f6
    style A20 fill:#111827,stroke:#10b981,stroke-width:2px,color:#f3f4f6
- 全面支持芯片:
- A20 Pro:iPhone 18 Pro、iPhone 18 Pro Max、iPhone Duo;
- M6:新一代 Mac mini 及后续 Apple Silicon Mac;
- S11:Apple Watch Series 12、Apple Watch Ultra 4;
- 缺席机型警示:iPhone 17 与 iPhone Air 搭载的 A19/A19 Pro 虽具备 MIE/EMTE,但因缺少微架构指令单元,系统加载器(dyld)在其上不会选择
arm64e.x1切片,而是平稳回退至arm64e。
2. 隐藏潜伏 Bug(Latent Bugs)集中引爆
开启 CPA2 强制策略后,业务代码中若潜藏着不合规的指针算术操作,将被硬件精准狙杀。常见踩坑场景包括:
- 跨对象指针差值与偏移运算:
在 C/C++ 中,对分别属于两个独立堆分配块的指针进行距离计算并加回基地址。由于两者在 MTE 下打上了不同的 Tag,算术进位会导致顶字节不一致,计算结果立即被投毒; - 空指针算术(Arithmetic on a NULL Base):
部分老旧开源库喜欢使用((struct foo *)NULL)->member的偏移量计算方式。对 0 地址施加偏移算术会破坏高位全零基准,直接触发投毒; - 大跨度超界偏移预计算:
在迭代器或环形缓冲区设计中,为了边界对齐预先计算出大幅超出当前对象边界的指针,即便后续不解引用,只要发生顶字节进位溢出,指针就已经被非规范化损坏; - 指针高位脏数据混合:
部分高性能框架喜欢自行在指针高 8 位存放哈希缓存、引用计数或状态标志。这些自制机制会破坏基准顶字节的纯净性,导致addpt判定全面瘫痪。
3. “时空分离”的调试攻防
调试 CPA2 崩溃的最大心理障碍是:崩溃发生点绝非犯罪现场。
[模块 A: 数据解析]                                    [模块 B: 渲染输出]
addpt x0, x0, x1  --> 发生算术溢出被投毒!
      │
      └─── (传递至数个函数调用后) ───────────────> ldr x3, [x0]
                                                     │
                                                     └─── 触发 EXC_ARM_CPA_FAIL 崩溃!
由于 addpt 在投毒时不中断执行,而是推迟到解引用时由 MMU 爆破,崩溃堆栈往往停留在无辜的后续使用方代码中。
排查此类崩溃的黄金准则:
- 观察崩溃现场的故障寄存器值,查看其高 16 位是否呈现异常非规范化格式(如包含
0xc8a2或高位翻转); - 不要在崩溃所在的
ldr/str处怀疑内存损坏,而应反向排查该指针自生成以来的所有+、-、下标索引与变址计算路径。
4. 2026 年 9 月 17 日已知坑位:App Store 自动签名上传阻断
在 Apple 官方于 9 月 17 日更新的 Xcode 27 Release Notes 中,新增了一条已知缺陷(Issue 187057599):
“在运行 macOS Tahoe 26.6 的主机上,若启用了 Xcode 自动签名(Automatic Signing),包含 Hardware-Checked Pointer Arithmetic Slice 特性的应用将 无法成功上传至 App Store 。”
官方规避方案:
- 方案 A:将 CI/CD 或打包宿主机升级至 macOS 27 正式版;
- 方案 B:在 Xcode 中关闭“Automatically manage signing”,改用手动配置 Provisioning Profile 与证书签名导出。
7. 总结与工程展望
从 2018 年 A12 芯片开创性的 指针认证码(PAC)终结控制流劫持,到 2025 年 A19 芯片基于 增强型内存标记(EMTE)封堵空间与时间内存漏洞,再到 2026 年 A20 芯片通过 校验指针算术(CPA2 / arm64e.x1)封死标签算术溢出绕过通道——Apple 在 Apple Silicon 硬件防御纵深(Defense in Depth)上的布局展现出令人叹为观止的微架构工程水准。
对于一线 iOS/macOS 资深开发者与架构师而言,尽早将主工程适配为 arm64 arm64e arm64e.x1 三切片架构,并在开发分支上拉通四级联动门禁进行全量压测,不仅能够提前消灭潜在的指针越界未定义行为,更为新一代 iPhone 18 Pro 与 M6 Mac 设备的用户构筑起坚不可摧的底层安全护城河。
原文链接与参考资料
- 原文链接:arm64e.x1: Apple's Checked Pointer Arithmetic Slice - Blake Crosley
- Apple 官方发行说明:iOS & iPadOS 27 RC Release Notes (Hardware Security)
- Apple 官方开发指南:Enabling enhanced security for your app - Apple Developer
- Apple 安全工程团队:Memory Integrity Enforcement: A complete vision for memory safety in Apple devices
- Arm 官方架构规范:Feature names in A-profile architecture (FEAT_CPA & FEAT_CPA2)
- LLVM 编译器开源提交:llvm-project PR #73777: Assembly support for Checked Pointer Arithmetic Extension